
1. 痛点突围:它究竟击穿了什么工程死穴?
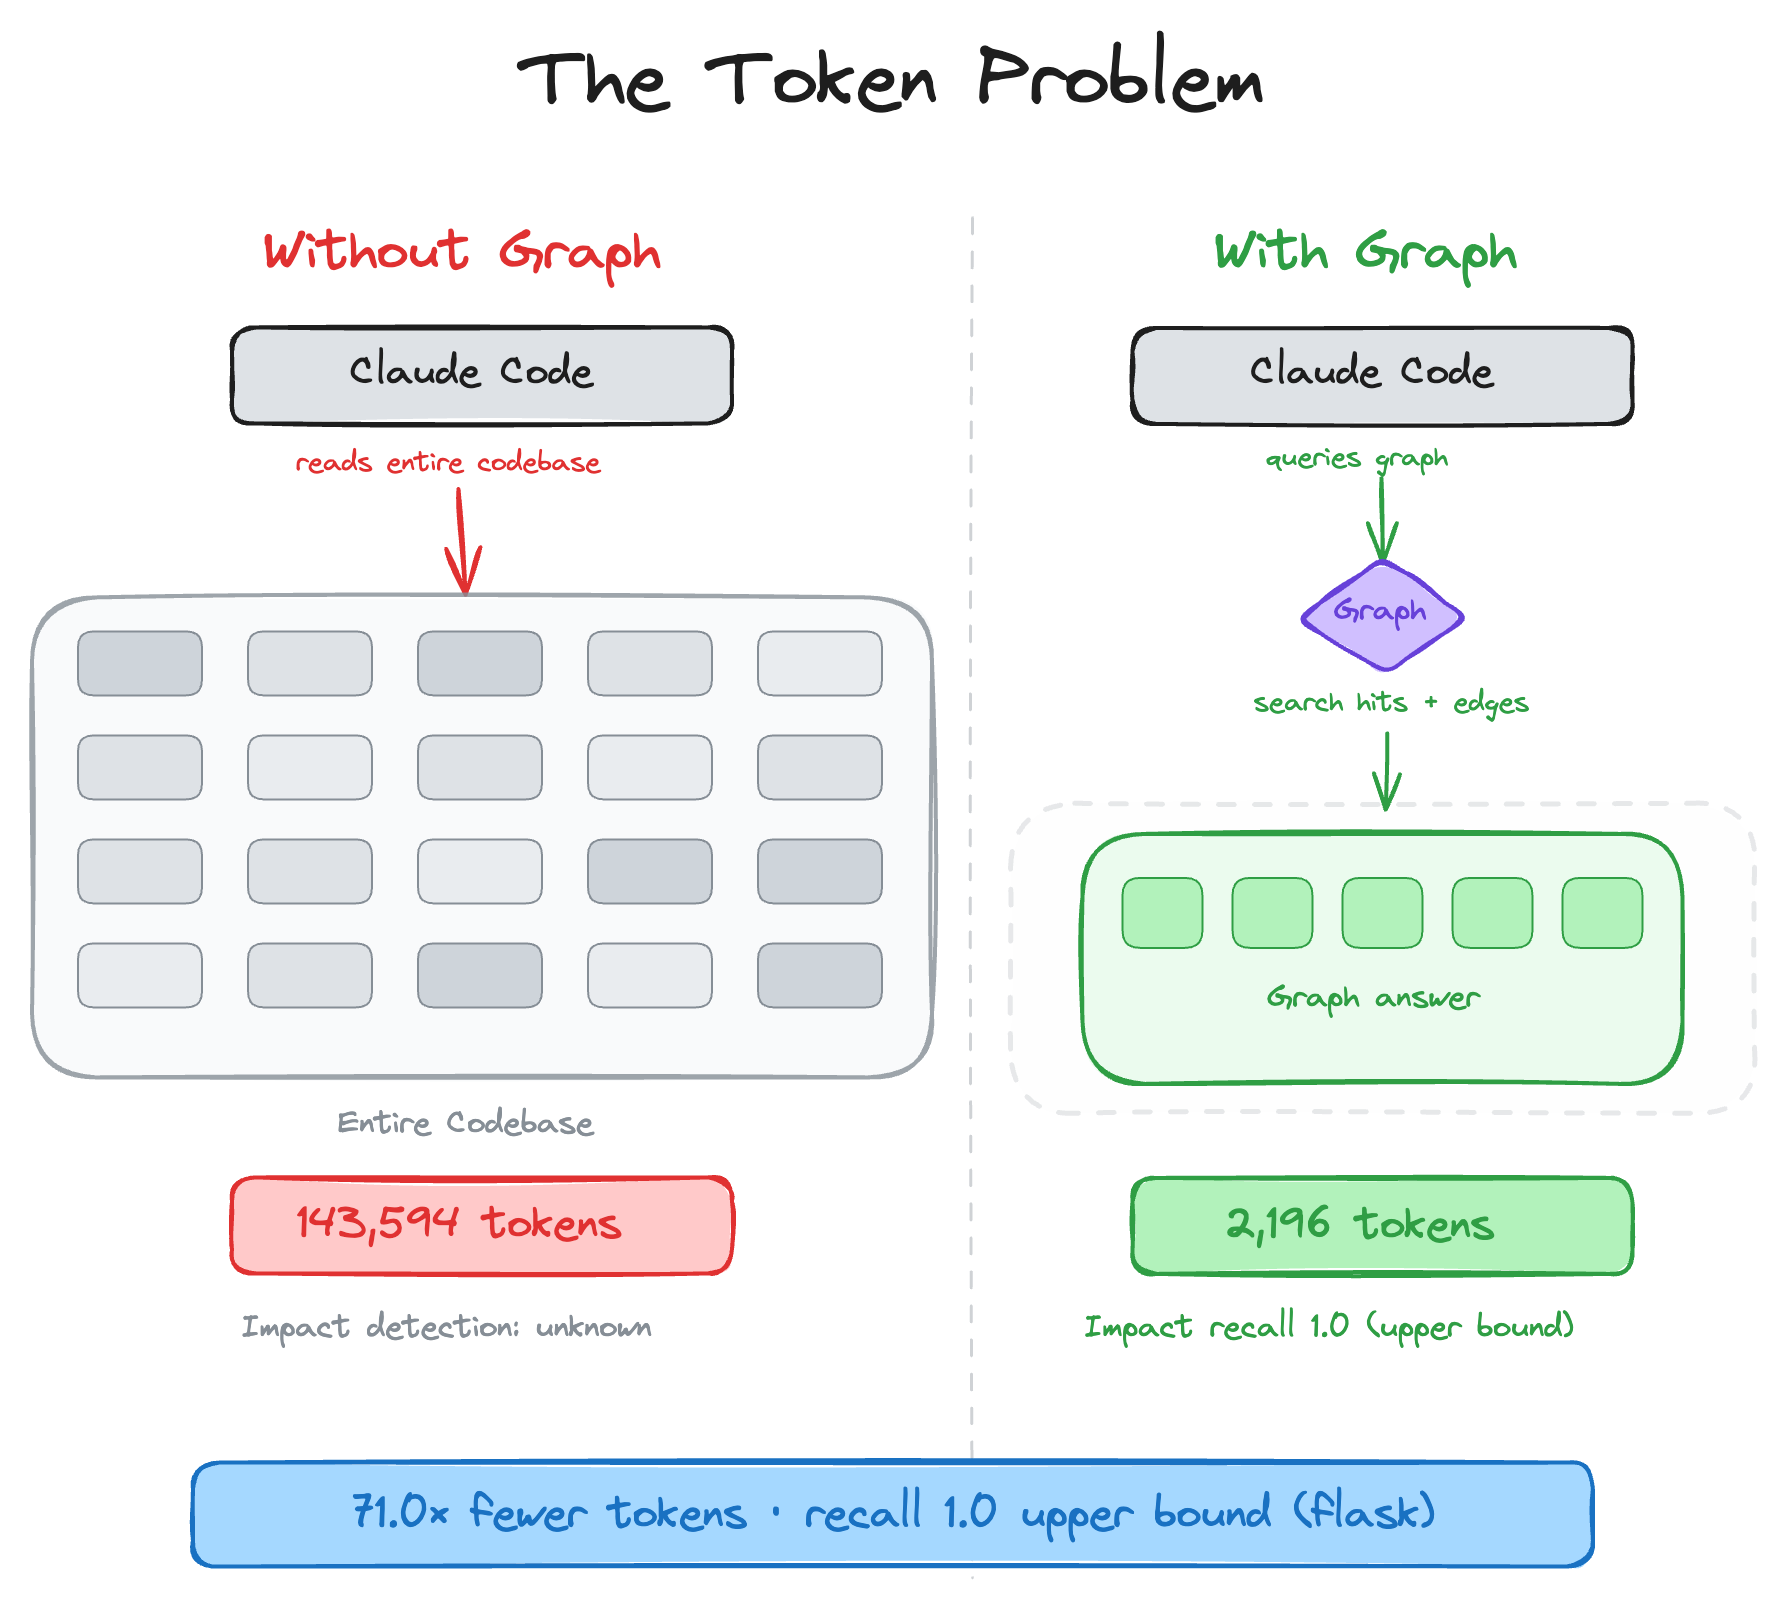
当前主流的 AI 编码助手在面对中大型代码库进行 Code Review 时,普遍面临灾难性的 Token 开销。每当开发者提交一处微小改动,AI 工具往往会重复读取数万甚至数十万行的整个代码库语料。这种无差别的全局扫描不仅导致推理延迟陡增,更直接拉高了云端 API 的调用账单。code-review-graph 通过在本地建立结构化代码知识图谱,强制 AI 助手只读取受变更影响的最小代码切片。
💡 架构核心洞见:通过将非结构化的文本语料转换为基于 Tree-sitter 的本地关系图谱,该项目把代码库的全量全局检索降维成了基于调用边界的局部图谱遍历。
2. 核心架构与底层数据流转解析
code-review-graph 的核心运行时依赖本地 SQLite 存储解析后的抽象语法树与代码实体关系。整个流水线从代码库的静态解析开始,利用 Tree-sitter 提取函数、类与导入声明,随后将这些符号关系持久化为图谱节点与边。当开发者触发审查指令时,MCP 服务端会根据变更的文件路径计算影响半径(Blast Radius),动态检索出直接调用者、依赖项以及关联测试,最终输出最小化的高精度上下文。
[ Codebase / Git ] ---> [ Tree-sitter Parser ] ---> [ SQLite Graph Store ]
                                                              │
                                                              ▼
[ AI Assistant (MCP) ] <--- [ Minimal Review Set ] <--- [ Blast Radius Engine ]
影响半径分析模块是整个架构的精髓。当某一个底层函数发生 SHA-256 哈希变动时,图谱通过反向追踪调用边(Call Edges)与导入边(Import Edges),精准定位所有潜在受影响的下游模块。增量更新机制仅对哈希改变的文件触发重新解析,在含有三千个文件的测试项目中,单次增量重索引耗时被压缩至 2.5 秒以内。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (code-review-graph) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 上下文获取方式 | 本地 Tree-sitter 图谱 + MCP | 全量文件读取 / RAG 向量检索 | 远程大模型服务全库索引 | 单次审查 Token 降幅达 65 倍 |
| 更新触发机制 | Git 钩子 / 增量哈希比对 | 每次强行重新构建索引 | 定时全量向量化嵌入 | 增量更新延迟低至 2.5 秒 |
| 隐私与合规性 | 100% 本地 SQLite 存储 | 代码隐私暴露给第三方向量库 | 云端持久化存储源码片段 | 杜绝企业内部源码外泄风险 |
| 编辑器生态兼容 | 一键原生支持主流 16 款 AI 工具 | 仅绑定单一特定编辑器插件 | 需要复杂的独立客户端配置 | 零学习成本无缝接入现有工作流 |
多维度数据对比表明,本地图谱路由在 Token 消耗和隐私安全上具备压倒性优势。传统基于向量嵌入的 RAG 方案容易丢失精确的语法调用关系,而基于 Tree-sitter 的符号级图谱能够完美保留函数调用栈与类继承拓扑。
4. 手把手极客实操:从零构建最小闭环
在本地开发环境中配置 code-review-graph 需要 Python 3.10 及以上版本。通过包管理器完成安装后,利用其自动探测能力将 MCP 服务写入编辑器的配置文件。
# 通过 pip 安装命令行工具
pip install code-review-graph

# 自动检测本地已安装的 AI 编码工具并写入 MCP 配置
code-review-graph install --platform cursor

# 对当前代码库执行全量静态解析与图谱构建
code-review-graph build
安装完成后,在 Cursor 或 Claude Code 中打开该项目,直接发送指令即可调用图谱上下文:
Build the code review graph for this project
工具执行完毕后,CLI 会在终端输出构建状态统计。若部分文件解析失败,系统会将其标记为 partial 状态并在标准错误流中打印警告,历史图谱行数据保持不变以确保稳定性。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
大规模多语言混合仓库在初次冷启动时会消耗较多 CPU 资源。由于 Tree-sitter 需要对每一个源文件执行词法与语法分析,三千个文件的冷构建通常需要约 40 秒的单线程处理时间。
⚠️ 避坑预警 [冷启动耗时过长]:在包含数万个文件的巨型单体仓库(Monorepo)中执行首次
build时,切勿在 CI 流水线或低配虚拟机上直接运行,建议在本地开发机预先生成 SQLite 数据库并纳入.gitignore或通过共享缓存挂载。⚠️ 避坑预警 [增量同步失效]:若开发者频繁通过外部脚本批量修改文件权限或重命名大量目录,Git 钩子可能无法正确捕获文件状态的 SHA-256 变更。此时必须手动执行
code-review-graph build --force刷新底层图谱。
持续集成环境中的自动化卸载与清理同样需要谨慎处理。使用 code-review-graph uninstall --keep-data 参数可以在移除编辑器集成钩子的同时,完整保留精心构建的图谱数据库,避免重复构建带来的时间损耗。