
1. 痛点突围:它究竟击穿了什么工程死穴?
本地大模型开发者长期陷于碎片化的工具链泥潭。运行一个文本对话需要 Ollama 或 LM Studio,处理图像和视频生成则必须手动配置 ComfyUI、下载各类 Checkpoint、安装特定版本的 PyTorch 并解决 CUDA 冲突。这种复杂的异构依赖导致环境崩溃率极高,阻碍了普通极客和创作者的实际效率。locally-uncensored 砍掉了所有非必要的中间层,通过单一 Electron 桌面端原生内嵌模型管理、推理引擎驱动与多模态生成流水线,直接抹平了本地 AI 的配置鸿沟。
💡 架构核心洞见:通过桌面端直接托管底层推理引擎与跨进程通信,将原本需要数十个配置文件的分布式 AI 工具链压缩为单一二进制分发包。
2. 核心架构与底层数据流向解析
该项目采用主进程与渲染进程分离的 Electron 架构,同时通过嵌入式运行时动态调用本地推理后端。当用户在聊天界面触发多模态生成时,前端状态机将解析提示词,并将文本任务分发给本地 LLM 引擎,将图像或视频任务路由至内嵌的 ComfyUI 实例。应用内部维护统一的上下文路由表,确保聊天记录、LoRA 权重路径和代理执行计划在不同标签页之间无缝同步。
[ Desktop UI / Tabs ] ---> [ IPC Router / Main Process ] ---> [ Memory & Context Manager ]
                                        │
         ┌──────────────────────────────┴──────────────────────────────┐
         ▼                                                             ▼
[ Local LLM Engine (Ollama/LM Studio) ]               [ ComfyUI Embedded Backend ]
         │                                                             │
         ▼                                                             ▼
   [ Text Generation ]                                        [ Image / Video Generation ]
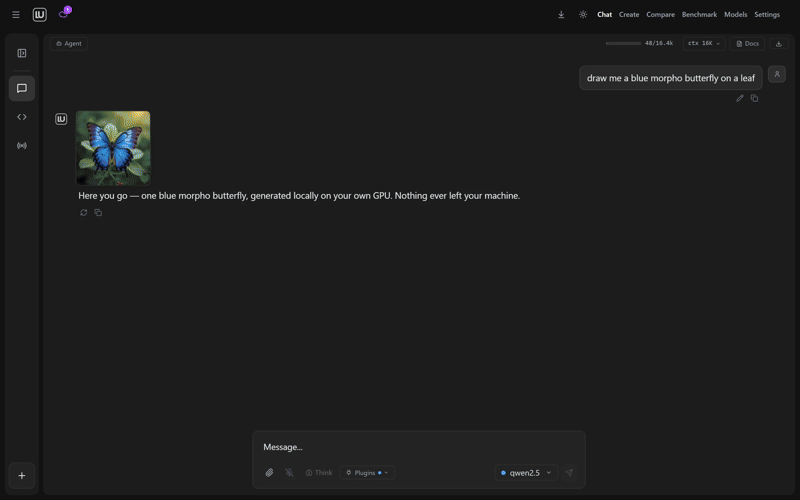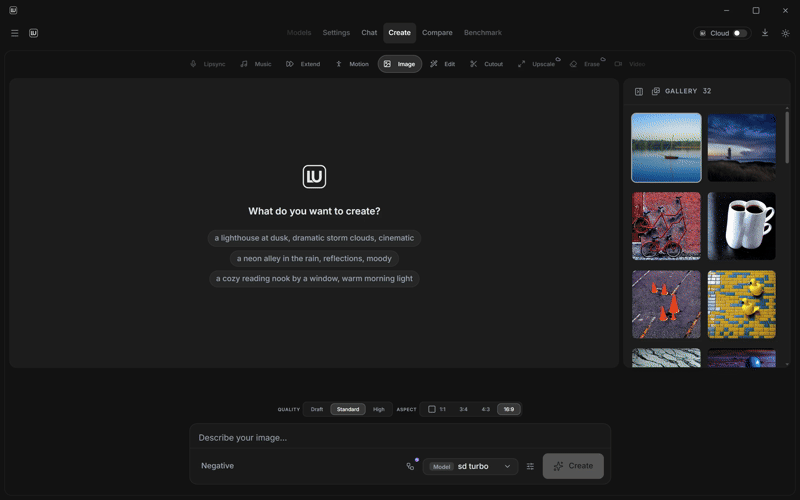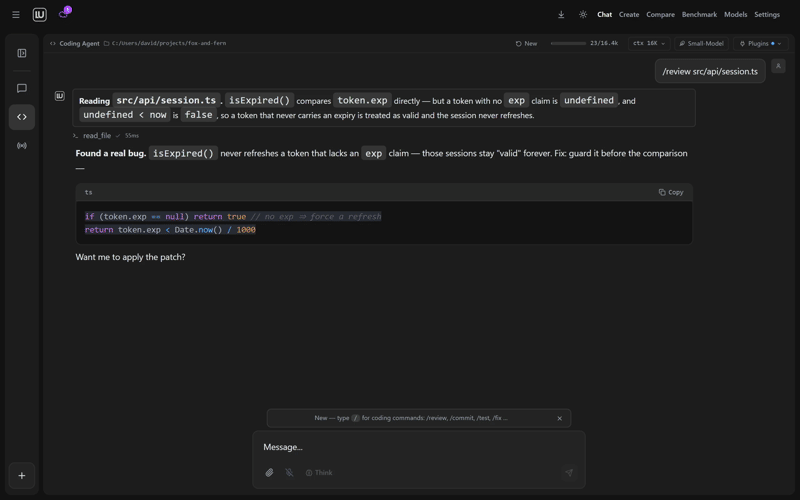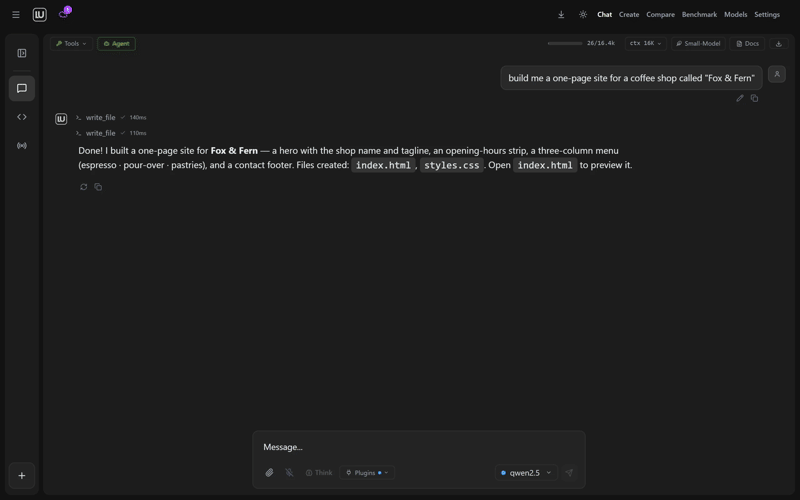
在代码代理(Coding Agent)模式中,系统引入了修改审查机制。代理在修改文件前强制输出 Diff 视图,开发者能够逐行确认变更并选择拒绝或应用,有效防止了自主代理失控导致的本地代码库污染。
3. 技术选型与性能横热对比
| 选型维度 | 本方案 (locally-uncensored) | 传统实现范式 (ComfyUI + Ollama) | 典型云端闭源竞品 (ChatGPT/Claude) | 生产环境收益 |
|---|---|---|---|---|
| 部署复杂度 | 零配置,一键安装包 | 需手动配置 Python 虚拟环境与依赖 | 依赖稳定网络连接与 API Key | 节省 90% 以上的初始环境搭建时间 |
| 硬件资源复用 | 智能链接已有模型文件,拒绝重复占用 | 各工具各自孤立存放模型权重 | 数据全部交由云端处理,无法审计 | 节省数百 GB 本地硬盘空间与显存开销 |
| 隐私与安全性 | 100% 本地离线运行,无数据外泄 | 离线运行,但需开发者自行打通各组件 | 商业机密与敏感代码存在合规风险 | 满足金融与企业级严格的数据隐私合规 |
| 多模态协同 | 聊天、文生图、代码代理同窗口共享上下文 | 多个独立 WebUI 切换,跨窗口传参繁琐 | 多模态能力受限且产生高额按量计费 | 提升全栈开发与创意设计的连贯效率 |
| 二次开发扩展 | 开源仓库,支持标准 API 接入与 LoRA 管理 | 模块化程度高但整合调试成本极高 | 闭源黑盒,无法进行深度的架构定制 | 赋予极客团队完全的系统掌控权与定制空间 |
这套技术选型彻底放弃了将繁琐配置推给开发者的偷懒做法。通过直接接管运行时环境和硬编码路径映射,它在保障本地隐私安全的前提下,压榨出了消费级显卡的极限吞吐能力。
4. 手把手极客实操:从零构建最小闭环
开发者可以直接从 GitHub Releases 页面下载对应操作系统的安装包,或者通过源码仓库进行本地开发构建。以下是在 Linux 或 macOS 本地环境中通过源码启动开发模式的极客命令行操作流:
# 克隆官方代码仓库到本地工作目录
git clone https://github.com/PurpleDoubleD/locally-uncensored.git

# 进入项目根目录
cd locally-uncensored

# 安装前端与主进程依赖包
npm install

# 启动浏览器端开发模式与热重载
npm run dev
在应用首次启动向导中,应用会自动扫描系统中运行的 Ollama 或 LM Studio 实例。若未检测到任何引擎,点击一键安装即可自动完成底层运行时的部署,随后即可在 Chat 与 Create 标签页中直接加载本地模型并执行生成任务。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在实际部署和日常运行过程中,由于涉及大量本地异构硬件调用,部分边界条件可能触发未预期的异常状况。
⚠️ 避坑预警 [杀毒软件误报]:Windows 平台的 NSIS 安装程序由于未内置高额商业数字签名,可能被部分杀毒软件误报为风险程序。这是由于公共开源 CI 自动构建触发的误报,开发者可以通过对比 GitHub 官方仓库的 minisign 公钥进行完整性校验。
⚠️ 避坑预警 [显存溢出与多图处理]:当在聊天或代码代理中连续输入大量高分辨率图像时,若未合理限制模型的上下文窗口与并发任务数,极易导致本地 GPU 显存耗尽。建议在版本更新后通过参数配置限制单次会话的上下文长度,并在处理复杂视频生成时保持后台单任务队列运行。