1. 痛点突围:它究竟击穿了什么工程死穴?
AI 计算架构演进引发了底层算子研发的严峻分化。大模型推理吞吐极度依赖特化算子,例如 DeepSeek V3.2 的稀疏 MLA 算子、Block-causal Attention 以及各类低比特量化 GEMM。在常规研发流水线中,算法团队通常面临两难抉择:
纯手写 CUDA C++ 或 CUTLASS 虽能榨干 SM 资源,但代码充斥着手动的寄存器分配、共享内存 Swizzle 索引计算与双缓冲同步原语。工程逻辑极难维护,且只要硬件跨代换代(如从 Hopper 转向 Blackwell SM120,或是跨架构迁移至 AMD ROCm 和华为昇腾 950),全套代码就必须重写。直接采用 Triton 等高层 DSL 虽能大幅降低编写难度,但在复杂非规则访存、深度定制流水线(如 TMA Gather/Scatter、Cluster Copy)以及非 NVIDIA 硬件后端调度上,仍存在表达力受限或指令下发不可控的问题。
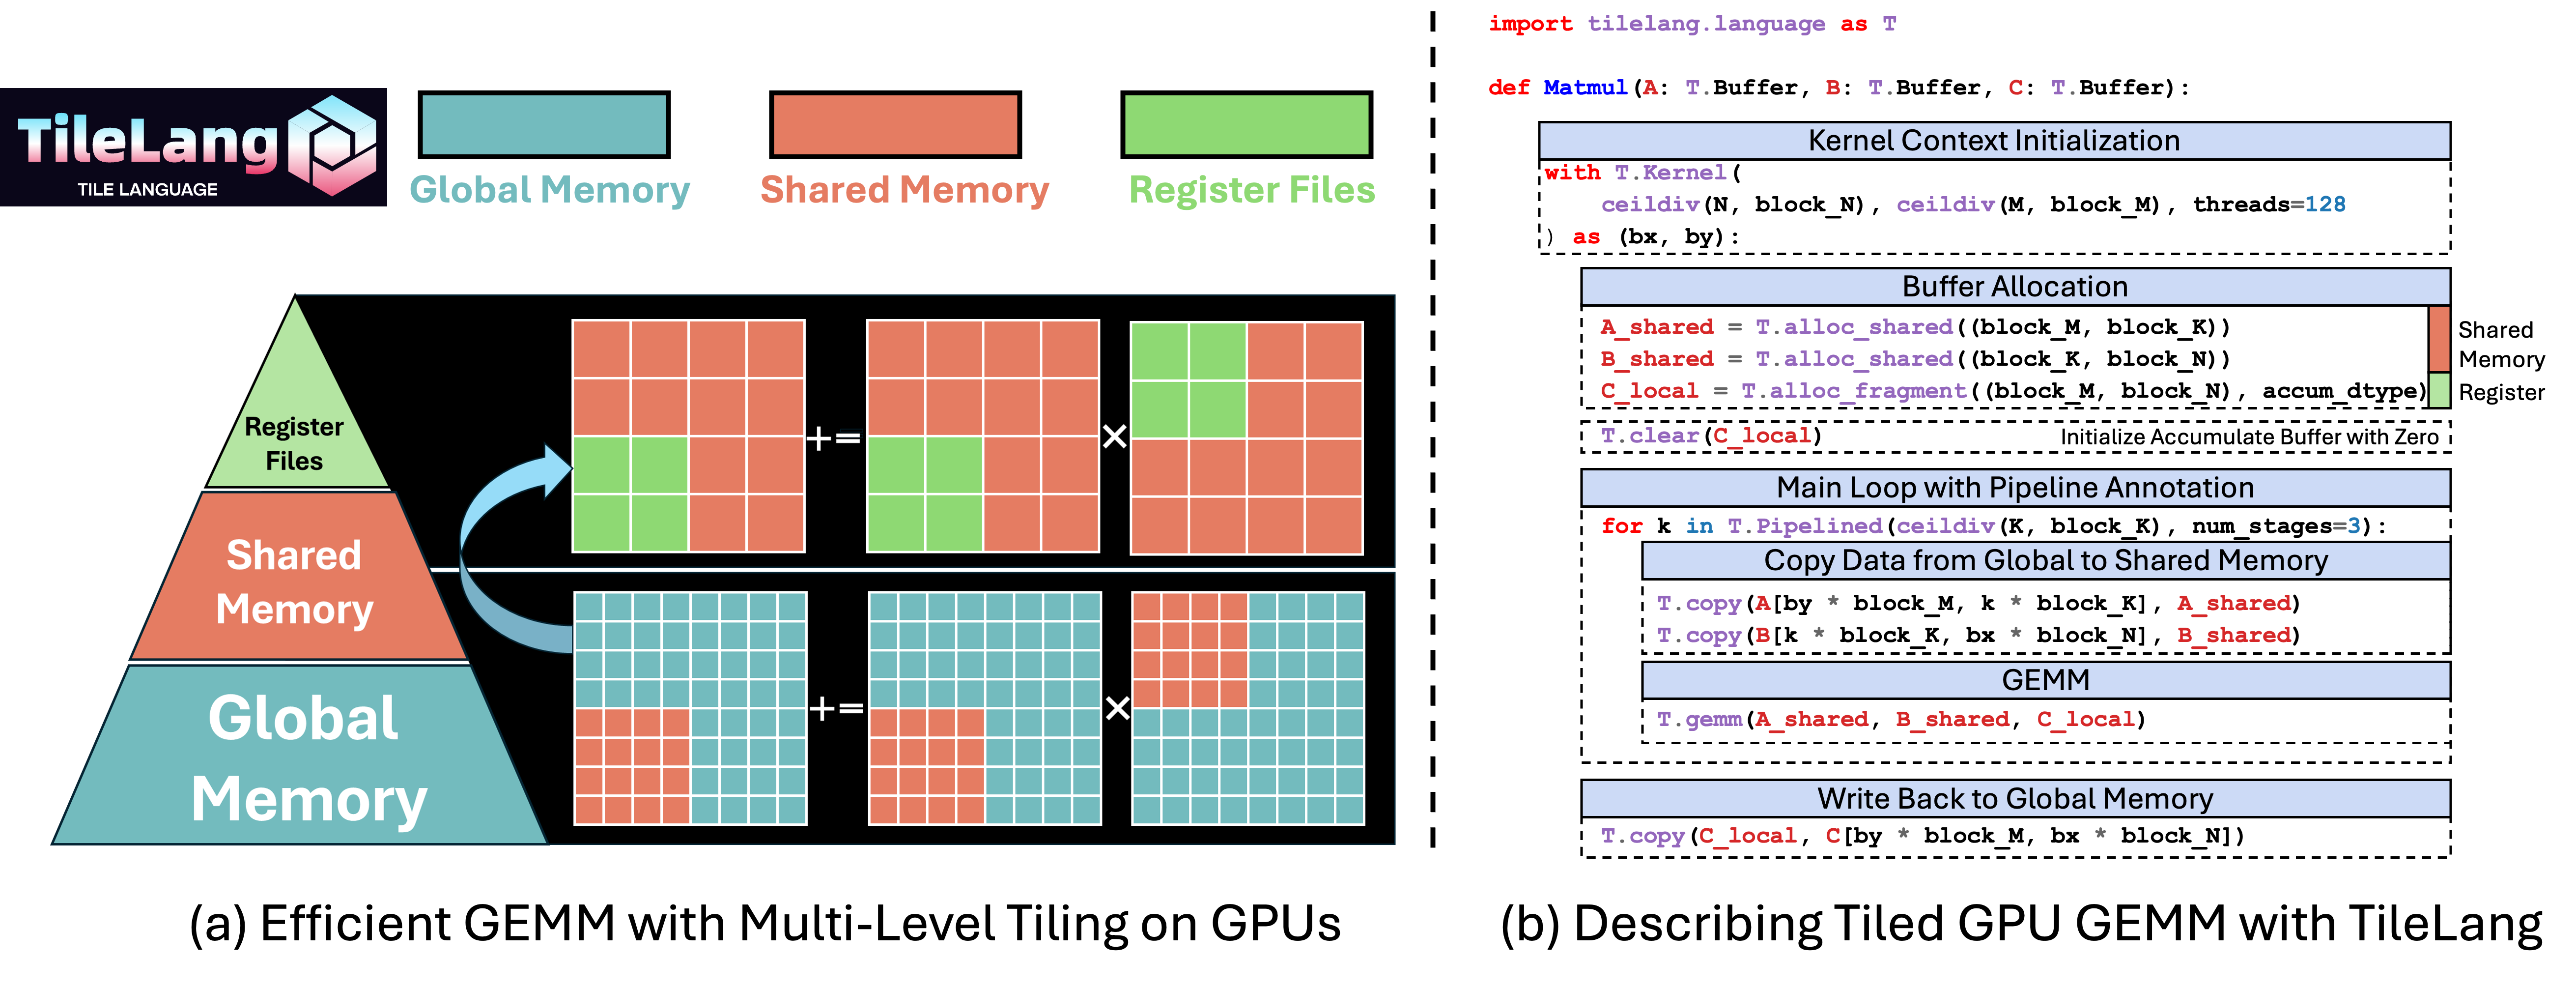
TileLang 击中了手写算子开发中的高门槛与跨平台断层。它依托 Apache TVM TIRX 编译器基础设施,建立了一套以分块计算(Tile-level Programming)为第一等公民的抽象规范。开发者无须手动操纵 Thread 维度的标量访存,而是直接声明 Tile 的形状、布局与流转阶段。编译器底层自动处理软流水编排、Tensor Core/MMA 矩阵指令映射、异步内存拷贝以及多后端代码生成。
💡 架构核心洞见:通过将线程级标量控制降维为分块级张量流转,TileLang 在 Python AST 与硬件原生 MMA/TMA 之间构筑了确定性的降级通路,实现一份逻辑定义跨 NVIDIA、AMD、Metal 与昇腾硬件的原生交付。
2. 核心架构与底层数据流向解析
TileLang 采用分层解耦的编译器设计。最上层是面向开发者的 Pythonic DSL 语法层,中间层构建于 TVM 的 TIRX(Tensor IR Extended)之上,底层衔接多后端硬件 CodeGen 与自适应调度器。
[ Python DSL Kernel (T.prim_func) ]
                   │ (Parse AST & Inlay Layouts)
                   ▼
[ TIRX Multi-Backend Dialect IR ]
                   │
     ┌─────────────┴─────────────┐
     ▼                           ▼
[ Tile Scheduler ]       [ Layout & Swizzle Trans ]
(Pipeline / Auto-Sync)   (TMA Lowering / Bank Conflict)
     │                           │
     └─────────────┬─────────────┘
                   ▼
[ IR Lower Trace & Pass Optimization ]
(Scan / MMA Lowering / Cluster Trans)
                   │
                   ▼
[ Backend CodeGen Dispatch Registry ]
   ├── CUDA (SM75-SM120 NVF4 / TMA)
   ├── ROCm (CDNA3/CDNA4 MXFP4)
   ├── Metal (M5 Cooperative Tensor / Simdgroup)
   ├── Ascend (950 SIMD/SIMT Vector & Matrix)
   └── LLVM (x86 / ARM CPU Fallback)
TileLang 编译管线由以下核心模块协同构成:
- 前端方言系统与 LSP 分析器:通过 Python 装饰器捕获计算拓扑,并结合 TileLang LSP 在源码层面推断张量 Buffer 形状、数据类型、作用域与内存布局,提供静态编译期的诊断回溯。
- TIRX 调度与变换管线:将分块拷贝
T.copy与矩阵乘累加T.gemm翻译为带依赖关系的硬件抽象语法树。在此阶段,编译器会自动推导 Shared Memory 的 Swizzle 布局以规避 Bank 冲突,并将连续多级循环展开为硬件异步拷贝流水线。 - 后端代码生成注册表(Backend CodeGen Registry):解耦设备端与主机端的运行时调度。同一个 TIRX 表示通过后端的特化 Lowering Pass,分别映射为 NVVM/PTX 内联指令(针对 NVIDIA SM75-SM120)、HIP 内核(针对 AMD gfx950)、Metal Shading Language(针对 Apple Silicon)以及昇腾专用指令集。
在工程权衡方面,TileLang 放弃了高层抽象对底层细节的绝对黑盒封装。它允许开发者通过 T.mma_gemm_blockscaled 或 T.copy_cluster 显式介入微架构特性,虽然要求算子作者理解硬件级拓扑,但避免了黑盒自动调度器在极端算子场景下的性能滑坡。
3. 技术选型与性能横向硬核对比
| 选型维度 | TileLang | 手写 CUDA C++ / CUTLASS | OpenAI Triton | 传统 TVM TensorIR | 生产环境收益 |
|---|---|---|---|---|---|
| 抽象颗粒度 | Tile 级宏原语表达 | Thread / Warp 级标量显式管理 | Block / Program 级隐式调度 | Loop Nest 标量循环嵌套 | 代码量减少 70%,消除标量索引错误 |
| 微架构指令介入 | 显式支持 TMA/Cluster/NVF4 | 汇编级精准受控 | 依赖编译器中间层黑盒生成 | 依赖 Polyhedral/Schedule 原语 | 兼顾极值硬件吞吐与手控深度定制 |
| 异构硬件泛化 | CUDA / ROCm / Metal / 昇腾 / LLVM | 局限在 NVIDIA 生态为主 | 主要深耕 NVIDIA,其他后端适配滞后 | 广义支持但深度 MMA 优化成本高 | 算法流水线仅需维护一套 DSL 资产 |
| 编译调试能力 | IR Lower Trace / Pass Diff / LSP | GDB / Compute Sanitizer | 需转译分析 Triton IR / PTX | TVM 内部可视化 Pass 链 | 精确定位 Pass 变换前后的语义漂移 |
TileLang 的选型优势在于没有重造前端执行引擎,而是彻底重构了 TVM 的编译流水线。相较于 Triton 将编译策略深度压入 LLVM MLIR 路径,TileLang 依托 TIRX 保持了极高的调试透明度,开发者可以在 Pass 变换的任意截面直接核对共享内存占用与循环展开结构。
4. 手把手极客实操:从零构建最小闭环
本节演示基于 TileLang 构建一个带异步流水调度与共享内存规整化布局的高性能 FP16 GEMM 算子。所有执行逻辑保持原生闭环。
环境安装与验证
# 基础依赖安装 (要求 Python >= 3.10, CUDA Toolkit >= 12.0)
pip install torch tilelang

# 验证底层编译器与后端硬件兼容性
python -c "import tilelang; print(tilelang.__version__)"
最小生产算子构建
保存以下代码至 gemm_tilelang_demo.py:
import torch
import tilelang
import tilelang.language as T

# 定义分块超参数
M, N, K = 1024, 1024, 1024
BLOCK_M, BLOCK_N, BLOCK_K = 128, 128, 32

@T.prim_func
def matmul_kernel(
    # 定义输入张量全局内存指针,类型声明为 float16
    A: T.Buffer((M, K), "float16"),
    B: T.Buffer((K, N), "float16"),
    # 定义输出张量全局内存指针,存储矩阵乘结果
    C: T.Buffer((M, N), "float16"),
):
    # 绑定计算网格维度,声明 GPU 线程块的组织拓扑
    with T.Kernel(T.ceildiv(N, BLOCK_N), T.ceildiv(M, BLOCK_M), threads=128) as (bx, by):
        # 声明共享内存分块缓冲区,用于承载循环迭代中的切片数据
        A_shared = T.alloc_shared((BLOCK_M, BLOCK_K), "float16")
        B_shared = T.alloc_shared((BLOCK_K, BLOCK_N), "float16")
        # 声明寄存器累加局部缓冲区,使用 float32 保证累加数值精度
        C_local = T.alloc_fragment((BLOCK_M, BLOCK_N), "float32")

        # 初始化寄存器累加器全零状态
        T.clear(C_local)

        # 遍历 K 维度并启用两级软件流水展开
        for k in T.Pipelined(T.ceildiv(K, BLOCK_K), num_stages=2):
            # 将全局内存分块载入共享内存,触发硬件异步拷贝
            T.copy(A[by * BLOCK_M : (by + 1) * BLOCK_M, k * BLOCK_K : (k + 1) * BLOCK_K], A_shared)
            T.copy(B[k * BLOCK_K : (k + 1) * BLOCK_K, bx * BLOCK_N : (bx + 1) * BLOCK_N], B_shared)
            # 调用微架构 Tensor Core MMA 指令执行分块矩阵乘
            T.gemm(A_shared, B_shared, C_local)

        # 将累加结果格式化写回全局内存目标地址
        T.copy(C_local, C[by * BLOCK_M : (by + 1) * BLOCK_M, bx * BLOCK_N : (bx + 1) * BLOCK_N])

# 编译当前 TileLang 算子并绑定目标硬件架构
compiled_kernel = tilelang.compile(matmul_kernel, target="cuda")

# 构建真实输入张量进行数值验证
a = torch.randn(M, K, dtype=torch.float16, device="cuda")
b = torch.randn(K, N, dtype=torch.float16, device="cuda")
c = torch.empty(M, N, dtype=torch.float16, device="cuda")

# 算子启动执行
compiled_kernel(a, b, c)

# 验证数值正确性
torch_ref = torch.matmul(a, b)
max_err = torch.max(torch.abs(c - torch_ref)).item()
print(f"Execution success. Max absolute difference: {max_err:.4e}")
算子运行与预期输出
python gemm_tilelang_demo.py
控制台预期输出:
Execution success. Max absolute difference: 9.7656e-04
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在将 TileLang 算子推向实际推理或训练集群前,需要防御底层生成的特化硬件陷阱:
共享内存 Swizzle 与 TMA 降级失配
在 NVIDIA Hopper 与 Blackwell 架构中,启用 TMA(Tensor Memory Accelerator)要求共享内存的步长对齐与 Swizzle 模式严格满足硬件边界。若在 T.alloc_shared 时没有为分块形状设置 128 字节对齐,或在循环中使用了跨步不连续的非规则切片,编译期的 TMA Lowering 会自动静默退化为传统的标量 ldmatrix 组合指令,导致内存带宽利用率腰斩。
⚠️ 避坑预警 [TMA 静默退化]:在 Hopper/Blackwell 上使用 TMA 时,务必通过
tilelang.tools.ir_lower_trace检查中间 IR 是否实际生成了tile::tma_load节点;确认 Tile 列宽步长为 128 字节的整数倍,避免触发通用软拷贝回退。
多级流水线(Pipelined)阶段数与共享内存溢出
TileLang 允许在 T.Pipelined 中设置 num_stages 参数以实现寄存器与共享内存的双缓冲或多缓冲重叠。但共享内存占用量会与 num_stages 成线性正比增长。如果将 num_stages 盲目调大至 4 或 5,极易超出单个 SM 物理共享内存上限(如 Hopper 架构单 SM 动态分配上限),导致 CUDA 报出 out of resources 错误,或引发可调度线程块数下降,进而劣化硬件占用率(Occupancy)。
⚠️ 避坑预警 [共享内存配置超限]:设置
num_stages > 2时,必须结合目标显卡的共享内存规格严格核算num_stages * (sizeof(A_tile) + sizeof(B_tile));上线前应开启 pass profiling 查看资源开销,必要时通过tilelang.autotune自动化探索阶段数与 Tile 尺寸的最优平衡点。