
1. 痛点突围:它究竟击穿了什么工程死穴?
在使用 Claude Code、Cursor 或者 GitHub Copilot CLI 处理复杂软件工程时,开发者每天都在重复相同的机械劳动。每当开启一个新的终端会话,底层大模型就会瞬间格式化所有历史上下文。项目架构规范、特定模块的脏逻辑规避方案、刚刚修复的隐蔽 Bug 细节,全部随着旧会话的销毁而烟消云散。这种频繁的重新解释过程不仅吞噬宝贵的 Token 额度,更严重拖慢开发迭代速度。
行业此前尝试通过简单的 Markdown 文件存储或基础向量数据库来保存历史对话,但这些方案缺乏动态生命周期管理与结构化知识关联。rohitg00 开源的 agentmemory 直接将 Andrej Karpathy 的 LLM Wiki 模式落地为可执行的工程标准。它通过置信度评分、知识图谱与混合检索策略,让编码代理具备了真正的持久化记忆能力,从而确保代理在跨会话时能够直接调取之前的代码决策历史。
💡 架构核心洞见:agentmemory 并没有把记忆当作简单的文本检索,而是构建了一个具备生命周期管理与知识图谱的自主记忆蒸馏系统,通过状态机确保代理在不同会话间维持状态一致性。
2. 核心架构与底层数据流向解析
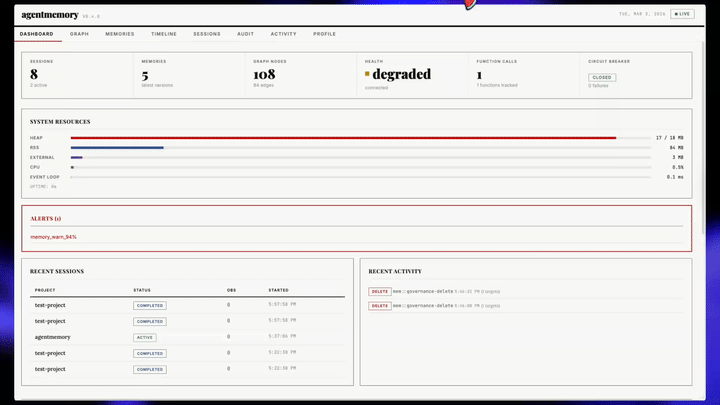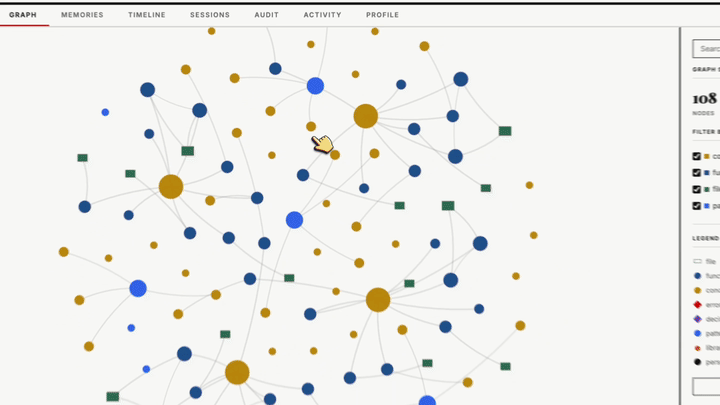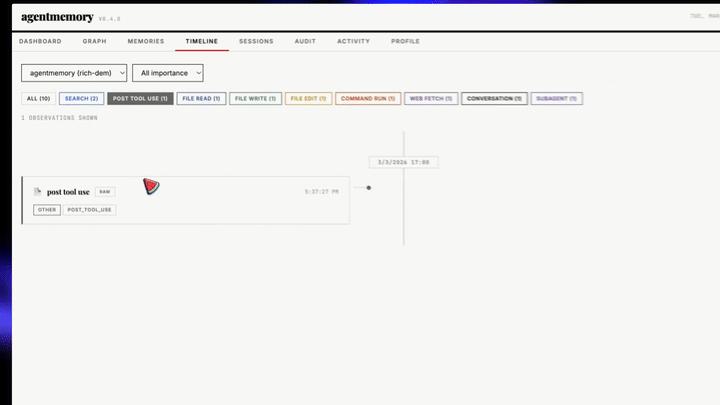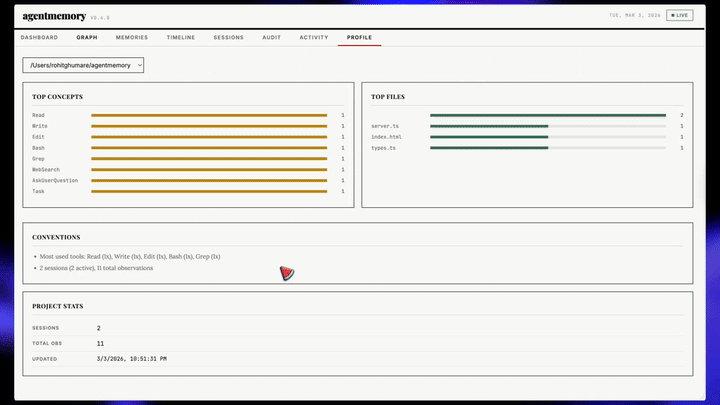
agentmemory 的底层架构基于高性能的 iii 引擎构建。系统采用客户端与嵌入式守护进程分离的拓扑设计,通过本地四个专用端口协同处理协议转换、状态持久化和实时视图渲染。整个运行时的内存状态被严格映射到本地数据目录,完全摆脱了对外部独立数据库服务的强依赖。
[ MCP Client / Cursor ] ---> [ Gateway / Port 3111 ] ---> [ Memory Layer & iii Engine ]
                                        │
                                        ▼
                            [ Hybrid Search Router ]
                        (BM25 Lexical + Vector + Graph)
                                        │
                                        ▼
                            [ Local State Store / Disk ]
在数据流转层面,代理通过安装的 54 个 MCP(Model Context Protocol)工具与本地代理服务进行通信。当代理生成新的代码观察结果时,系统首先通过钩子函数捕获事件,并在启用自动压缩时触发 LLM 观察蒸馏。检索阶段则同时调度 BM25 词法匹配和图谱结构遍历,在保证高召回率的同时将上下文体积压缩达 92%。整个流水线在保证极低延迟的前提下,将原始文本转化为高密度的结构化知识节点。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (agentmemory) | 传统 Markdown 沉淀 | 传统向量检索 (Pinecone/Milvus) | 生产环境收益 |
|---|---|---|---|---|
| 外部依赖 | 零外部数据库,内置 iii 引擎 | 无依赖,仅纯文本 | 需要独立的云端/本地数据库 | 部署架构极简,运维成本归零 |
| 检索准确率 | 95.2% (R@5 混合检索) | 依赖人工查找,无保障 | 约 75%-85% (仅语义相似度) | 精准定位历史技术决策,杜绝幻觉 |
| Token 消耗 | 相对直接会话减少 92% | 无法量化,极易撑满上下文 | 视检索返回片段大小而定 | 大幅降低 API 调用账单开销 |
| 工具生态支持 | 原生对接 54 个 MCP 工具 | 无动态交互工具 | 需自行编写 API 封装胶水代码 | 开箱即用,无缝嵌入主流编码助手 |
agentmemory 的技术选型精准切中了开发者的痛点。通过内嵌 iii 引擎并摒弃沉重的外部数据库,它把原本需要复杂运维的分布式记忆系统精简为单机二进制运行态。混合检索策略彻底根除了传统纯向量搜索对精确技术术语和版本号检索失灵的顽疾。
4. 手把手极客实操:从零构建最小闭环
在开始之前,确保本地开发环境已正确安装 Node.js 20 或更新版本、npm 以及 npx。
执行以下经典全新安装命令,启动交互式配置引导:
npx -y @agentmemory/agentmemory@latest
初次运行将触发配置向导。此时选择需要关联的编码代理(如 Claude Code 或 Cursor),并指定 LLM 提供商或者选择免密钥模式(Keyless)。该过程会自动种子化配置文件,启动记忆服务器及其捆绑的 iii 引擎。随后通过以下两条核心命令注入测试数据并赋予代理记忆技能:
# 生成示例会话并验证记忆召回功能
npx -y @agentmemory/agentmemory@latest demo

# 为代理安装 17 个原生技能,使其实时感知记忆边界
nskills add rohitg00/agentmemory -y
在免密钥模式下,系统默认采用 BM25 算法进行关键词检索。若需启用零成本的本地语义召回,只需在 ~/.agentmemory/.env 文件中追加 EMBEDDING_PROVIDER=local 并重启服务。首次运行时会自动下载 Xenova/all-MiniLM-L6-v2 模型,后续推理完全在本地设备离线执行。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在生产环境大规模部署 agentmemory 时,由于底层涉及多端口协作与本地文件独占,必须注意规避特定的工程陷阱。
⚠️ 避坑预警 1(多实例数据目录污染):默认状态下 iii 引擎将状态持久化于平台特定的用户数据目录中。若在多终端并发启动时未显式通过
--data-dir <path>或AGENTMEMORY_DATA_DIR统一数据路径,极易导致多个守护进程抢占 SQLite/iii 状态锁,引发数据库损坏。⚠️ 避坑预警 2(无密钥模式功能受限):默认免密钥模式下向量嵌入功能处于关闭状态,
memory_smart_search无法进行深度的图谱结构匹配。若需获得完整的 95.2% 检索召回表现,必须显式配置本地嵌入提供商或接入外部 LLM 凭证,并确保AGENTMEMORY_AUTO_COMPRESS=true环境变量正确生效。