
1. 痛点突围:它究竟击穿了什么工程死穴?
主流搜索引擎的抓取逻辑长期绑定在传统网页索引与权威媒体权重上。当开发者试图获取某项底层技术、开源人物或商业实体的真实实时动态时,Google 索引返回的多是过期数月的陈旧博客、官方公关通稿或 SEO 垃圾页面。真正的实时技术讨论、一线开发者的尖锐批评、产品真实缺陷的排查日志全部分散在 Reddit 评论区、X 平台发帖、YouTube 视频转录文本以及 GitHub 提交历史中。这些平台构成了一座座互不相通的围墙花园,各自具备独立的鉴权机制与速率限制。
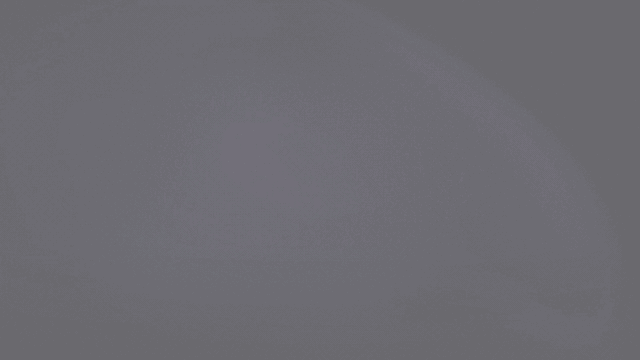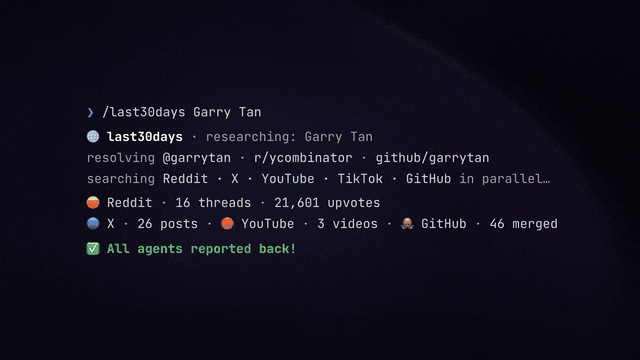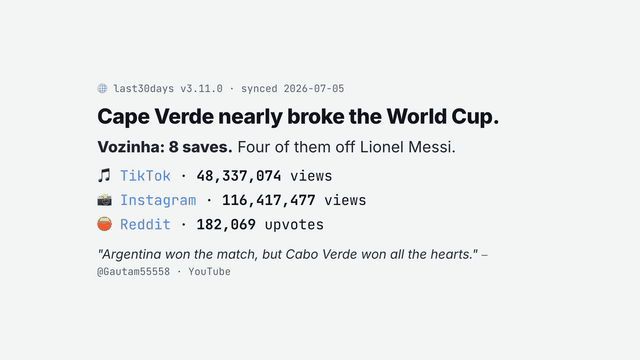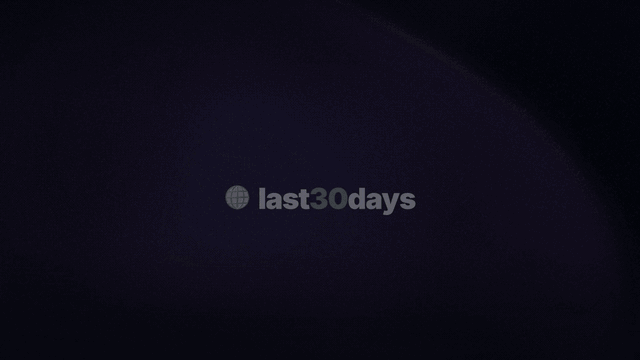
mvanhorn/last30days-skill 放弃了传统的中心化爬虫抓取架构。它将 AI 代理直接下沉至用户本地终端,调用用户现有的浏览器会话与自有 API 密钥,在单次指令触发时同时调度十几个异构数据信道。系统不通过单一的 API 获取结构化数据,而是让代理自主解析不同社区的非结构化动态,利用真实用户的点赞、投票、资金押注进行信号强度加权过滤。
💡 架构核心洞见:通过将多源异构平台的抓取决策权下放给本地 AI 代理,该项目彻底跳过了昂贵的数据采购与中心化索引建设,实现了以用户个人身份为锚点的去中心化分布式侦察。
2. 核心架构与底层数据流转解析
整个运行生命周期由 skills/last30days/SKILL.md 规范定义。当用户在终端输入查询指令时,客户端网关将输入负载传递给动态执行引擎。引擎依据目标主题的特征,并行分发抓取任务至 Reddit、Hacker News、GitHub、Polymarket、arXiv 等多个子模块。对于没有公开 API 的平台,系统直接借由本地浏览器环境提取渲染后的 DOM 或利用社区贡献的独立 CLI 工具链。
[ Client CLI / Claude Code ] ---> [ Gateway Parser ] ---> [ Task Dispatcher ]
                                                              │
        ┌─────────────────────────┬───────────────────────────┴───────────────────────────┐
        ▼                         ▼                           ▼                           ▼
[ Reddit Scraper ]     [ X / Twitter Worker ]     [ Polymarket Odds Engine ]     [ GitHub PR Analyzer ]
        │                         │                           │                           │
        └─────────────────────────┴───────────────────────────┴───────────────────────────┘
                                                              │
                                                              ▼
                                                   [ AI Agent Judge Synthesizer ]
                                                              │
                                                              ▼
                                                   [ Local Terminal Brief ]
数据流转的关键在于评分权重的计算。系统并不平权对待所有抓取结果。一个包含 1500 个 Upvote 的 Reddit 帖子或者附带真实资金押注的 Polymarket 预测概率,其权重会被引擎自动放大。相反,缺乏用户交互的传统长文或静态新闻会被降权处理。所有通道的数据经过清洗与关键句提取后,汇聚至底层的代理判断器中,由大语言模型执行多路交叉验证并去重,最终输出一份结构紧凑的情报摘要。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (last30days-skill) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 数据源覆盖 | Reddit、X、YouTube、Polymarket、GitHub 等 20+ 异构平台 | 单一搜索引擎或单一社交 API | Perplexity Pro / ChatGPT 网页版 | 捕获全网未被索引的一线真实用户反馈 |
| 鉴权与成本 | 零配置起步,支持 BYO 浏览器会话与本地 CLI | 昂贵的企业级 API 采购与 Token 账单 | 商业 SaaS 订阅制,API 额度受限 | 免除高昂的数据采购成本,自主掌控会话额度 |
| 实时性过滤 | 依托真实用户投票、点赞与资金押注动态赋权 | 依赖网页静态更新周期与编辑人工审核 | AI 模型自带的静态训练切片数据 | 杜绝过期信息与公关通稿干扰,直击近 30 天真相 |
| 部署架构 | 插件化本地代理,集成于 Claude Code 或通用 Skill 宿主 | 中心化云端微服务集群,运维复杂度高 | 闭源 Web 统一面板,无法进行本地管道定制 | 零运维负担,直接在现有开发环境中运行 |
技术选型的精妙之处在于放弃了构建统一数据仓库的传统思路。通过代理把客户端变成了一个多协议路由器,每个数据源按需加载,未激活的平台不消耗任何本地或远程计算资源。
4. 手把手极客实操:从零构建最小闭环
在生产环境或本地开发机中安装该 Skill。以 Claude Code 推荐环境为例,直接通过插件市场加载运行:
# 将 last30days 插件直接加入 Claude Code 市场
/plugin marketplace add mvanhorn/last30days-skill

# 在当前工作环境中完成安装
/plugin install last30days

# 或者通过通用 Agent Skills 宿主进行全局安装
npx skills add mvanhorn/last30days-skill -g
安装完成后,在终端执行针对特定人物或技术栈的检索指令:
# 模拟内部执行逻辑的 Python 核心调用脚本参考
import subprocess
import sys

def run_last30days_query(target_topic: str):
    # 组装 CLI 执行参数,指定零配置模式与默认输出通道
    command = ["npx", "skills", "run", "last30days", target_topic]

    # 启动子进程并实时捕获标准输出
    process = subprocess.Popen(
        command,
        stdout=subprocess.PIPE,
        stderr=subprocess.PIPE,
        text=True,
        encoding="utf-8"
    )

    # 逐行读取代理合成的实时情报
    for line in process.stdout:
        sys.stdout.write(f"[ENGINE_LOG] {line}")

    process.wait()
    if process.returncode != 0:
        raise RuntimeError(f"Agent execution failed with code {process.returncode}")

if __name__ == "__main__":
    # 对特定开源维护者过去 30 天的技术动作进行多源穿透检索
    run_last30days_query("Peter Steinberger")
执行该命令后,终端将输出目标对象在 GitHub 的提交频率、Reddit 社区的争议热度、X 平台的最新发言以及相关开源项目的 PR 合并速率综合简报。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
⚠️ 避坑预警 [API 速率与浏览器会话失效]:当高频调用 X 或 Reddit 抓取通道时,若直接复用本地未登录的浏览器会话,极易触发平台的风控拦截。建议在使用前确保本地默认浏览器已处于登录状态,或通过环境变量配置专属的代理凭据。
⚠️ 避坑预警 [Token 消耗失控风险]:YouTube 视频转录文本与长篇 Reddit 讨论串包含大量的非结构化原始文本。若盲目将所有原始 Token 一次性喂给大模型判断器,单次查询会产生极高的 API 成本。请在配置文件中严格限定单源抓取的最大字符截断数,优先依赖代理内置的向量摘要过滤层。