
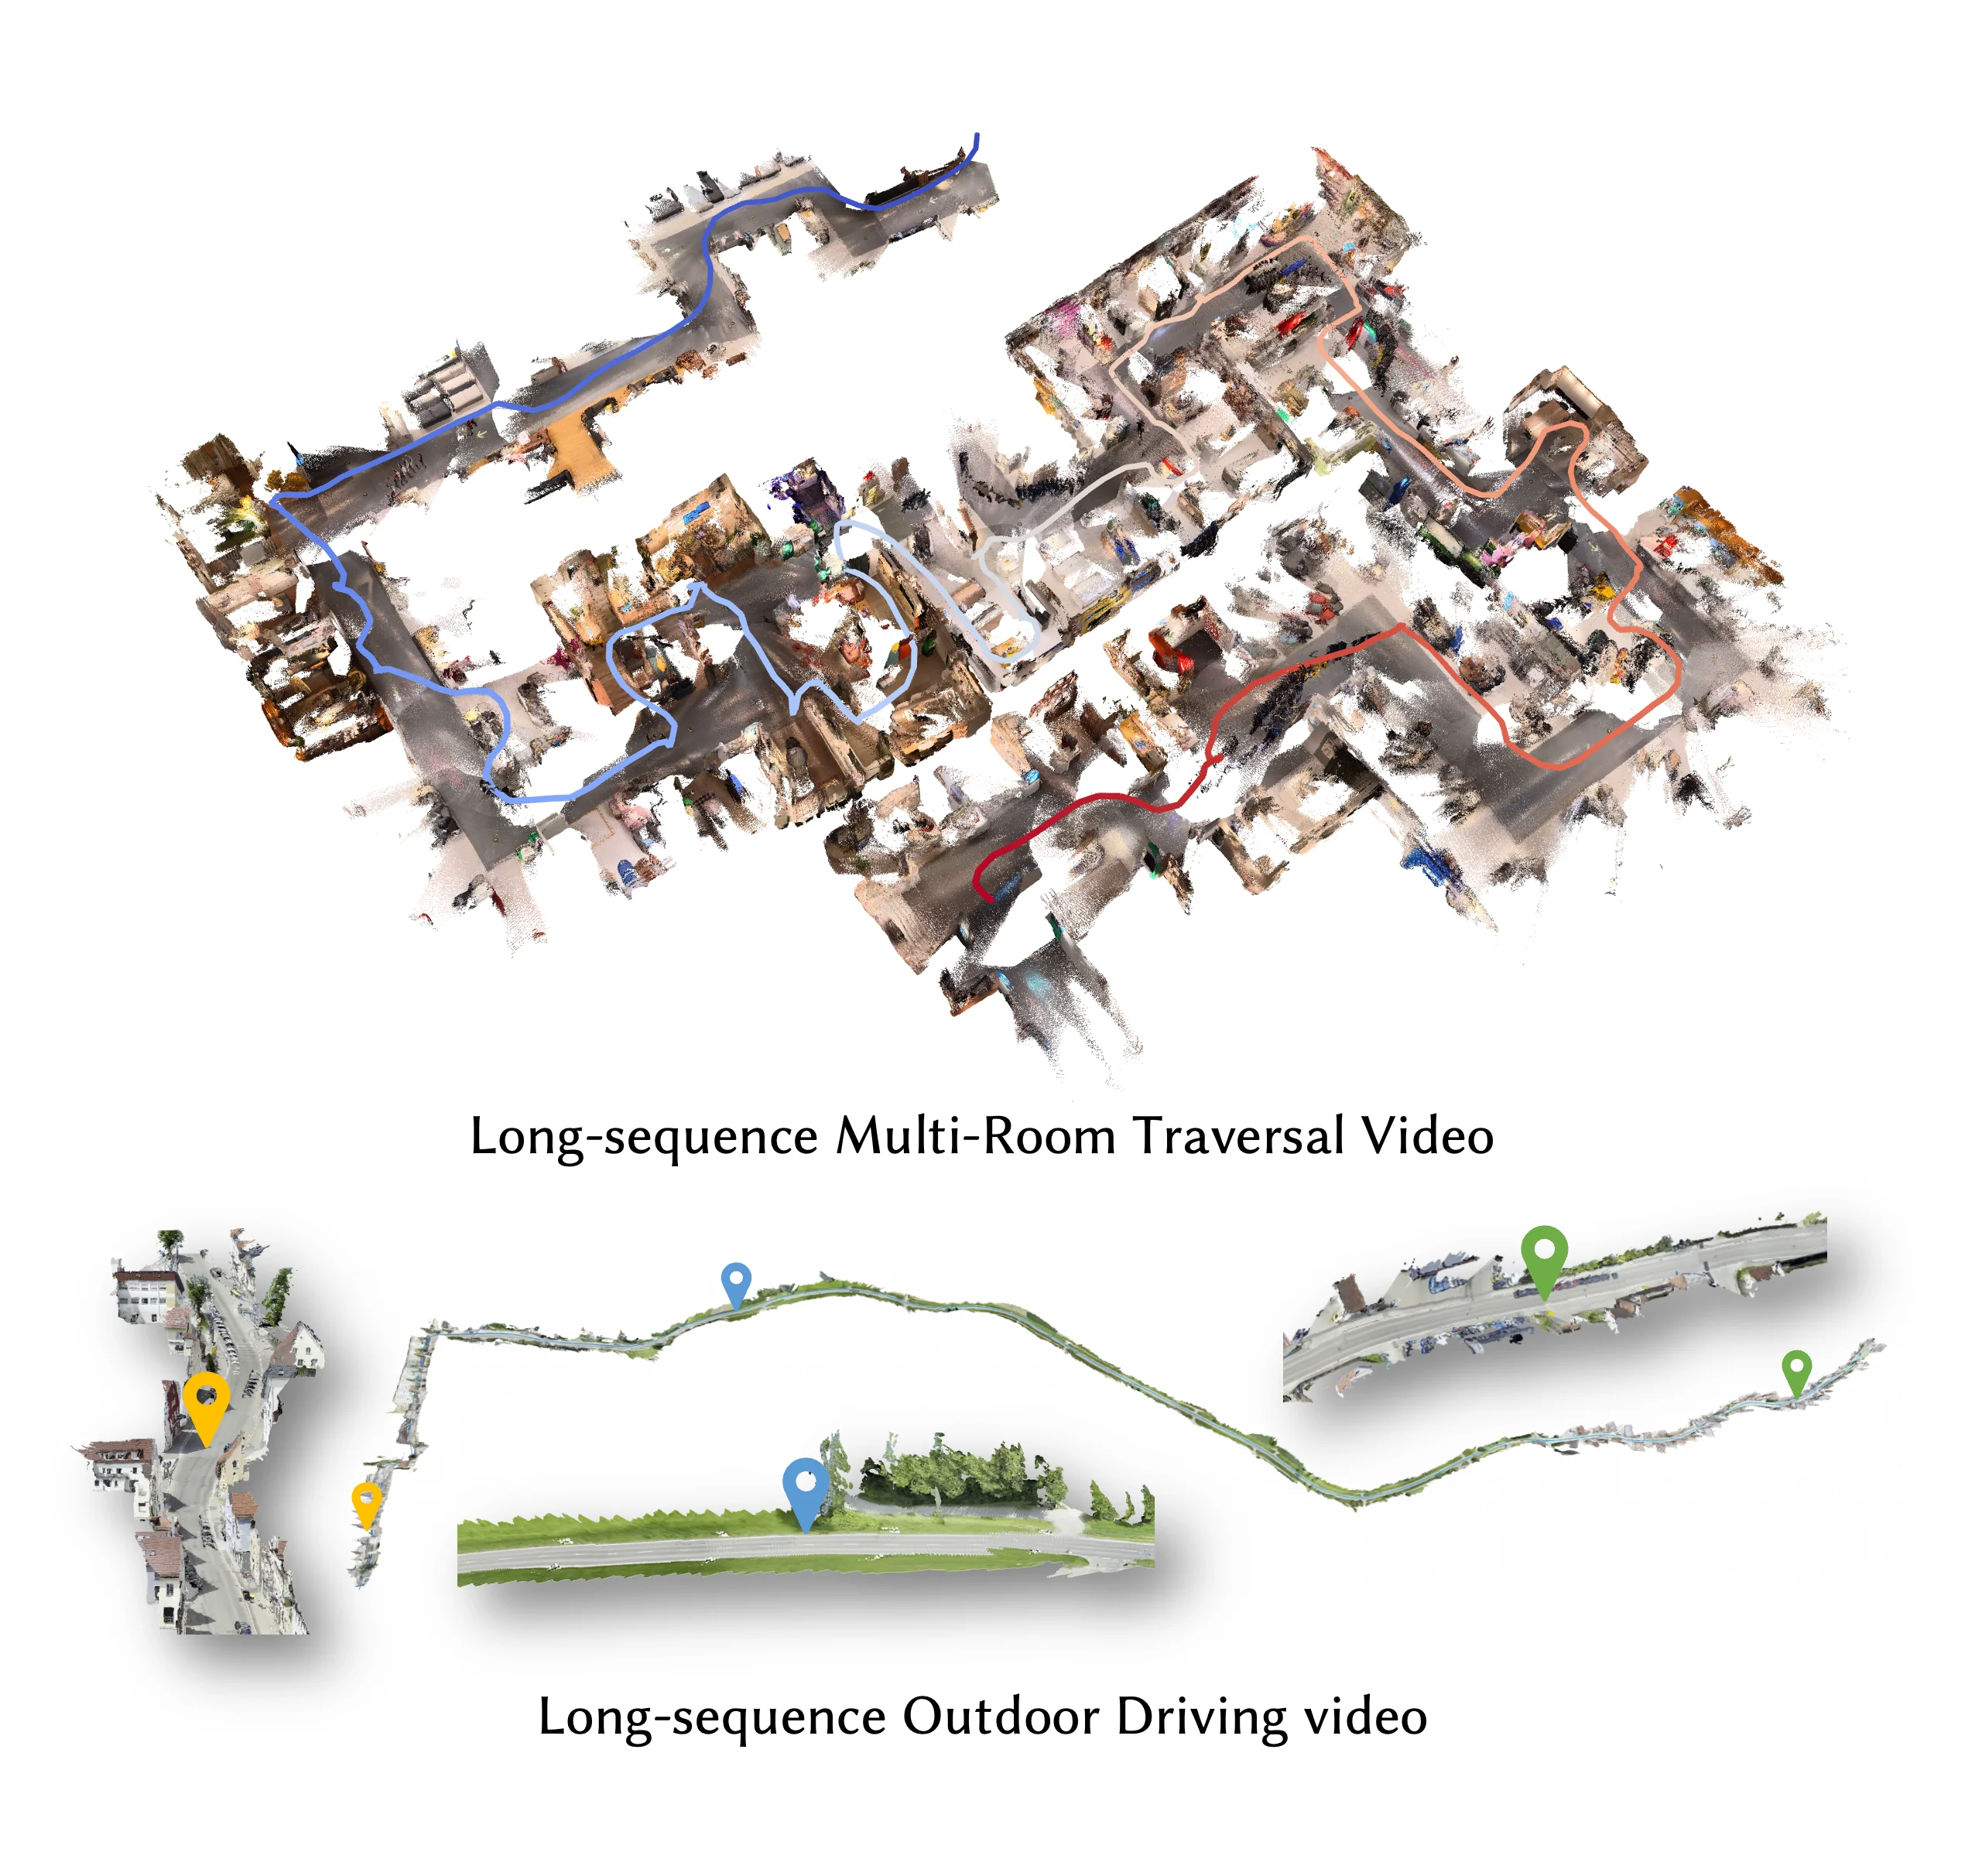
1. 痛点突围:它究竟击穿了什么工程死穴?
传统的 3D 重建流水线高度依赖基于迭代优化的 SfM 算法,面对超过千帧的动态视频输入时,计算复杂度和显存开销会呈指数级膨胀。这导致长距离室内外场景的实时建图在工程落地阶段几乎不可行。Robbyant 团队开源的 LingBot-Map 直接放弃传统离线优化范式,采用前馈式 3D 基础模型,在架构层面实现了流式重建的突破。
💡 架构核心洞见:LingBot-Map 通过将坐标接地、密集几何线索与长距离漂移校正统一在单一流式框架中,彻底消除了传统迭代优化对全局平差的算力依赖。
2. 核心架构与底层数据流向解析
LingBot-Map 的核心是 Geometric Context Transformer (GCT)。该架构依靠三个互锁组件协同工作:锚点上下文、姿态参考窗口以及轨迹记忆模块。输入端通过视频帧流进入解析层,由 FlashInfer 管理分页 KV 缓存(Paged KV Cache),避免内存在长序列处理中发生碎片化和溢出。
[ Video Stream ] ---> [ Frame Parser & Masking ] ---> [ Paged KV Cache Engine ]
                                                            │
                                                            ▼
[ 3D Viser Client ] <--- [ Rendering Pipeline ] <--- [ Geometric Context Transformer ]
在执行阶段,系统并不缓存全部历史帧的完整注意力权重,而是通过 Pose-Reference Window 动态裁剪注意力范围,同时利用 Trajectory Memory 压缩并保留全局几何约束。这种设计在维持约 20 FPS 推理速率的同时,保证了模型在跨越 10,000 帧以上的漫长行走路径中不会出现空间漂移和坍塌。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (lingbot-map) | 传统实现范式 (COLMAP/SfM) | 典型轻量级竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 推理吞吐 | ~20 FPS (518×378) | 几帧/分钟 (离线求解) | ~10 FPS | 满足实时交互与无人系统在线建图 |
| 显存开销 | Paged KV Cache 线性可控 | 随帧数呈平方级爆炸 | 全量缓存易 OOM | 彻底解决长视频内存溢出痛点 |
| 长序列漂移 | 轨迹记忆与锚点上下文校正 | 依赖全局束差分 (Bundle Adjustment) | 累积误差显著 | 10,000+ 帧序列无需人工重置 |
| 部署复杂度 | 单条命令容器化/Conda 部署 | 编译链繁琐,依赖项冲突多 | 依赖特定硬件平台 | 降低研发团队的集成维护成本 |
从硬核对比数据来看,LingBot-Map 砍掉了离线密集优化的中间等待耗时,在流式传输和工业实时场景中形成了降维打击。FlashInfer 后端的引入让内存利用率达到了生产环境的及格线。
4. 手把手极客实操:从零构建最小闭环
在执行安装前,需确保系统已安装 CUDA 12.8 驱动。以下步骤直接还原官方推荐的最小运行环境:
# 创建并激活专用的 Python 3.10 虚拟环境
conda create -n lingbot-map python=3.10 -y
conda activate lingbot-map

# 安装与 CUDA 12.8 精准匹配的 PyTorch 2.8.0 核心库
pip install torch==2.8.0 torchvision==0.23.0 --index-url https://download.pytorch.org/whl/cu128

# 以可编辑模式本地安装 lingbot-map 源码包
pip install -e .

# 安装 FlashInfer 提供的高性能分页 KV 缓存加速后端
pip install --index-url https://pypi.org/simple flashinfer-python
环境就绪后,下载官方权重文件,并通过内置的 demo.py 启动基于 Viser 的浏览器端实时可视化交互:
# 启动可视化交互脚本,启用天空掩码消除背景噪声
python demo.py \
    --model_path /path/to/lingbot-map.pt \
    --image_folder example/courthouse \
    --mask_sky
终端输出服务监听地址后,在浏览器访问 http://localhost:8080 即可实时观测 3D 重建网格的生长过程。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在处理超长视频或迁移至自有数据集时,工程团队常遇到隐蔽的参数配置陷阱。
⚠️ 避坑预警 1:PyTorch 与 Kaolin 版本绑定冲突:官方明确指出 PyTorch 2.8.0 是批处理渲染管线的硬性依赖,因为 NVIDIA Kaolin 提供了该版本的预编译 wheel。若因业务需要盲目升级 PyTorch 主版本,将触发源码编译 Kaolin 的漫长过程,且极易因 GCC 版本不匹配导致编译中断。
⚠️ 避坑预警 2:FlashInfer KV 缓存静默失效:当使用
--keyframe_interval > 1运行长序列时,务必拉取最新代码并核对 FlashInfer 的缓存索引逻辑。旧版本代码曾在关键帧间隔参数中存在静默缓存非关键帧的缺陷,会导致在连续运行超过 320 帧后重建位姿严重恶化。