
1. 痛点突围:它究竟击穿了什么工程死穴?
大语言模型驱动的工程代理在处理复杂代码库和超大日志时,上下文窗口迅速被塞满。开发者反复遭遇 API 成本飙升、KV 缓存频繁失效以及模型因长文本注意力涣散导致的工具调用失误。云端第三方压缩方案往往存在严重的代码泄露与隐私合规隐患,直接调用海量明文日志传输也拖垮了网络吞吐。
Headroom 直接将压缩层前置在本地宿主机中。所有传入大模型的数据,包括工具输出、文件内容、RAG 片段与历史对话,都在本地完成清洗、路由与压缩。模型既收到了精简后的指令集,又能在必要时通过本地缓存引用按需找回原始内容,从根本上平衡了长文本吞吐与推理精度。
💡 架构核心洞见:通过本地拦截与分流压缩,Headroom 守住了数据隐私的红线,同时切断了无效 Token 对模型注意力的污染源。
2. 核心架构与底层数据流向解析
Headroom 内部采用多路复用流水线架构。当客户端或编码代理发出提示词时,请求首先交由 CacheAligner 评估是否存在污染 KV 缓存前缀的挥发性内容,随后进入 ContentRouter 自动识别数据类型。系统根据负载特性将数据分发至 SmartCrusher 处理 JSON 结构、CodeCompressor 解析抽象语法树,或者通过基于 Hugging Face 的 Kompress-v2-base 模型处理纯文本。
 Your agent / app
   (Claude Code, Cursor, Codex, LangChain, Agno, Strands, your own code…)
        │   prompts · tool outputs · logs · RAG results · files
        ▼
    ┌────────────────────────────────────────────────────┐
    │  Headroom   (runs locally — your data stays here)  │
    │  ────────────────────────────────────────────────  │
    │  CacheAligner  →  ContentRouter  →  CCR            │
    │                    ├─ SmartCrusher   (JSON)        │
    │                    ├─ CodeCompressor (AST)         │
    │                    └─ Kompress-v2-base (text, HF)  │
    │                                                    │
    │  Cross-agent memory  ·  headroom learn  ·  MCP     │
    └────────────────────────────────────────────────────┘
        │   compressed prompt  +  retrieval tool
        ▼
 LLM provider  (Anthropic · OpenAI · Bedrock · …)
经压缩的数据流配合 CCR(Cache-Compressed Retrieval)本地存储机制输出给各大模型提供商。若代理在执行过程中需要被压缩的原始长文本,可直接调用本地注册的 headroom_retrieve 工具获取。这种动静分离的引用恢复模式,既保证了传输体量的轻量化,又保留了全量数据的回溯可能。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (headroom) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 数据隐私 | 本地运行,零明文外传 | 频繁上传云端清洗 | 第三方 SaaS 托管 | 规避代码资产合规风险 |
| 压缩策略 | 区分 JSON/AST/Prose 专属算法 | 全局统一截断或粗暴丢弃 | 依赖模型原生长上下文 | 关键错误字节零丢失 |
| 代理集成 | 一键包装主流编码工具 (CLI/MCP) | 强依赖 SDK 重构业务代码 | 绑定特定 IDE 或框架 | 零代码侵入快速上线 |
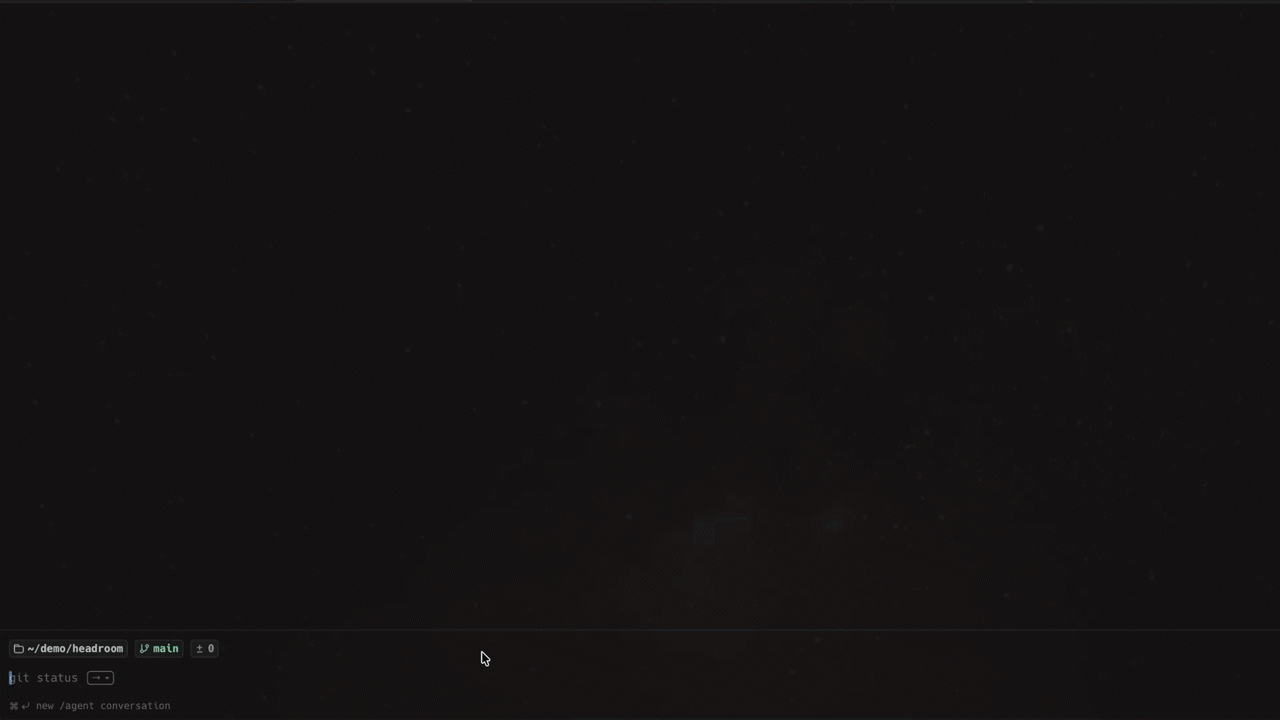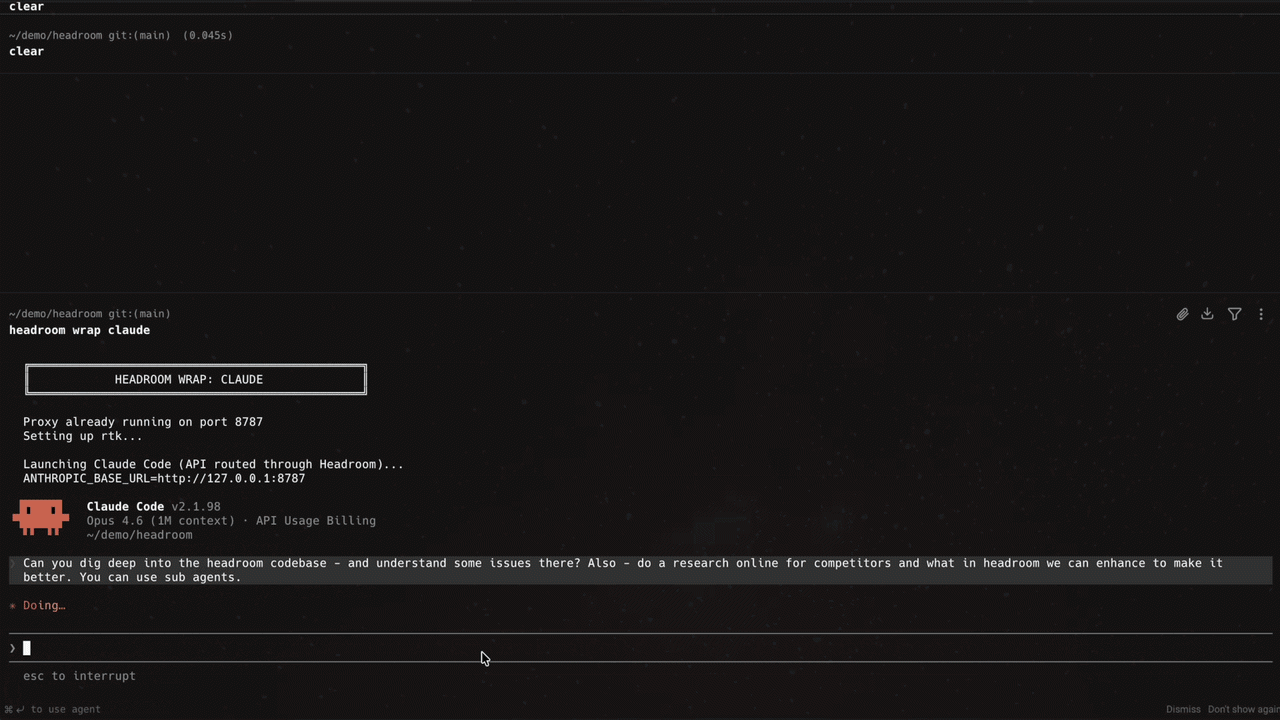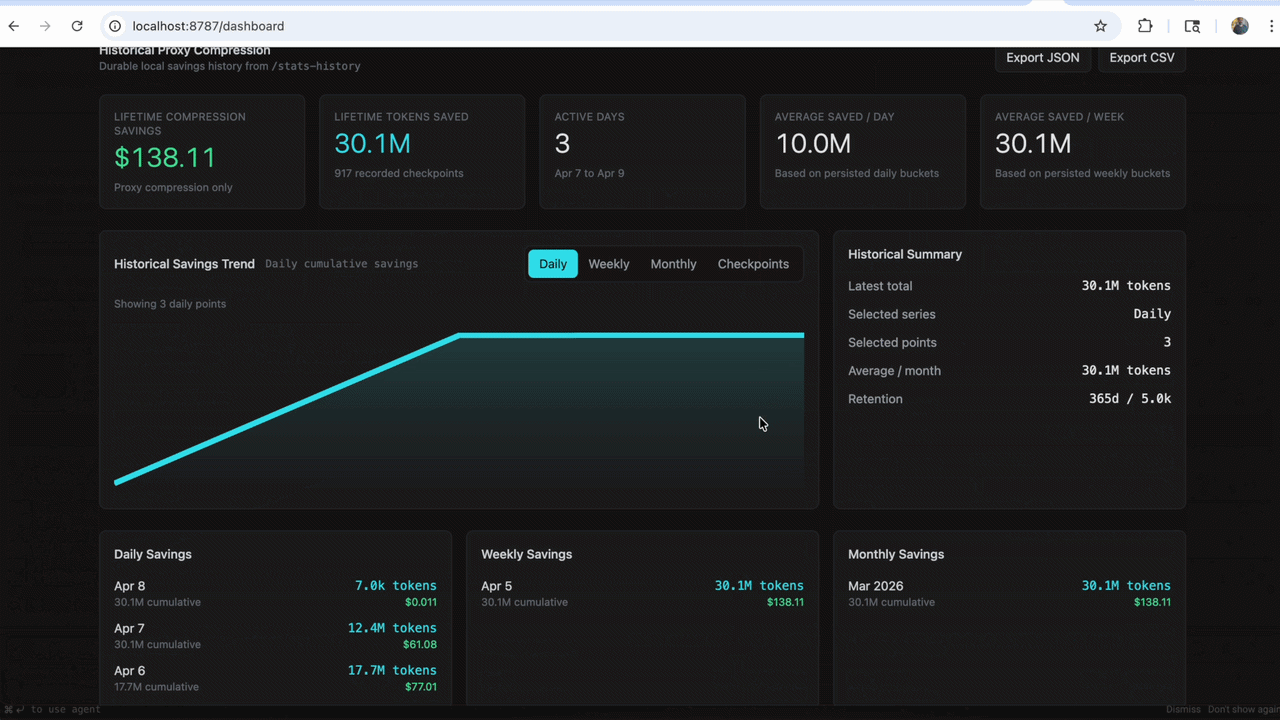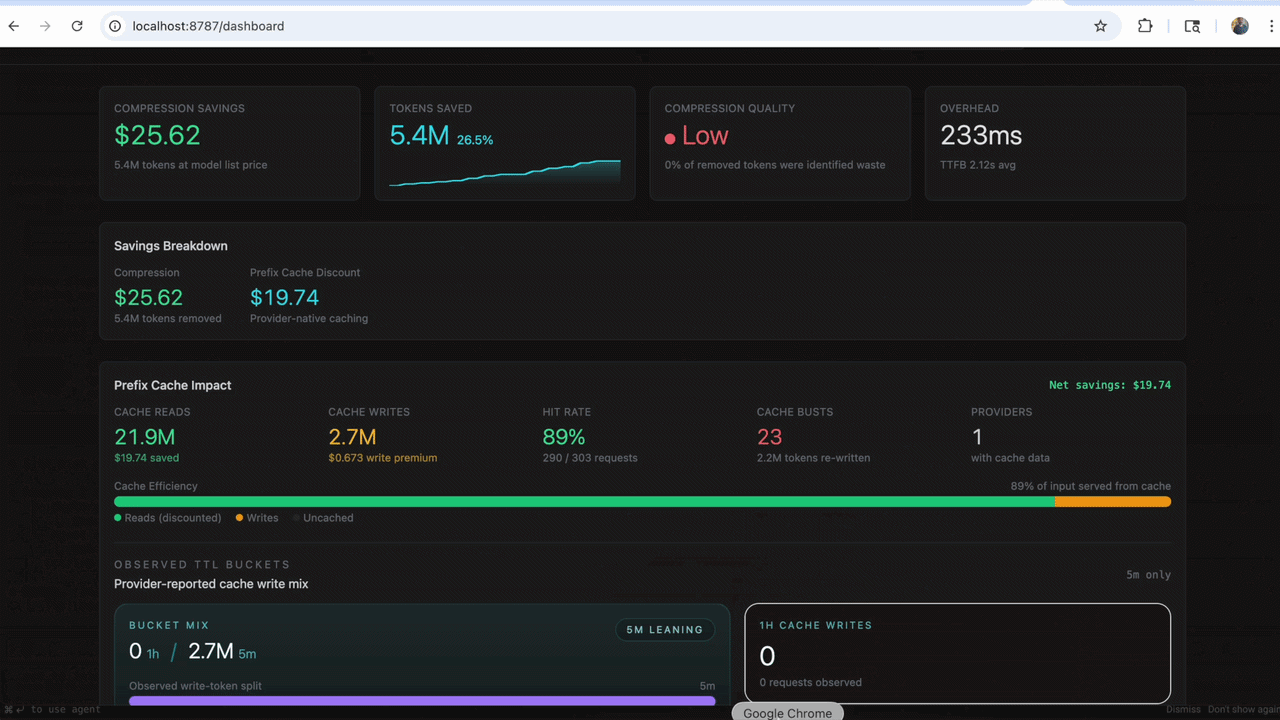
| 成本节约 | 实测最高缩减 57% Token 消耗 | 长期承担高额 API 账单 | 部分开源分块 RAG 方案 | 直接压低研发算力成本 |
主流大模型往往对超长上下文收取高昂的费用,且伴随延迟增加。Headroom 放弃了盲目信任模型无限上下文的幻觉,用工程化的压缩与路由将无效文本在入口处拦截。这种精准裁剪在维持任务完成率的同时,将单位请求成本压到了最低。
4. 手把手极客实操:从零构建最小闭环
在类 Unix 环境中,通过独立的 uv 工具环境直接安装包含完整 CLI 与依赖的软件包:
# 1. 使用 uv 在独立环境安装 headroom 及所有扩展组件
uv tool install --python 3.13 "headroom-ai[all]"

# 2. 部署本地代理服务,监听 8787 端口
headroom proxy --port 8787

# 3. 运行健康检查,确认代理与内容路由正常工作
headroom doctor
在 Python 代码中直接引入 compress 函数,对大模型对话历史进行内联拦截压缩:
from headroom import compress
from openai import OpenAI

# 构造待分析的超长原始消息队列
messages = [
    {"role": "system", "content": "You are an SRE debugging assistant."},
    {"role": "user", "content": "Analyze these massive log results and find the root cause."}
]

# 调用本地 Headroom 引擎进行压缩处理,自动适配 gpt-4o 模型特性
result = compress(messages, model="gpt-4o")

client = OpenAI()
# 将压缩后的 messages 列表发送给 OpenAI API 接口
response = client.chat.completions.create(
    model="gpt-4o",
    messages=result.messages
)

# 打印压缩成效统计数据
print(f"Saved {result.tokens_saved} tokens ({result.compression_ratio:.0%})")
执行 headroom wrap claude 即可接管 Claude Code 代理会话,在后台自动启动本地代理并挂载 Serena 语义代码导航模块,实现多工具链的共享记忆与压缩联动。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在多代理并发调用或长周期自动化脚本场景中,本地缓存目录的增长速度超出预期,未设清理策略会导致磁盘空间占用不断累积。
⚠️ 避坑预警 [本地缓存膨胀]:CCR 本地缓存会持久化大量压缩前的原始文本。建议在生产服务器或持续集成流水线中定期执行缓存清理命令,或者通过环境变量指定独立的生命周期清理策略。
部分私有化大模型或微调模型对非规范的提示词结构敏感,当 ContentRouter 启用深度抽象语法树压缩时,可能会导致特定自定义系统指令的解析语义发生轻微偏移。
⚠️ 避坑预警 [自定义指令失真]:若业务代码中包含高度定制的 DSL 或非标准 JSON 协议,切勿盲目开启激进压缩模式。应当先通过
headroom doctor校验路由规则,必要时在代理配置中显式排除特定敏感消息段。