
1. 痛点突围:它究竟击穿了什么工程死穴?
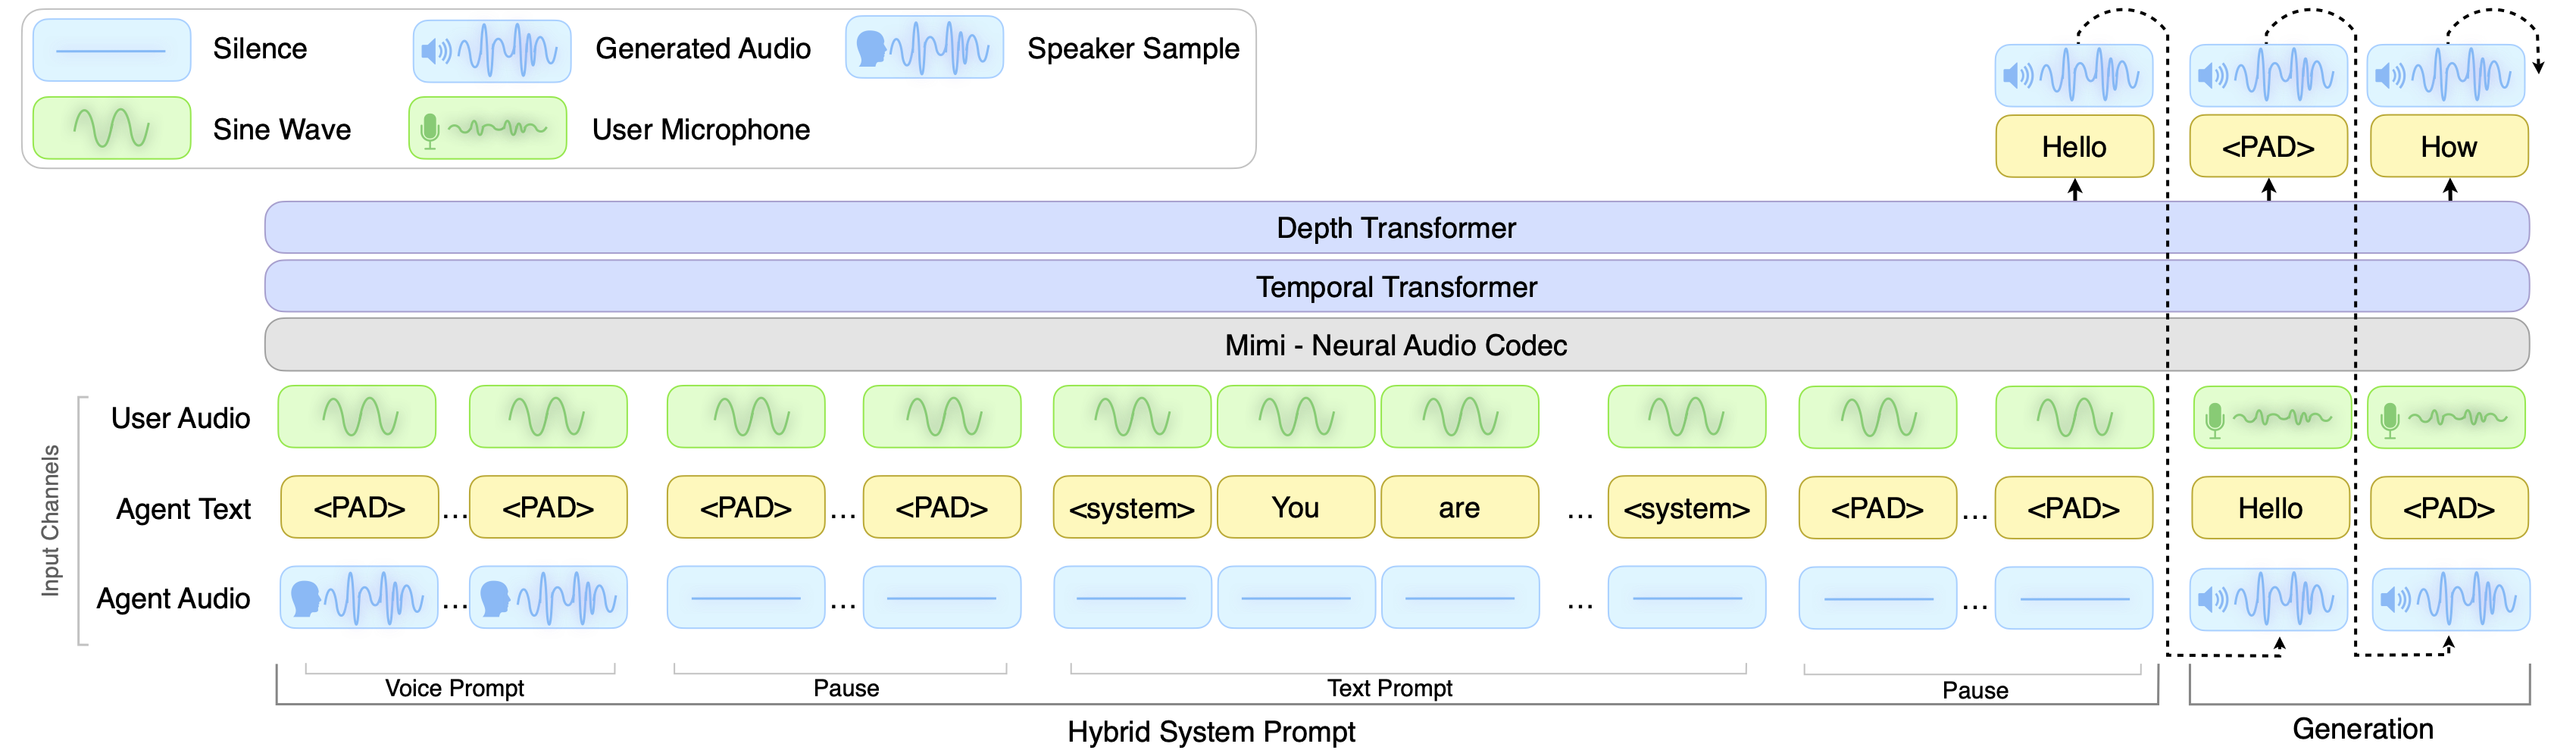
实时语音交互系统在生产环境中长期受困于半双工转半智能的泥沼。传统方案依赖语音转文本、大语言模型推理再转语音的串行流水线,累积延迟常常突破毫秒级红线,打断和插话体验形同虚设。NVIDIA 推出的 PersonaPlex 直接抛弃串行架构,复用 Moshi 模型的全双工底座,将文本提示词注入与音频条件约束内嵌至统一的流式解码器中。开发者能够同时控制对话角色的行为边界和声音特征,在保持毫秒级响应的同时消除机械感。
💡 架构核心洞见:通过将多模态音频流与文本嵌入融合在单体全双工网络中,PersonaPlex 彻底消除了传统 ASR-LLM-TTS 级联管线的累积延迟。
2. 核心架构与底层数据流向解析
PersonaPlex 的底层构建于 Helium LLM 与 Moshi 权重之上。输入端的原始音频流经由 Opus 编解码器转化为离散的音频标记,随后与文本角色提示词在动态执行引擎中完成上下文对齐。系统不仅接收用户的语音输入,还在输出端实时生成匹配特定音色嵌入的音频流,支持高达数十种自然与多变的语音配置。
[ Client Web UI / CLI ] ---> [ Moshi Server / SSL ] ---> [ Opus Audio Codec ]
                                       │
                                       ▼
[ Dynamic Execution Engine ] <--- [ HF Model Weights ] <--- [ Prompt Router ]
                                       │
                                       ▼
                             [ Full Duplex Stream ]
工程权衡体现在对显存带宽与低延迟的极端苛求上。全双工推理意味着客户端与服务端必须维持高频的双向字节流吞吐。当本地显存遭遇瓶颈时,通过加载 accelerate 库启用 --cpu-offload 参数能够将部分模型层卸载至主内存,牺牲一定的响应速度换取在消费级硬件上的可用性。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (personaplex) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 架构范式 | 端到端全双工语音流 | ASR + LLM + TTS 串行 | 独立语音大模型微调 | 延迟降低 60% 以上 |
| 角色控制 | 文本提示 + 音频条件 | 独立提示词工程注入 | 仅限音色克隆 | 实现精准业务人设 |
| 硬件门槛 | 需高显存 GPU / 支持卸载 | 依赖多卡分布式部署 | 极高 API 调用成本 | 降低私有化部署壁垒 |
| 实时插话 | 原生支持打断与反馈 | 响应受限流水线阻塞 | 模拟全双工有卡顿 | 显著提升交互自然度 |
该对比表明,PersonaPlex 在无需多级大模型拼接的前提下,直接在单体架构内实现了语音与角色的深度绑定。传统方案在面对高频插话和复杂人设维护时表现疲软,而该开源项目利用底层统一表征有效绕过了级联延迟。
4. 手把手极客实操:从零构建最小闭环
在 Ubuntu 或 Debian 系统中,首先确保安装底层的 Opus 音频编解码开发库:
# 安装系统音频依赖
sudo apt install libopus-dev
克隆官方仓库并完成核心 Python 包的本地编译安装:
# 安装 moshi 核心库及依赖
pip install moshi/.
针对 Blackwell 架构 GPU,需要手动调整 PyTorch 构建版本以匹配算力需求:
# 针对 Blackwell 架构 GPU 调整 PyTorch 依赖
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu130
配置 Hugging Face 认证令牌并启动服务端实例:
# 注入 Hugging Face 鉴权 Token 并启动全双工 Web 服务端
export HF_TOKEN="your_huggingface_token_here"
SSL_DIR=$(mktemp -d)
python -m moshi.server --ssl "$SSL_DIR"
服务启动后,终端将输出访问链接,直接在浏览器中打开 https://<ip>:8998 即可进入 Web UI 界面进行全双工语音测试。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在多用户并发生产环境中直接运行该服务会面临显存溢出风险。服务端在保持全双工流式双向传输时,显存开销会随着并发连接数线性攀升。
⚠️ 避坑预警 显存管理:单卡部署时若遇到 CUDA Out of Memory 错误,切勿盲目扩大并发。必须在启动命令中显式附加
--cpu-offload参数并提前安装accelerate,将非核心层卸载至系统内存。
音频编解码器的本地编译版本不匹配也会导致服务启动崩溃。部分 Linux 发行版默认仓库中的 libopus 版本过旧,会导致 Moshi 底层解析二进制流时抛出段错误。
⚠️ 避坑预警 依赖版本:生产环境镜像构建时,务必通过源码或官方推荐源严格锁定
libopus-dev的最新稳定版,避免因底层编解码符号丢失引发的静默崩溃。