
1. 痛点突围:它究竟击穿了什么工程死穴?
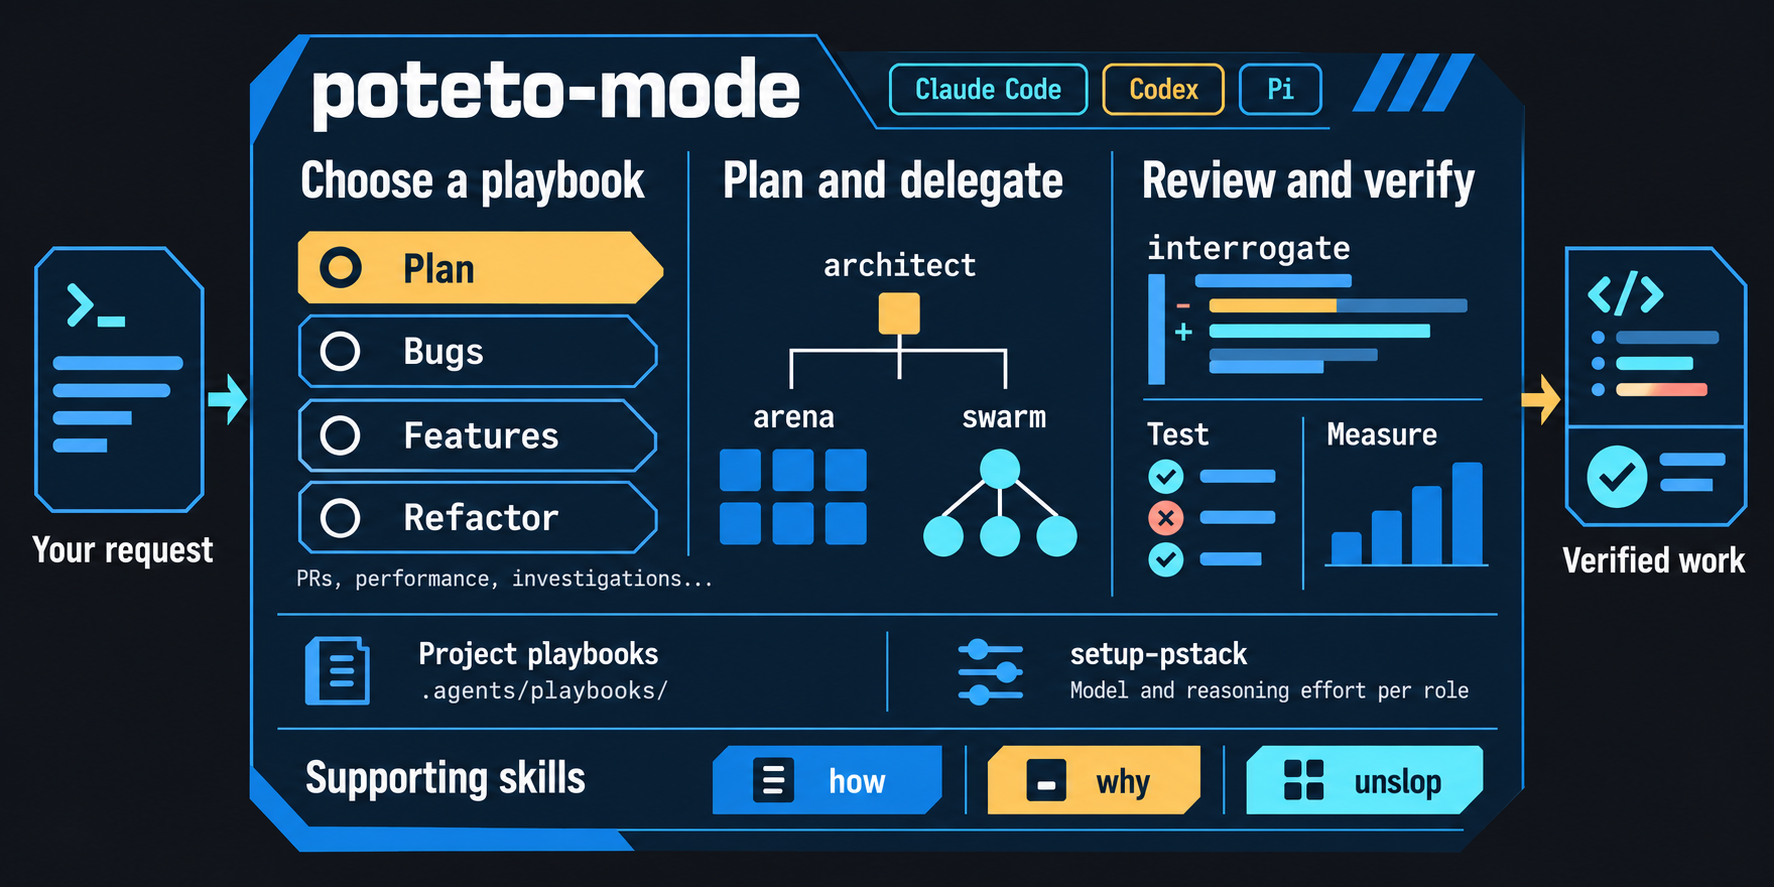
当前主流的 AI 编程助手普遍陷入一种漫无目的的自由发挥状态。当开发者输入复杂的缺陷修复或架构重构指令时,大模型往往直接跳过严谨的根因调查,盲目修改代码并引发连锁回归错误。这种缺乏状态机约束和职责隔离的交互范式,导致多轮对话后的上下文污染极为严重,最终产出无法通过自动化测试的脆弱产物。michael-denyer/pstack-claude 项目将 Lauren Tan 打造的 Cursor 专属 opinionated skill 栈完整移植到了 Claude Code、Codex 以及 Pi 等独立 Agent 运行环境中。该架构通过引入一套显式的策略断言与角色分工约束,强制大模型在行动前必须经历问题复现、路径调查与架构评审,从而终结了代理执行的失控状态。
💡 架构核心洞见:pstack-claude 的本质是用结构化的运行时策略替代大模型的概率漫游,将自由发散的文本生成强行纳入确定性的软件工程生命周期流水线。
2. 核心架构与底层数据流向解析
pstack-claude 的底层运行依赖于一个精心设计的插件扩展层。当用户在 CLI 终端输入特定指令时,路由机制会拦截输入并将其分发至对应的 skill 模块。整个生命周期的核心驱动器是 poteto-mode,它在收到目标指令后,会依次激活 how 与 why 工具链进行静态分析与动态行为追踪。如果修改触及函数边界,系统会主动挂载 architect 子代理进行方案评审。所有中间状态与测试证据会被持久化记录,最终交由 interrogate 进行验证。
[ User Input CLI ] ---> [ Routing Hook / Extension Parser ] ---> [ poteto-mode Orchestrator ]
                                                                          │
                                                 ┌────────────────────────┴────────────────────────┐
                                                 ▼                                                 ▼
                                       [ how / why Investigation ]                     [ architect Delegation ]
                                                 │                                                 │
                                                 └────────────────────────┬────────────────────────┘
                                                                          ▼
                                                        [ Verification / interrogate & Tests ]
从数据流向观察,该项目巧妙地解耦了意图解析与执行引擎。插件在 Claude Code 和 Codex 中安装路由钩子,并在 Pi 运行时中注入原生扩展工具。这种架构设计允许开发者针对不同代理角色精确分配推理算力,例如将 arena runners 设置为 opus @xhigh,确保关键推理节点的计算密度,同时避免全链路高昂的 Token 损耗。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (pstack-claude) | 传统原生大模型对话 | 基础 IDE 插件辅助 | 单体脚本自动化方案 |
|---|---|---|---|---|
| 约束机制 | 强状态机与显式 Playbook | 零约束纯概率生成 | 基础语法高亮与补全 | 硬编码正则表达式匹配 |
| 任务拆解 | 自动委派 architect 与子代理 | 单一 Prompt 贯穿到底 | 仅限单文件局部修改 | 固定线性脚本无自愈能力 |
| 上下文控制 | 动态路由过滤与记忆蒸馏 | 随着对话轮数迅速劣化 | 依赖 IDE 内存窗口缓存 | 全局上下文极易溢出 |
| 生产验证 | 强制关联 failing/passing 证据 | 无自动化校验与回测 | 依赖人工肉眼 Code Review | 仅执行基础单元测试网关 |
| 跨环境支持 | 支持 Claude Code、Codex、Pi | 严重绑定特定厂商闭环 | 绑定特定 IDE 客户端 | 维护成本随环境剧增 |
这套对比数据揭示了 pstack-claude 的核心护城河。它没有重复造轮子去训练基础模型,而是通过高密度的工程编排层,把现有的通用大模型死死锁在规范的软件工程轨道上,让非确定性的 AI 变成了确定性的工程外挂。
4. 手把手极客实操:从零构建最小闭环
在生产环境中部署该插件栈需要依托对应终端的插件市场指令。以 Claude Code 为例,整个安装与初始化过程仅需两条标准命令。执行完成后,系统会在本地注入 pstack 扩展工具集。
# 在 Claude Code 终端内添加官方插件市场源
/plugin marketplace add michael-denyer/pstack-claude

# 正式安装 pstack 核心插件包
/plugin install pstack@pstack-claude

# 启动配置向导,调整模型默认参数与角色推理算力
/pstack:setup-pstack
安装完成后,可以通过 poteto-mode 触发一个实际的排查任务。在终端中输入具体的业务修复诉求,观察其自动化工作流的运转轨迹:
Use poteto-mode to fix the search filter resetting when I change pages.
系统在接收到该指令后,会自动执行以下动作链:首先复现搜索过滤重置的失败用例;接着调用 how 和 why 深入定位状态管理源码;随后委派 architect 生成边界清晰的修改方案;最后在应用补丁后重新运行失败用例,输出完整的通过证据链。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在将 pstack-claude 接入日均数百次提交的高强度生产流水线时,必须警惕几个隐蔽的工程陷阱。首当其冲的是 Codex 运行环境下的安全钩子拦截问题。
⚠️ 避坑预警 [Codex 钩子未授权]:Codex 在首次加载插件的路由钩子时会出于安全策略挂起执行。开发者必须在终端中主动运行
/hooks命令并确认信任该插件,否则后台路由指令将无法正常注入,导致所有/skill调用静默失败。
另一个常被忽视的痛点在于推理算力配置过载。通过 setup-pstack 为所有代理角色无脑开启最高推理级别(如 @max 或 @xhigh)会直接导致 API 账单暴涨,并显著增加单个任务的端到端冷启动延迟。最佳工程实践是仅在涉及核心架构调整的 architect 角色上提升算力级别,其余常规调查与测试验证环节保持会话默认算力,以此在执行质量与 Token 成本之间取得平衡。
⚠️ 避坑预警 [高算力推理费用失控]:全局无差别开启高强度推理算力会使单次任务的 Token 消耗增加 3 到 5 倍。建议通过策略文件按角色精细化控制算力分配,避免非关键子代理吞噬宝贵的预算额度。