
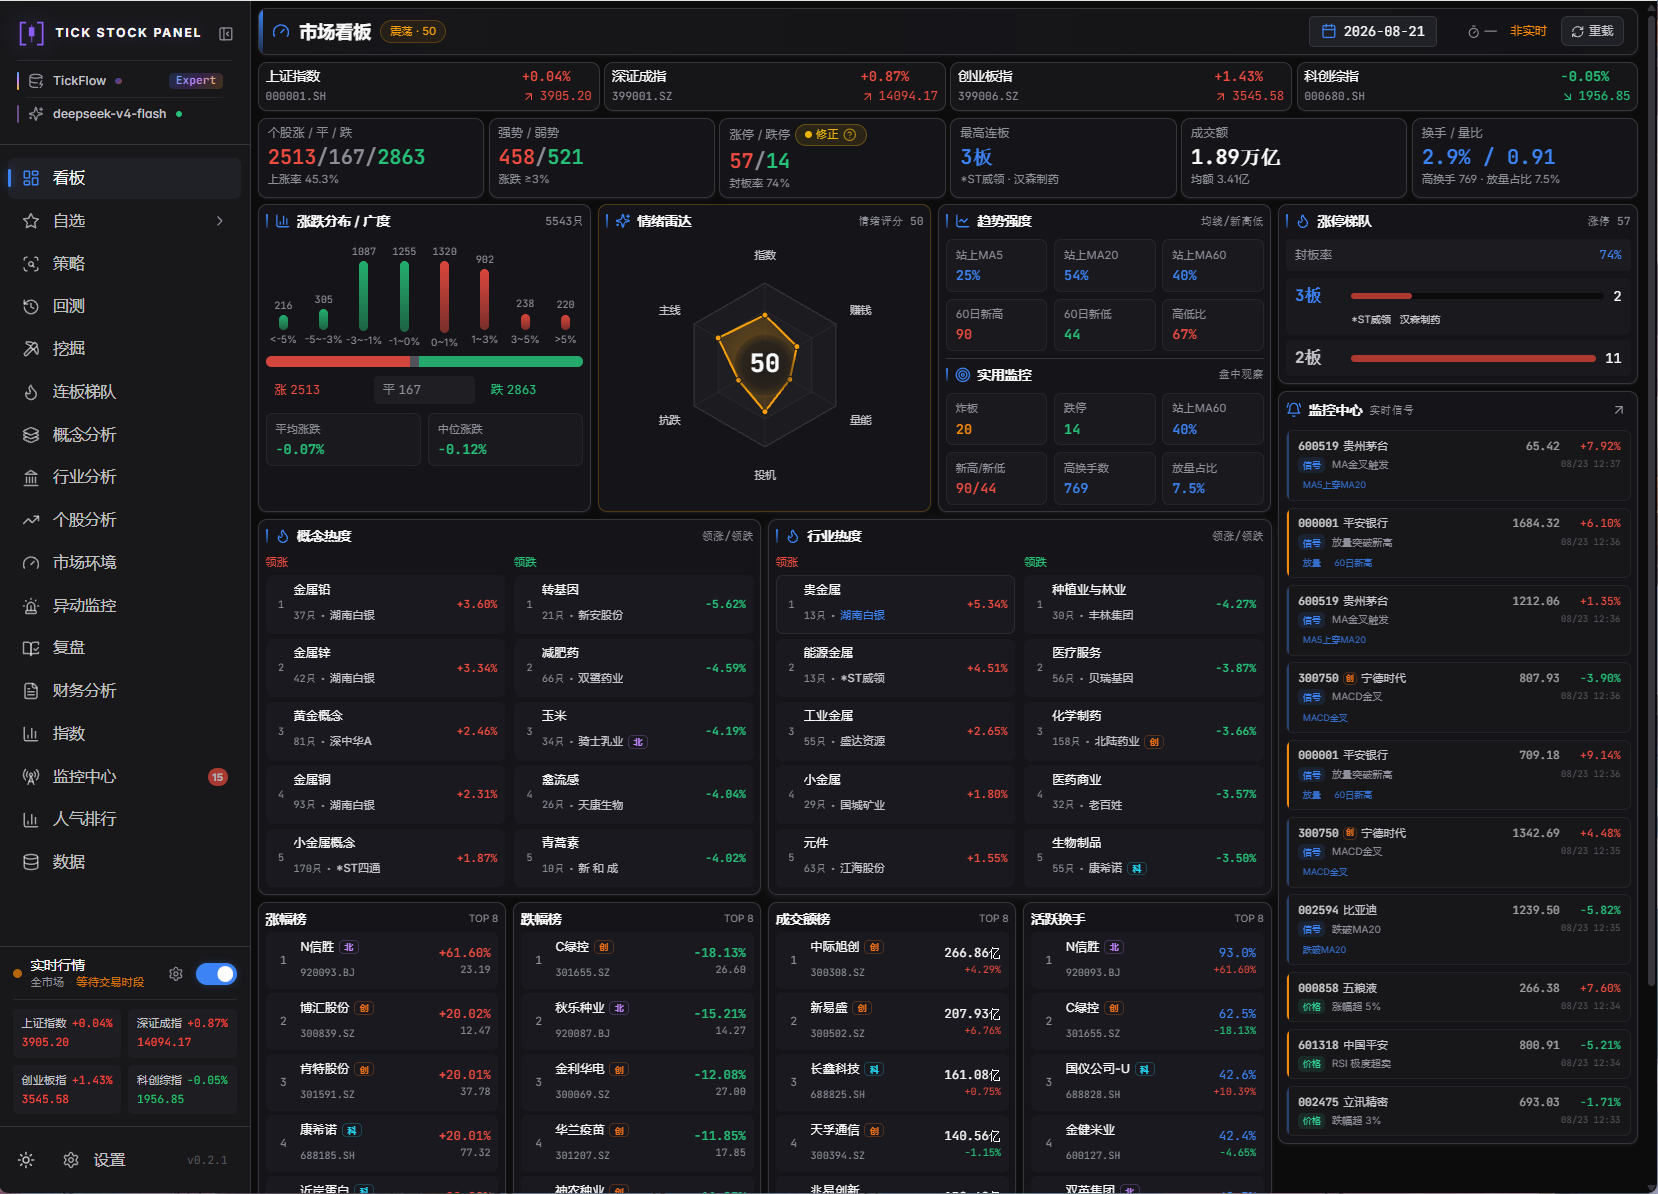
1. 痛点突围:它究竟击穿了什么工程死穴?
自研 A 股量化系统通常会陷入多套异构工具拼接的泥潭。行情数据源紧耦合在特定 SDK 中,导致更换数据提供商需要重写整套拉数逻辑;选股、回测、盘中异动监控使用各自独立的脚本与数据库,最终因指标计算口径不一致产生严重的逻辑漂移;面向大模型的量化助手往往停留在浅层的文本问答,无法安全地操作底层交易策略或回测管道。tick-stock-panel 通过自托管单容器架构和统一的 enriched 数据口径切入,将数据路由、指标流水线、回测研究与 AI 客户端执行引擎收敛至单一控制平面。
💡 架构核心洞见:通过将多源数据归一化至本地 Parquet 并通过能力路由矩阵隔离上游变更,该架构在确保极低运维成本的同时,建立了从原始 Tick 到 AI 动作用例的确定性契约。
2. 核心架构与底层数据流向解析
整个系统的核心计算依赖 Polars 内存向量化引擎,结合本地 Parquet 文件实现高性能查询。底层数据同步管道通过插件化数据源拉取原始行情,流经指标流水线计算 68 列核心指标与信号,最终持久化落盘为 enriched 数据。AI 对话助手则通过 MCP(Model Context Protocol)协议与 61 个开放 API 端点进行交互,任何写操作均强制触发确认卡机制。
[ Third-party Data Sources ] ---> [ Capability Routing Matrix ]
                                              │
                                              ▼
[ AI Clients / MCP ] <---> [ API Gateway (61 Endpoints) ]
                                              │
                                              ▼
                              [ Polars Calculation Engine ]
                                              │
                                              ▼
                              [ Local Enriched Parquet Disk ]
数据流在架构中采用显式分层设计。计算任务根据策略声明周期自动路由至对应的执行池,历史回测与实时监控共享相同的信号定义库,从而消除了传统多套系统并行带来的指标不一致风险。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (tick-stock-panel) | 传统 Python 脚本拼凑 | SaaS 量化终端平台 | 商业券商行情软件 |
|---|---|---|---|---|
| 数据存储 | 本地 Parquet 零外部数据库 | CSV/SQLite 杂乱无章 | 云端专有数据库 | 闭源私有格式 |
| AI 集成 | 12 个 MCP 工具 + 61 API 端点 | 无原生 API,需逆向爬虫 | 平台内置沙箱黑盒 | 不支持开放集成 |
| 全市场扫描 | Polars 毫秒级内存并行向量化 | Pandas 单线程循环迭代 | 服务端限频排队计算 | 依赖本地客户端算力 |
| 私有部署 | Docker 单容器完全自托管 | 极度依赖开发者本地环境 | 无法私有化导出核心资产 | 纯客户端运行无后端控制 |
| 二次开发 | 开放契约化 API 与 Token 档位 | 无统一接口规范 | API 额度昂贵且受限 | 无法修改底层核心逻辑 |
表格中的技术对比表明,该项目在保持自托管数据主权的前提下,通过 MCP 协议向 AI 客户端暴露了完整的读写闭环,彻底打破了商业终端的数据孤岛与定制开发限制。
4. 手把手极客实操:从零构建最小闭环
通过 Docker 快速启动本地量化工作台,无需配置复杂的 PostgreSQL 或 Redis 等外部依赖组件。
# 克隆官方代码库到本地
git clone https://github.com/shy3130/tick-stock-panel.git
cd tick-stock-panel

# 配置环境变量文件,指定数据存储路径与 API 密钥
cp .env.example .env

# 使用 Docker Compose 启动单容器自托管实例
docker compose up -d --build
启动完成后,服务默认监听本地端口。以下是通过 Python 调用其开放 API 执行策略扫描的最小生产脚本:
import httpx

# 定义本地工作台 API 基础地址与访问令牌
API_BASE_URL = "http://localhost:8000/api/v1"
API_TOKEN = "your_generated_token_here"

headers = {
    "Authorization": f"Bearer {API_TOKEN}",
    "Content-Type": "application/json"
}

# 发起毫秒级全市场策略扫描请求
response = httpx.post(
    f"{API_BASE_URL}/screener/run",
    json={"strategy_id": "momentum_breakout_v1", "date": "2023-10-25"},
    headers=headers,
    timeout=30.0
)

# 解析返回的量化信号结构
if response.status_code == 200:
    result_data = response.json()
    print(f"扫描成功,触发标的数量: {len(result_data.get('signals', []))}")
else:
    print(f"API 调用失败,状态码: {response.status_code}, 错误信息: {response.text}")
执行上述脚本后,控制台将输出指定策略在目标交易日筛选出的股票信号集合。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在将该系统部署至生产或进行高频二次开发时,必须注意本地文件锁与并发写入的性能边界。Parquet 文件虽然提供了极高的压缩比与查询性能,但在多进程同时写入时可能引发文件句柄冲突。
⚠️ 避坑预警 [并发写入冲突]:在编写自定义数据同步脚本时,严禁多个定时任务同时对同一个日K或 Enriched Parquet 分区进行写操作。必须通过内部的任务调度管道串行化落盘动作。
大模型通过 MCP 触发写操作时,由于系统设置了默认的 120 秒超时确认卡机制,用户必须在前端界面及时点击确认,否则处于挂起状态的动作参数将自动作废。
⚠️ 避坑预警 [AI 动作超时失效]:当 AI 助手调用涉及生成策略或修改自选股的写操作工具时,请确保在前端控制面板的待办确认卡中于 120 秒内人工放行,否则自动化管道会因安全超时主动熔断该次变更。