1. 痛点突围:它究竟击穿了什么工程死穴?
大模型后训练的落地成本长期被基础设施绑架。团队在实际微调时往往需要耗费大量工时排查分布式环境配置、解决 SSH 隧道中断以及规避显存溢出错误。传统工具链对硬件显存的强硬要求,迫使开发者必须租用高昂的云端加速卡。Soup 直接重构了训练控制流,剥离了底层硬件配置的复杂度。开发者只需要编写单个 YAML 配置文件,即可在本地硬件上启动微调流水线。
💡 架构核心洞见:通过将冻结的基础模型移出显存并采用按需解码层流技术,Soup 重新定义了消费级硬件的算力边界。
2. 核心架构与底层数据流向解析
Soup 的执行核心在于将传统的全量显存驻留模式改造为流式调度。当训练任务触发时,系统并不将整个模型静态加载至 VRAM,而是将基础模型的权重固定在系统内存中,通过独创的层流机制每次向 GPU 推送单个解码器层。这种动态调度在保证数值计算精确度的同时,将显存占用压制在极低水平。
[ Config / YAML ] ---> [ CLI Parser ] ---> [ Layer Streaming Engine ]
                                                    │
                                                    ▼
[ RAM: Frozen Base Layers ] <--- (Batch Feed) ---> [ VRAM: 4GB GPU Buffer ]
v0.75.0 版本引入了严格的配置校验机制。当解析器遇到未知的配置键或拼写错误时,系统会立即终止运行并抛出异常,防止参数静默失效。同时,后端调度器对 MLX 框架进行了深度对齐,确保学习率调度器、权重衰减以及优化器名称在不同硬件后端上保持行为一致。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (Soup) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
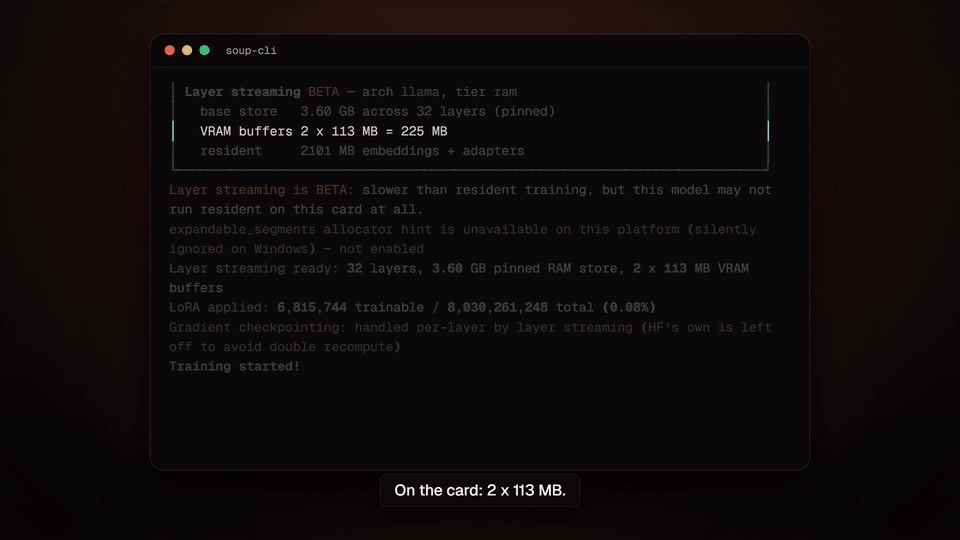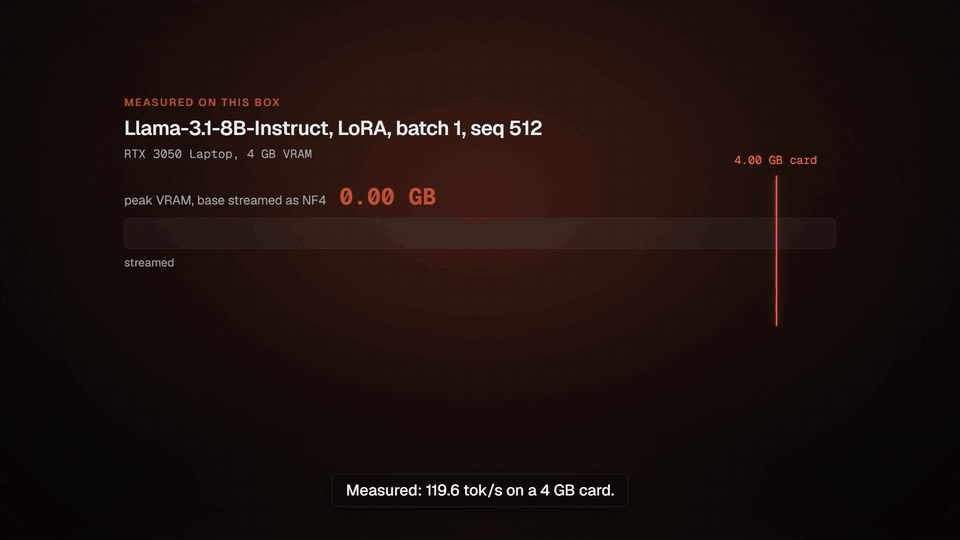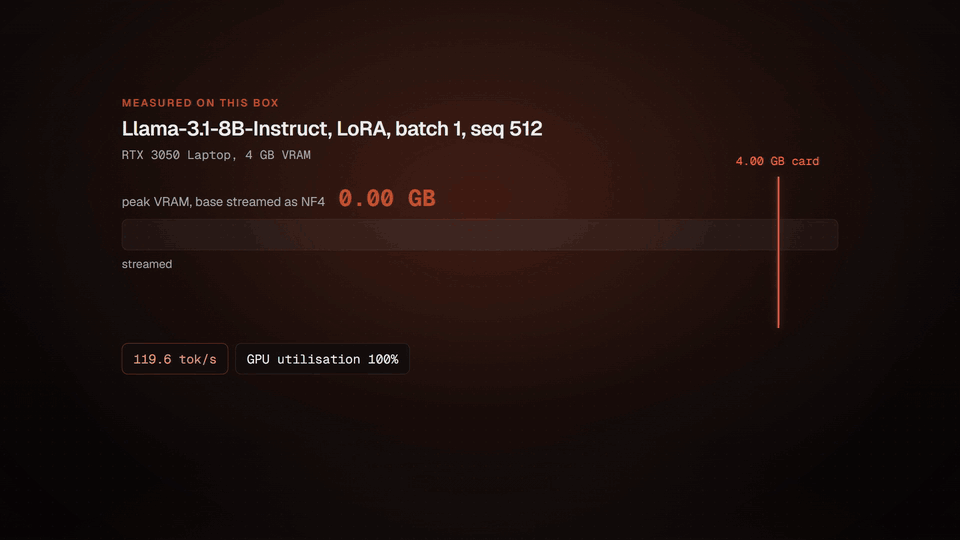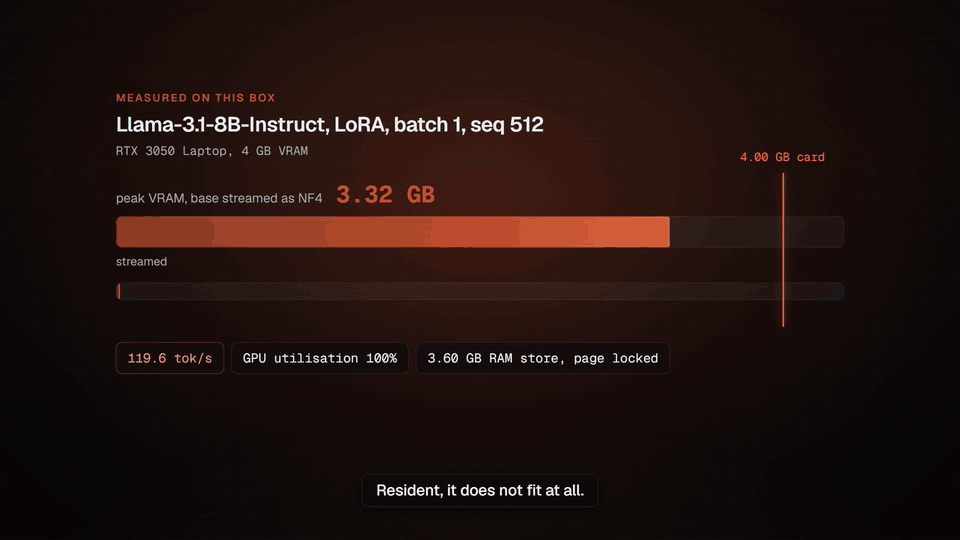
| 显存开销 | 3.32 GB (8B 模型) | 16 GB 以上 | 8 GB 至 12 GB | 显著降低硬件门槛,允许在笔记本端调试 |
| 配置复杂度 | 单文件 YAML | 多脚本拼接与环境变量 | 复杂 Web 控制台 | 消除配置地狱,实现分钟级冷启动 |
| 依赖链条 | 统一 CLI 与极简依赖 | 繁重的集群管理工具 | 分散的 Python 脚本 | 降低包冲突概率,保障环境稳定性 |
| 错误处理 | 强校验阻断未知键 | 静默忽略非法参数 | 运行时崩溃 | 提前暴露配置缺陷,杜绝无效训练 |
这套对比数据证明,Soup 在资源受限的边缘与本地场景中具有压倒性优势。它舍弃了臃肿的集群管理组件,将核心计算压缩在单机闭环之内。
4. 手把手极客实操:从零构建最小闭环
在本地环境中部署 Soup 并完成基础训练,只需执行明确的命令行指令。确保系统安装了 Python 3.10 至 3.12 版本。
# 安装包含训练组件的完整 CLI 工具包
pip install "soup-cli[train]"

# 初始化面向聊天场景的默认配置文件
soup init --template chat

# 启动本地单机微调流水线
soup train
执行 soup init 后,当前目录下会生成对应的 YAML 文件,开发者可以在其中调整学习率、批处理大小或启用层流开关。运行 soup train 后,系统会自动检测本地 GPU 硬件类型,加载量化权重,并在终端实时输出损失函数收敛曲线与吞吐速率。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在实际工程落地过程中,硬件异构与版本演进会带来特定的隐藏风险。必须提前识别并规避这些常见的架构陷阱。
⚠️ 避坑预警 [Python 版本兼容性]:Python 3.13 及以上版本会触发未经测试的 PyTorch 编译轮子,导致原生扩展在 Soup 运行前直接崩溃。生产环境必须严格锁定在 Python 3.10 至 3.12 之间。
⚠️ 避坑预警 [配置键拼写错误]:自 v0.75.0 起,任何未知的配置键均会导致加载失败并退出。老版本中因拼写错误而被静默丢弃的参数现在会直接引发异常,迁移旧项目配置时必须逐一核对字段名称。