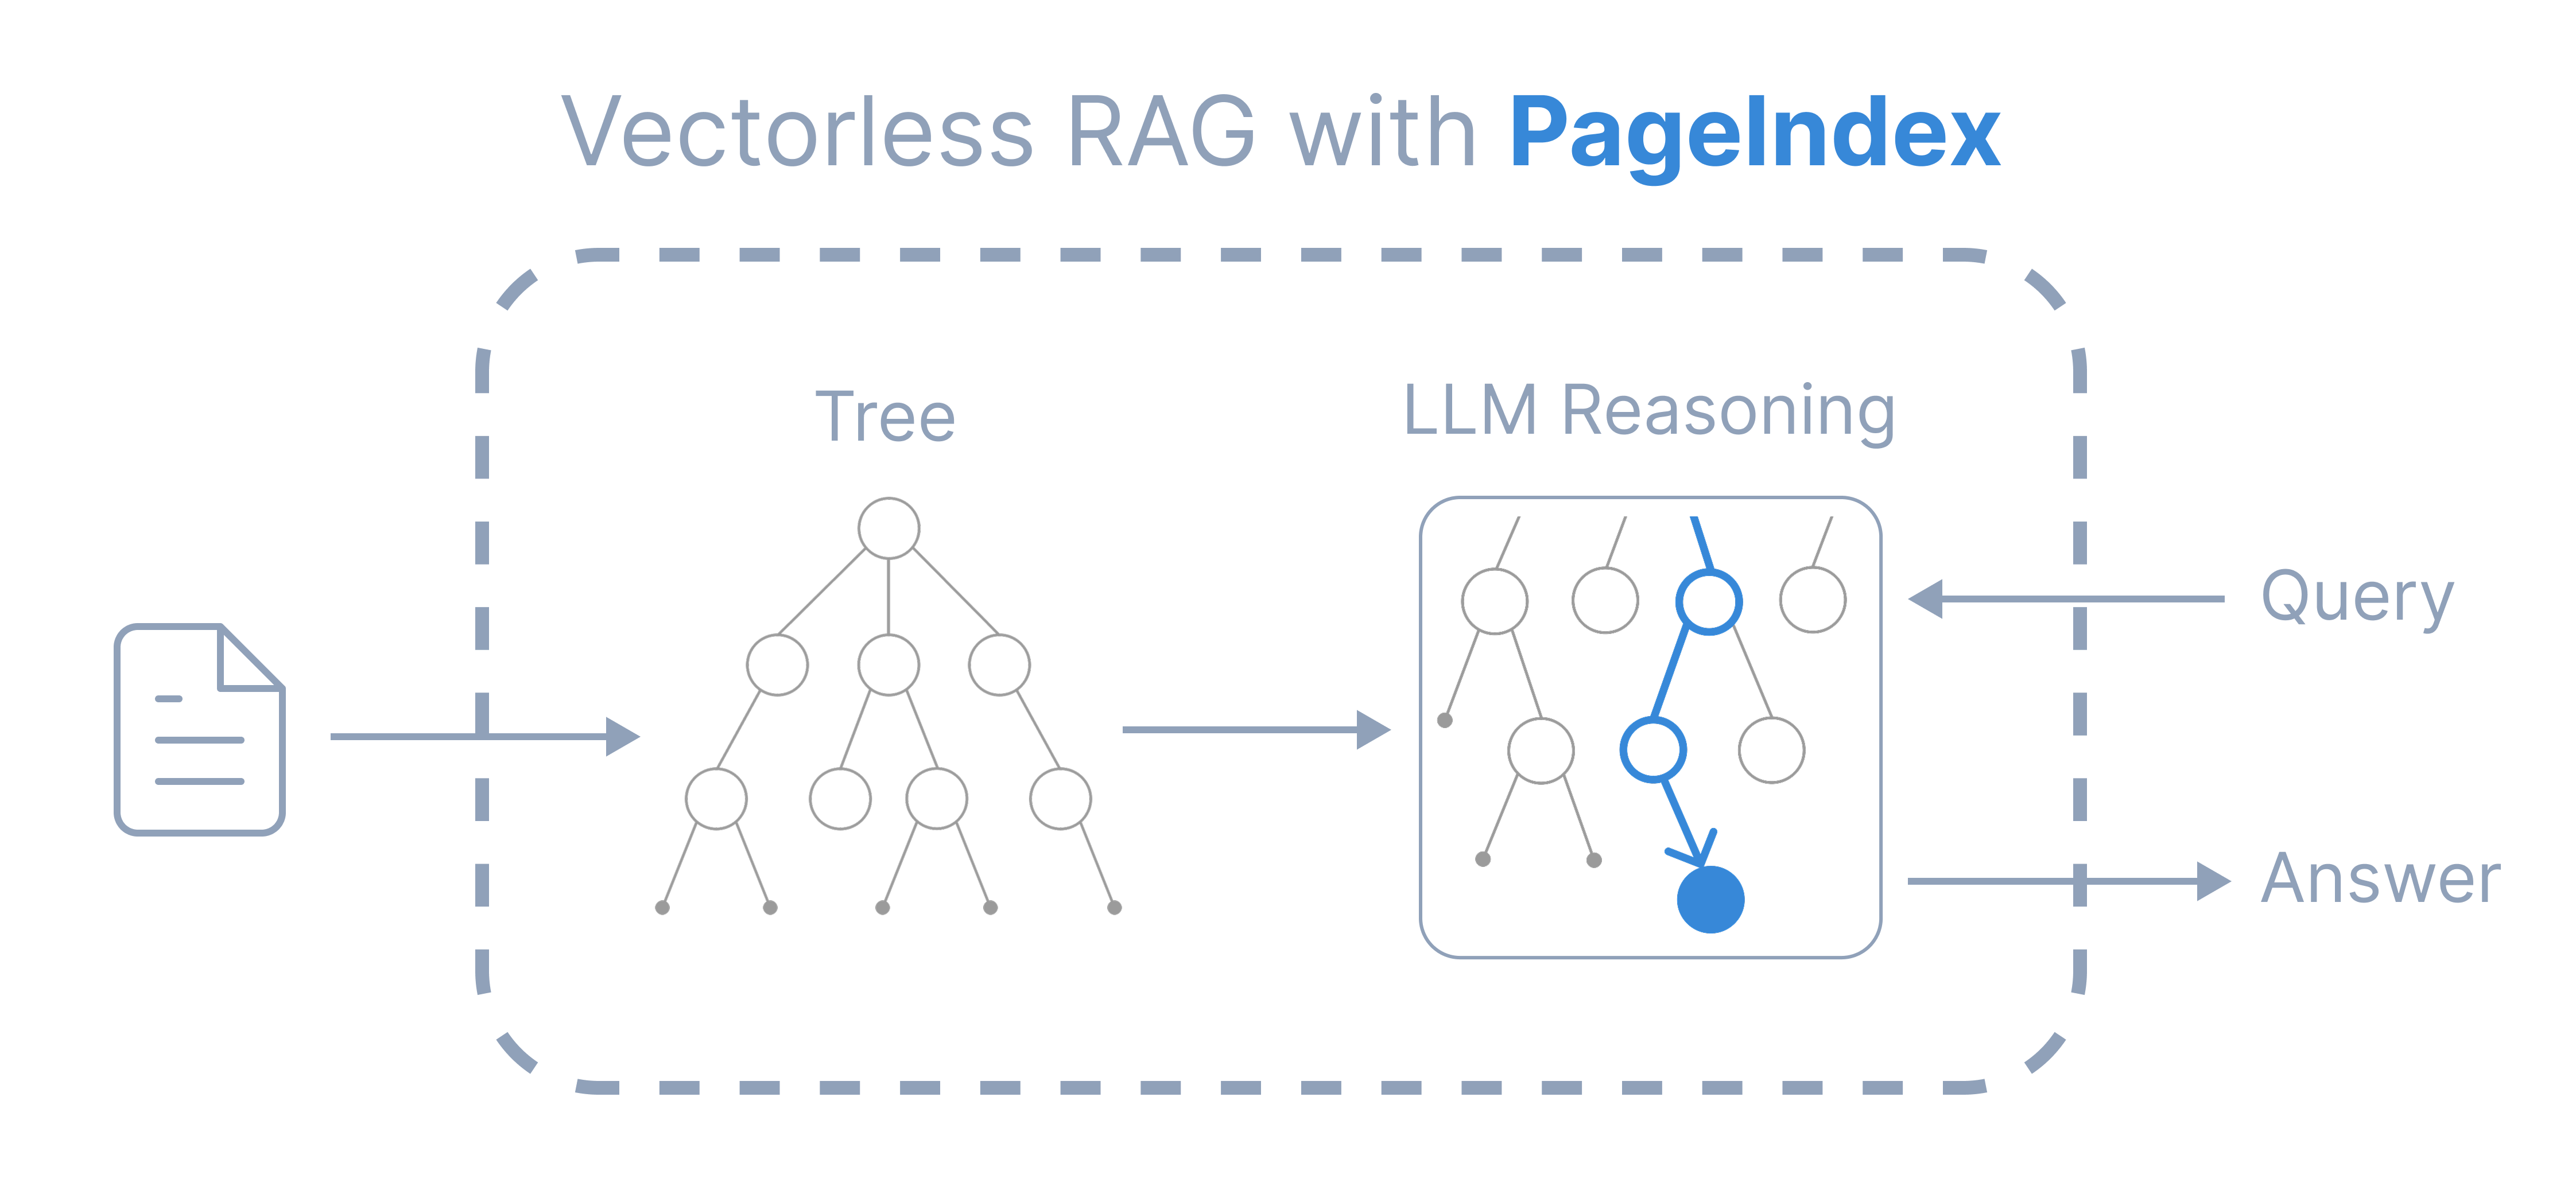
1. 痛点突围:它究竟击穿了什么工程死穴?
长文本检索系统在处理财报、法律卷宗以及技术手册时,向量数据库暴露出的匹配偏差正在消耗大量工程算力。系统依靠文本嵌入向量的余弦相似度输出匹配结果,忽略了专业文档对上下文的多步推理依赖。相似度计算无法捕捉实质性关联,导致检索结果常常返回语义相近但业务无关的片段。
PageIndex 采用的树状索引结构改变了这一检索逻辑。系统不将文档拆分为固定大小的文本块,而是直接生成具有层级结构的目录树。大模型在检索阶段扮演人类专家角色,遍历树节点并定位至具体章节。这种设计绕过了向量索引的黑盒状态,使检索路径具备显式引用依据。
💡 架构核心洞见:PageIndex 用显式树状结构替换了隐式向量空间,将检索过程降维成大模型在结构化目录中的路径推理问题,从根本上消除了分块带来的上下文边界撕裂。
2. 核心架构与底层数据流向解析
PageIndex 的运行链路分为索引构建与推理检索两个阶段。在索引阶段,系统解析 PDF 文件的视觉排版与标题层级,构建出文件级的树状索引。在推理阶段,客户端通过 SDK 提交查询请求,执行引擎调用大模型在树结构中进行多步路径导航。
[ PDF Document ] ---> [ Layout Parser ] ---> [ Tree Index Builder ]
                                                       │
                                                       ▼
[ Client / SDK ] ---> [ Agentic Chat Engine ] <---> [ Hierarchical Tree ]
索引构建过程不依赖重量级大模型,文档的结构特征主要由物理排版提取得出,索引模型仅负责概括和精炼节点内容。这种任务解耦使得树生成速度极快,百页文档可在数十秒内完成结构化转换,且成本控制在极低水平。聊天模型则承担高负载的推理任务,负责从树结构中逐层穿透并锁定目标信息源。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (PageIndex) | 传统实现范式 | 典型竞品方案 | 生产环境收益 | |---|---|---|---|---|> | 索引介质 | 层次化树状结构 | 向量数据库 (Milvus/Pinecone) | 纯大长上下文 (Gemini 1.5 Pro) | 消除向量空间噪声,降低存储开销 | | 检索机制 | LLM 树路径推理与代理导航 | 余弦相似度近邻检索 | 全文原始 Token 强行灌入 | 保证检索结果具备可追溯的代码级引用 | | 长文本支持 | 通过 PageIndex 文件系统扩展 | 受限于切片大小与 Top-K 拼接 | 受限于窗口上限与指数级注意力衰减 | 支持百万字级企业知识库稳定吞吐 | | 成本曲线 | 离线建树一次性付费,按需查询 | 高频向量索引更新与高维检索开销 | 每次请求消耗巨量输入 Token 费用 | 显著压降持续对话与批量问答的 API 账单 |
PageIndex 针对生产环境的工程痛点进行了针对性剪裁。它通过文件级树状索引层支持多文档关联检索,避免了传统方案在面对海量 PDF 时由于切片碎片化导致的上下文丢失。开发者无需维护复杂的向量索引生命周期,降低了底层基础设施的运维复杂度。
4. 手把手极客实操:从零构建最小闭环
开发者可通过 Python 客户端在本地环境中快速部署 PageIndex 运行时。系统支持本地离线模式,所有索引和检索均可在本地运行。
首先通过终端安装官方 SDK:
pip install -U pageindex
在生产脚本中初始化客户端并执行问答闭环:
import os
from pageindex import PageIndexClient

# 配置大模型 API 密钥
os.environ["OPENAI_API_KEY"] = "your-openai-key"

# 初始化 PageIndex 客户端
# index 参数指定用于构建树索引的模型,chat 参数指定用于检索聊天的模型
client = PageIndexClient(
    index="gpt-5.6-luna",
    chat="gpt-5.6-sol",
)

# 提交目标 PDF 文档并获取唯一文档标识
doc_id = client.submit_document("report.pdf")["doc_id"]

# 针对特定文档发起基于树路径推理的自然语言查询
answer = client.chat("What was the 2023 operating margin?", doc_id=doc_id)
print(answer)
运行上述脚本后,客户端会自动解析 PDF 的版面结构,在本地生成树状索引,并调用大模型完成节点搜寻与答案合成,输出带有明确引用位置的文本结果。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在将 PageIndex 引入高并发生产系统时,开发团队需要规避特定的架构陷阱。
⚠️ 避坑预警 [大模型选型错配]:切勿将高成本的顶级推理模型误配置为建树模型 (
index=)。树结构的生成高度依赖版面解析器提取的物理排版,基础模型足以胜任节点摘要任务。将昂贵模型用于建树会导致索引成本非线性飙升,且对检索准确率无实质提升。⚠️ 避坑预警 [冷启动延迟治理]:首次提交大体积 PDF 文件时,服务端需要执行版面分析与树节点摘要,百页以上文档会产生数秒至分钟级的建树耗时。生产系统必须将
submit_document移至异步任务队列执行,避免阻塞前端 API 的同步响应链路。