
1. 痛点突围:它究竟击穿了什么工程死穴?
在使用 Claude Code 或各类大模型命令行编程助手时,开发者最常遭遇的性能瓶颈在于上下文窗口的剧烈衰减。随着多轮对话与工具调用的深入,早期建立的项目依赖关系、架构决策和临时修复方案迅速被挤出 Token 窗口。这种设计迫使工程师在每次重启会话后重新输入大量背景信息,严重损耗开发吞吐率。
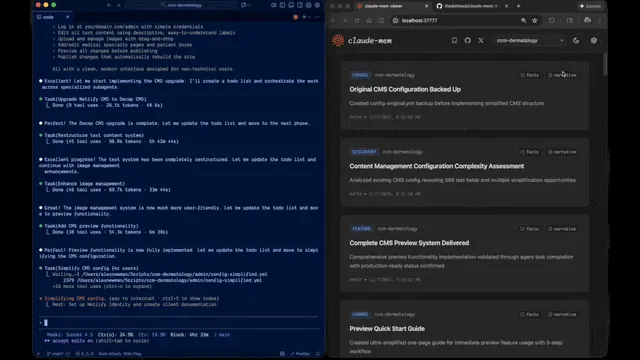
claude-mem 改变了这种即用即焚的状态机模式。它在宿主机本地部署观察者进程,自动捕获文件修改、终端报错和测试结果等工具观测数据,将原始交互流压缩为语义结构化的记忆片段。当新会话启动时,系统通过轻量检索将相关的历史演进注入上下文,彻底消除了频繁重建工程背景的繁琐开销。
💡 架构核心洞见:claude-mem 通过异步观测与增量记忆蒸馏,在保持命令行工具轻量特性的同时,外挂了具备跨会话持久化能力的分布式记忆后端。
2. 核心架构与底层数据流向解析
整个系统的工程实现遵循高内聚、低耦合的模块化设计。核心组件包含 IDE/CLI 挂钩、本地日志解析器、在线记忆网关以及向量检索引擎。系统并不直接修改宿主工具的底层通信协议,而是通过劫持工具事件流或监听本地聊天日志来实现观测数据的非侵入式采集。
[ CLI / IDE Client ] ---> [ Host Hook / Log Watcher ] ---> [ Local Parser ]
                                                                   |
[ Memory Gateway ] <--- [ Delta Compression Engine ] <-------------+
       |
       v
[ Anthropic / OpenRouter / Local Storage ]
以 Grok Bot 集成场景为例,由于宿主机本身缺乏完善的生命周期钩子,插件直接监听本地聊天日志文件。对 decision、bugfix 以及 security_alert 等高价值针尖观察点,引擎执行正则过滤并将结构化数据增量追加到对应的月度日志目录。这种设计规避了盲目全量记录造成的存储膨胀与 Token 污染。
系统支持灵活的存储提供商切换。用户在完成浏览器端安全验证后,可自由选择官方托管服务、OpenRouter 密钥或 Google Gemini 密钥。对于离线或受监管的安全隔离环境,整个管线支持退化为纯本地运行模式,保障敏感代码资产不出内网。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (claude-mem) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 记忆持久化 | 跨会话自动压缩蒸馏 | 会话结束立即清空 | 手动维护 Markdown 笔记 | 消除重复背景输入成本 |
| 采集机制 | 自动化 Hook 与日志监听 | 完全依赖手动 Prompt 喂送 | 静态 RAG 检索本地源码 | 实时捕获决策过程与 Bug 修复 |
| 资源消耗 | 本地常驻极轻量进程 | 无额外后台进程 | 高频全量索引服务 | 内存与 CPU 开销微乎其微 |
| 接入成本 | 单行 npm 命令极速完成 | 繁琐的源码侵入式修改 | 复杂的向量数据库集群部署 | 1分钟内接入生产流水线 |
| 隐私合规 | 支持完全离线与私有 Key | 依赖单一闭环厂商策略 | 数据必须上传第三方托管 | 满足企业级安全合规基线 |
表格对比揭示了工程设计的取舍权衡。claude-mem 放弃了动辄部署独立向量数据库的重量级架构,转而采用面向代理优化的结构化日志压缩方案,在极低的资源占用下实现了精准的上下文检索命中率。
4. 手把手极客实操:从零构建最小闭环
在日常开发环境中部署该持久化记忆系统,只需通过 npm 运行安装命令。该过程会自动完成 IDE 插件注册与本地环境探测。
# 执行全局安装并自动配置当前主导 IDE 环境
npx claude-mem install

# 若在无头服务器或 CI 环境中跳过交互式登录,可显式指定提供商
npx claude-mem install --provider host --no-interaction

# 针对特定非标准 IDE(如 OpenCode)进行显式安装
npx claude-mem install --ide opencode
安装程序完成注册后,会在终端引导用户通过魔法链接登录验证。登录成功将激活 30 天免费试用额度,系统随后自动生成专属的记忆持久化密钥。若在自动化流水线或隐私敏感场景中运行,可直接通过环境变量固化配置。
// 生产环境配置初始化示例
import { ClaudeMemEngine } from 'claude-mem';

const memoryConfig = {
  provider: process.env.CLAUDE_MEM_PROVIDER || 'host',
  onlineOptIn: process.env.CLAUDE_MEM_ONLINE_OPTIN === 'true',
  awarenessEnabled: process.env.CLAUDE_MEM_GROK_BOT_AWARENESS_ENABLED !== 'false',
  storagePath: './memory/log'
};

// 初始化持久化记忆引擎实例
const engine = new ClaudeMemEngine(memoryConfig);
await engine.bootstrap();
运行上述初始化脚本后,系统将在本地工作目录生成结构化的记忆日志分片。每次启动编码助手时,最近的架构决策和修复记录将自动作为系统提示词的补充边界条件载入。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在高并发或多终端并行开发的复杂工程实践中,由于多个代理实例同时向本地日志目录写入观测数据,可能引发轻微的文件锁竞争或日志交错写入现象。开发团队应当合理规划不同工作树的隔离路径。
⚠️ 避坑预警 [多进程并发写入冲突]:在同一仓库拉取多个 Git 工作树并同时运行 Claude Code 时,默认的本地日志监听器可能将交错的观测事件写入同一目标文件。解决方案是在多实例并行时通过环境变量指定独立的记忆命名空间。
⚠️ 避坑预警 [敏感信息隐私泄漏]:自动观测机制会无差别捕获终端工具的输入输出,若测试用例中包含硬编码的生产数据库密码或 API 密钥,将被如实记录进本地结构化日志。建议在正式部署前完善全局敏感词过滤规则,或强制启用本地密钥脱敏中间件。