1. 痛点突围:它究竟击穿了什么工程死穴?
金融交易领域的大模型落地长期卡在幻觉与数据穿越两个死穴上。传统的单体提示词方案将宏观、财报解析、社交媒体情绪全部塞进单一上下文窗口,导致注意力机制失效,最终输出充满噪音的买卖指令。同时,开源回测系统经常无意间读取到决策日之后的未来财报或新闻,造就虚假的纸面收益率。TradingAgents 采用多智能体图谱编排范式,将分析师团队、风控部门与交易员进行物理级模块拆分,并通过点时间(Point-in-Time)数据过滤契约,强制所有智能体仅能访问决策时间戳之前发布的真实历史数据。
💡 架构核心洞见:用分布式图状态机替代单一黑盒提示词,将金融决策拆解为可独立验证的确定性流水线。
2. 核心架构与底层数据流向解析
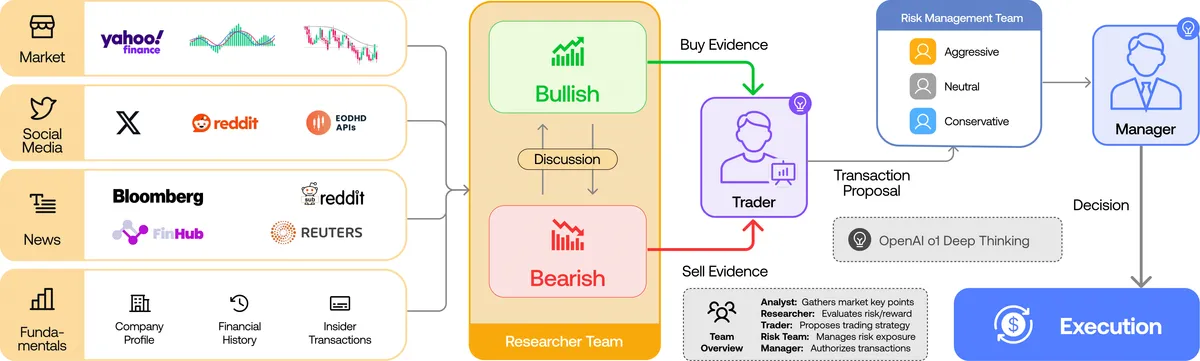
TradingAgents 的底层核心由 LangGraph 状态机驱动,通过模块化路由分发市场数据。整个框架在运行时维护统一的决策上下文,各专业智能体并行或串行消费指定数据源,最终汇聚至投资组合经理与交易员完成博弈。
[ CLI / Config ] ---> [ Point-in-Time Router ] ---> [ Memory & Checkpoint Layer ]
                               │
        ┌──────────────────────┼──────────────────────┐
        ▼                      ▼                      ▼
[ Fundamentals ]      [ Sentiment Analyst ]   [ Technical Analyst ]
        │                      │                      │
        └──────────────────────┼──────────────────────┘
                               ▼
                    [ Risk Management Team ]
                               │
                               ▼
                    [ Execution & Trade Log ]
基本面分析师接入 SEC EDGAR 原始财报解析,情绪分析师抓取 Twitter 与 Reddit 社交噪音,技术分析师计算 MACD 与 RSI 指标。所有模块的中间输出通过持久化决策日志(Decision Log)写入磁盘,支持任意节点的故障断点恢复与多轮迭代推演。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (TradingAgents) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 架构范式 | 多智能体图状态机 (LangGraph) | 单体 LLM 串行 Prompt | 规则引擎加单模型 | 模块职责单一,避免注意力衰减 |
| 数据防穿越 | 点时间 (Point-in-Time) 严格契约 | 全量实时数据读取 | 静态 CSV 离线文件 | 杜绝未来函数,回测结果具备真实可信度 |
| 凭证接入 | 原生支持 ChatGPT Plus/Pro 授权 | 仅支持高昂 API 额度消耗 | 绑死单一商业闭源 API | 大幅压缩大模型调用运维成本 |
| 状态持久化 | 支持 CLI 检查点恢复与断点续跑 | 内存态临时存储,崩溃即丢失 | 无状态无日志记录 | 支撑长周期复杂回测与分布式调试 |
TradingAgents 放弃了依赖单一 API 调用的昂贵老路,允许开发者通过 ChatGPT Plus 或 Pro 账户凭证直接运行,降低了高频、多轮智能体辩论的 Token 账单门槛。
4. 手把手极客实操:从零构建最小闭环
在本地开发环境中部署 TradingAgents 需要 Python 3.10 及以上版本。通过源码安装并配置好基础运行依赖,即可启动无需交互确认的自动化 CLI 决策流。
# 克隆官方代码库
git clone https://github.com/TauricResearch/TradingAgents.git
cd TradingAgents

# 安装核心依赖包及开发套件
pip install -e .

# 配置环境变量,指定 OpenAI 或兼容端点密钥
export OPENAI_API_KEY="sk-your-api-key-here"

# 运行指定股票代码与日期的自动化分析流水线
python -m tradingagents.main --ticker AAPL --date 2026-10-24
运行成功后,系统会在本地生成单页 HTML 综合分析报告,包含基本面评分、技术指标走向、情感倾向读数以及风控团队的最终交易决策结论。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
高并发场景下直接调用多个大模型进行分析会遭遇严重的网络吞吐瓶颈。Yahoo 财经数据源不定期限流或接口变更为常态,生产环境必须为网络请求配置多级代理与指数退避重试策略。
⚠️ 避坑预警 [数据源限流降级]:Yahoo 财经新闻流失效时,系统会回退至 Yahoo 搜索抓取公司动态。若未提前配置正确的网络出口代理,高频请求将直接触发 IP 封禁,导致整个分析图谱中断。
⚠️ 避坑预警 [Token 消耗失控]:多智能体并发讨论阶段会产生大量的内部对话日志。若未在配置文件中合理限制模型调用温度与最大 Token 数量,单次交易决策的 API 成本可能超出预期数倍。