
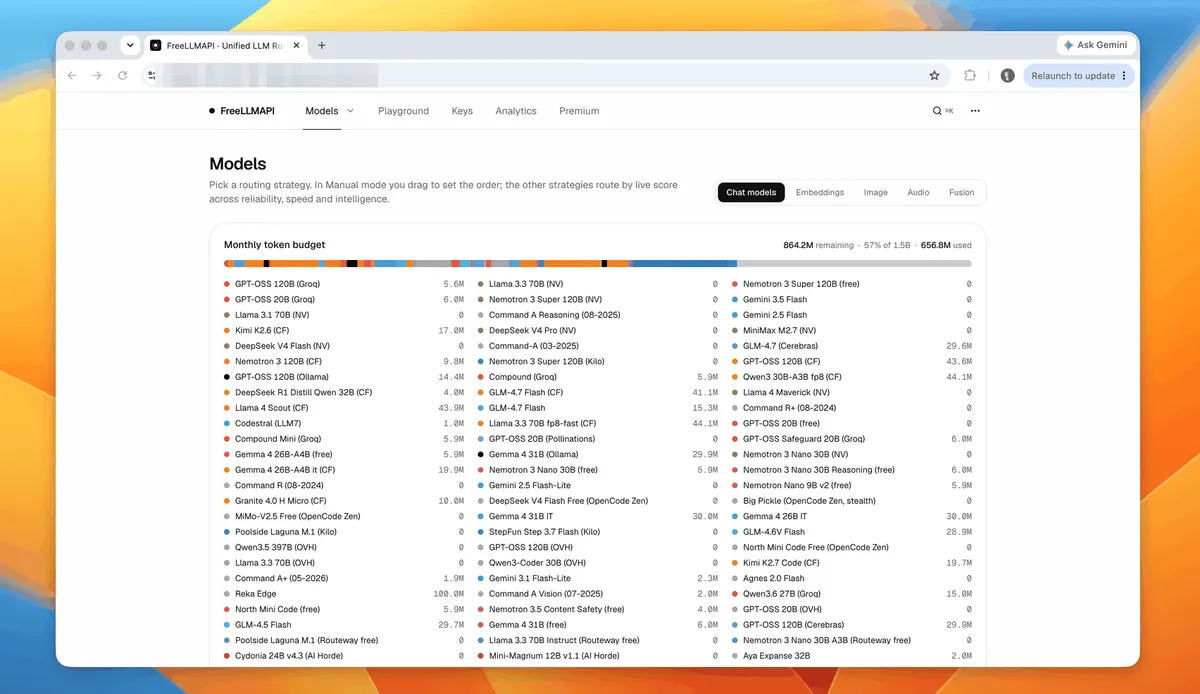
1. 痛点突围:它究竟击穿了什么工程死穴?
当前各大 AI 实验室频繁发放免费推理配额,但碎片化管理带来的维护成本极其高昂。开发者为了零成本白嫖这些资源,必须对接三十多套完全不同的 SDK、维护三十多套不同的 API Key 轮换策略、处理三十多套截然不同的速率限制与错误码。任何一个上游服务触发 429 频控,整个自动化流水线就会直接中断。FreeLLMAPI 放弃了手写硬编码的聚合代理路线,选择在本地网关层引入统一的 OpenAI 兼容端点。它通过动态拉取签名模型目录,将客户端发出的标准请求按可用配额实时分发至延迟最低的提供商,当当前节点触发频率上限时,执行引擎在毫秒级自动把流量压向下一个后端,彻底屏蔽了底层供应商频繁更迭接口契约的运维痛苦。
💡 架构核心洞见:FreeLLMAPI 的本质是一个去中心化的智能负载均衡器,它把零散的免费算力池转化为一条高可用的高并发推理流水线。
2. 核心架构与底层数据流向解析
FreeLLMAPI 的运行时由凭证管理器、签名目录同步模块、路由决策内核与协议适配层紧密交织。客户端通过标准 OpenAI SDK 发起请求,网关层首先解析并匹配当前负载最优的提供商端点。密钥在本地磁盘采用加密存储,确保多租户或多设备环境下的凭证安全。目录同步服务从远程权威源拉取包含最新模型状态的签名压缩包,使本地网关在不执行 git pull 的前提下实时感知新模型上线与配额调整。
[ OpenAI Client / CLI ] ---> [ Gateway Proxy Layer ] ---> [ Local Key Vault ]
                                      │
                                      ▼
                         [ Signed Catalog Sync Engine ]
                                      │
                                      ▼
                      [ Dynamic Fallback Execution Router ]
协议适配器负责抹平各大厂商返回流(Stream)格式的微妙差异,将各异的 SSE 响应实时转换为标准 ChatCompletionChunk。当目标提供商抛出速率限制异常时,路由决策内核依据当前每键使用量配额(per-key usage quota),瞬时剥离故障节点并将上下文重新投递至备用厂商,消除上游限流引发的静默丢包。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (freellmapi) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 接口协议兼容度 | 原生 OpenAI 契约全对齐 | 手写多厂商 SDK 适配层 | 部分对齐,需改动请求体 | 业务代码零修改直接热切换 |
| 额度失效响应 | 自动降级与多活无感切换 | 手动捕获 429 异常重试 | 静态负载均衡,容灾差 | 保证高并发任务持续高吞吐 |
| 模型目录更新 | 远程签名目录自动热更新 | 每次强依赖源码版本发布 | 手动维护配置文件列表 | 告别持续集成与手动更新维护 |
| 凭证存储安全 | 本地加密多 Key 隔离管理 | 明文保存在配置文件或环境变量 | 远端托管存在数据泄露风险 | 保护商业代码与 API Key 安全 |
这套技术选型彻底剥离了上游服务变动带来的系统脆弱性。传统多厂商集成要求研发团队为每个模型维护专属的调用分支,而该项目用统一的路由契约锁定了上游异构性,显著降低了多模型混用的工程重构成本。
4. 手把手极客实操:从零构建最小闭环
以 Docker Compose 部署本地网关并使用 Python 客户端发起请求为例。首先克隆仓库或准备运行环境,编写服务编排配置。
version: '3.8'
services:
  freellmapi:
    image: ghcr.io/tashfeenahmed/freellmapi:latest
    ports:
      - "8080:8080" # 将本地 8080 端口映射至网关服务
    environment:
      - ENCRYPTION_KEY=your_secure_local_encryption_key_here # 用于本地凭证加密的密钥
    volumes:
      - freellmapi_data:/app/data # 持久化加密存储的 API Key 与用量统计
volumes:
  freellmapi_data:
启动容器后,使用标准 OpenAI Python 库测试调用链路。依赖安装命令:pip install openai。
import os
from openai import OpenAI

# 初始化客户端,指向本地 FreeLLMAPI 网关地址
client = OpenAI(
    base_url="http://localhost:8080/v1",
    api_key="your_local_gateway_master_key"
)

# 发起标准聊天补全请求,网关会自动路由至当前可用配额最多的免费提供商
response = client.chat.completions.create(
    model="auto", # 使用 auto 标记让网关动态挑选最优模型
    messages=[
        {"role": "system", "content": "You are an elite systems architect."},
        {"role": "user", "content": "Explain zero-copy memory mechanics in modern kernels."}
    ],
    temperature=0.2,
    stream=True
)

# 实时流式消费推理输出
for chunk in response:
    if chunk.choices[0].delta.content is not None:
        print(chunk.choices[0].delta.content, end="", flush=True)
运行命令:python test_gateway.py。
预期输出应直接打印出由当前后端免费模型生成的结构化文本流,且终端无任何上游厂商限流报错。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
生产环境对接时,免费额度的统计延迟与并发竞争是导致服务抖动的常见诱因。由于多家厂商的配额计算采用异步计数桶,高频并发写入可能导致本地用量统计与云端实际扣减存在数十毫秒的偏差。
⚠️ 避坑预警 [配额滞后与突发 429]:多实例横向扩展时,若多个网关节点共享同一个加密凭证文件但未同步限流状态,极易在短时间内触发单一厂商的全局 IP 频控。建议在生产集群中为单节点配置独立的子账号 Key,或者启用网关内置的分布式 Redis 状态同步后端。
⚠️ 避坑预警 [冷启动模型路由抖动]:当调用未指定具体模型名称而使用
auto策略时,网关在初次加载冷启动模型时可能带来 100ms 至 300ms 的额外首包延迟。对延迟极为敏感的实时交互场景,应当在请求参数中直接锁定具体模型家族(如groq/llama-3.3-70b),规避动态匹配带来的路由计算开销。