1. 痛点突围:它究竟击穿了什么工程死穴?
现代全栈开发与数据库运维面临严重的客户端工具分裂。工程师往往需要同时运行多个巨型桌面应用来分别管理 PostgreSQL、Redis、MongoDB 以及各类云原生向量库。传统管理软件动辄数百兆甚至上吉的 Electron 架构,在日常多任务挂载时持续吞噬系统物理内存。与此同时,当开发者试图将大语言模型引入数据库交互流程时,繁琐的插件生态与高昂的 API 代理配置拉高了本地自动化门槛。
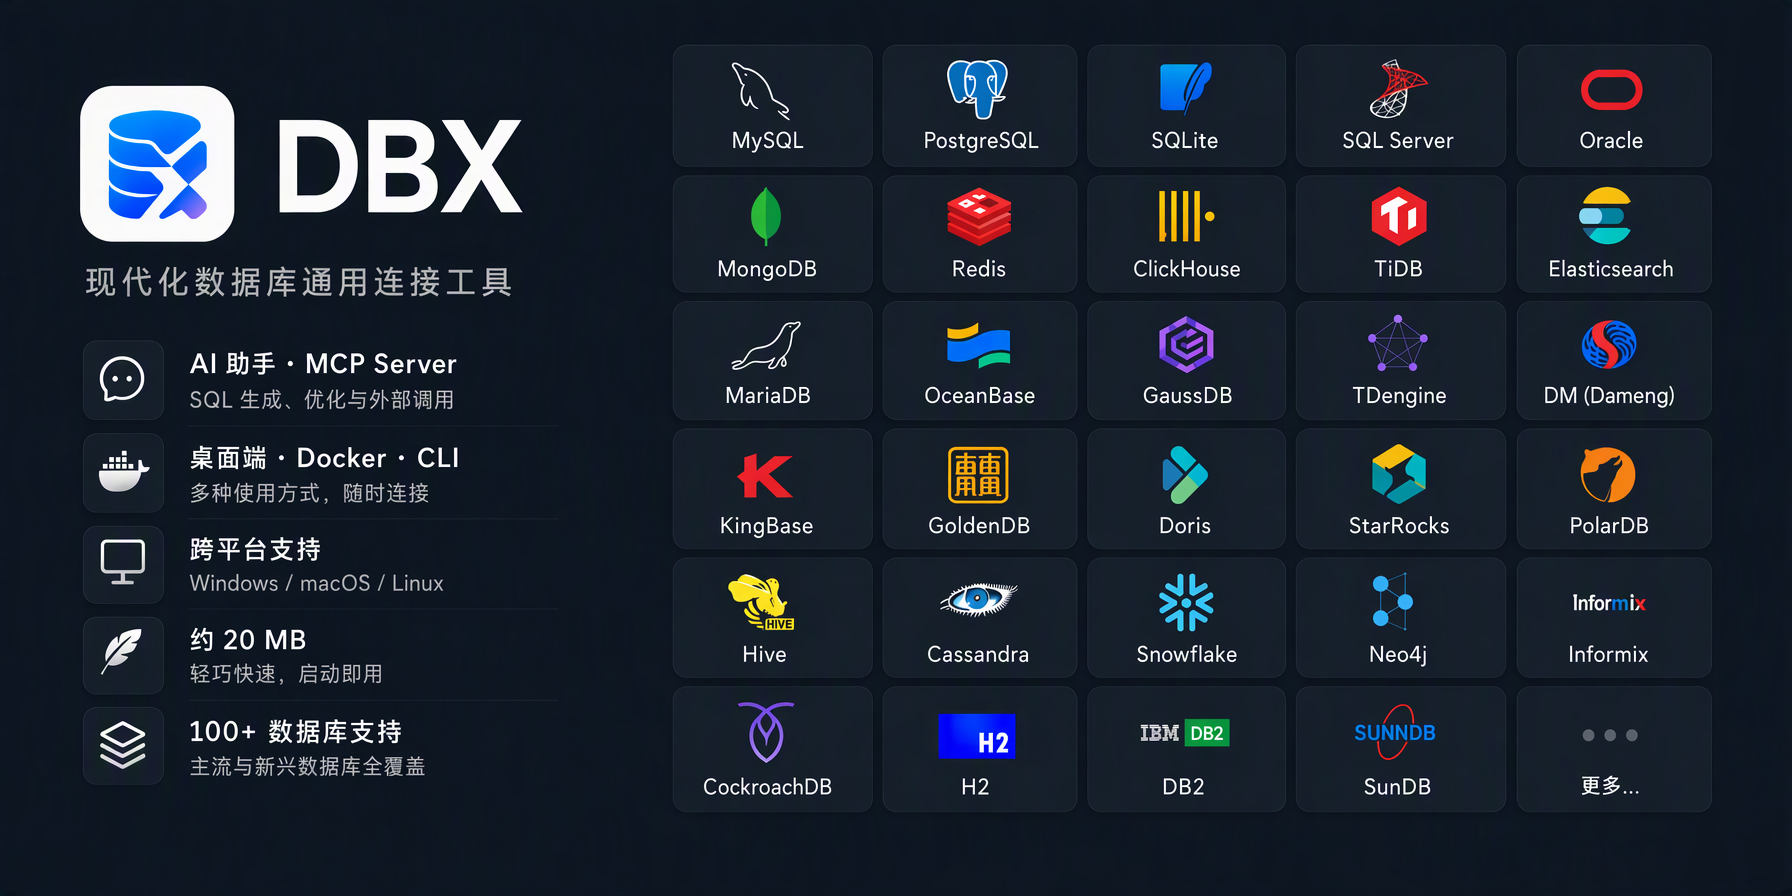
DBX 直接采用 Rust 语言从零构建,将 100 多种数据库的连接、解析与交互逻辑全部压编进一个 25MB 的单一二进制文件内。它舍弃了沉重的运行框架,通过直接调用底层驱动与异步 I/O 轮询,在冷启动速度与内存占用率上实现降维打击。项目同时内置 AI 助手与 MCP(Model Context Protocol)服务,直接在协议层建立大模型对底层数据的原生操作管道。
💡 架构核心洞见:通过 Rust 零成本抽象与单一二进制分发,DBX 把传统重型数据库客户端降维成便携的嵌入式系统组件,彻底消除了多端工具链的资源冗余。
2. 核心架构与底层数据流向解析
DBX 的整体拓扑结构围绕“轻量统一网关与多端按需渲染”展开。核心守护进程运行在统一的 Rust 异步运行时之上,通过一套高度解耦的适配器层对接上百种异构数据库协议。当用户通过桌面客户端、Docker 容器或命令行 CLI 发起查询时,请求直接交由协议解析器进行 AST(抽象语法树)生成与安全边界校验。
[ Desktop / Docker / CLI ] ---> [ Protocol Gateway & Parser ] ---> [ Unified Adapter Layer ]
                                             │
                                             ▼
                                [ MCP Server & AI Assistant ] ---> [ 100+ Target Databases ]
在与大模型交互的链路中,内置的 MCP Server 充当了标准化的上下文注入器。大模型无需额编写复杂的数据库驱动胶水代码,而是直接通过 MCP 协议将自然语言转化为确定性的结构化查询语句,由动态执行引擎分发至目标数据库。这种架构设计确保了 AI 生成指令的强沙箱约束,杜绝了无限制全表扫描和高危删除操作的发生。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (dbx) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 内存占用 | 常驻约 25MB ~ 40MB | 300MB ~ 1.5GB (Electron) | 150MB ~ 400MB (Java/JVM) | 极低系统负载,容器多开无压力 |
| 分发形态 | 单一静态二进制 / 极简 Docker | 多平台巨型安装包 | 复杂环境依赖链 (Node/Python) | 零依赖部署,CI/CD 流水线秒级集成 |
| 协议支持 | 100+ 关系型、NoSQL、时序及向量库 | 仅限主流 3-5 种常见数据库 | 20-50 种部分开源支持 | 统一开发工具链,告别频繁切换 |
| AI 深度集成 | 原生内置 MCP 服务端与本地助手 | 依赖第三方插件与外部代理转发 | 无内置 AI 或需购买高价商业授权 | 结构化自然语言交互,研发效率跃升 |
表格数据清晰表明,基于 Rust 的编译期优化与精简依赖策略,使 DBX 在资源消耗与扩展面上完全超越了传统 Electron 或 JVM 架构的沉重客户端。开发团队无需在多款专用管理工具之间反复横跳。
4. 手把手极客实操:从零构建最小闭环
在生产服务器或本地工作站部署 DBX 的 CLI 与守护进程,首先确保系统已安装基础编译环境或直接拉取预编译版本。以下通过官方推荐的容器化与直接运行路径完成最小化闭环搭建。
# 通过 Docker 快速拉取并启动 DBX 后端网关与 MCP 服务端
docker run -d \
  --name dbx-server \
  -p 8080:8080 \
  -v dbx_data:/root/.local/share/dbx \
  ghcr.io/t8y2/dbx:latest \
  --bind 0.0.0.0:8080 --mcp-enable

# 配置本地 CLI 客户端连接目标 PostgreSQL 实例
dbx connection add \
  --name prod-pg \
  --driver postgres \
  --host 127.0.0.1 \
  --port 5432 \
  --user admin \
  --database main_db

# 验证 AI 辅助自然语言查询管道是否通畅
dbx query --ai "展示最近 10 条活跃用户的注册时间与邮箱前缀"
执行上述指令后,Docker 容器将在后台建立常驻服务,CLI 客户端通过加密通道向守护进程发起结构化请求,预期输出将直接在终端以高性能表格或 JSON 流返回大模型转译后的安全 SQL 执行结果。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在生产环境或高并发集群中推进 DBX 部署时,必须对底层网络拓扑与资源配置采取谨慎策略。首要问题在于高强度 MCP 并发请求对本地连接池的瞬时冲击。
⚠️ 避坑预警 [连接池耗尽]:当多客户端通过 MCP 服务并发触发大模型自然语言批量检索时,若未合理配置后端数据库的
max_connections与 DBX 的连接复用池大小,极易引发too many clients already异常。建议在启动参数中显式限定--pool-max-size=20并开启长连接维持。
另一个不可忽视的隐患涉及长期运行中的内存碎片累积。尽管 Rust 内存安全性极高,但在处理超大数据集导出或复杂 ER 图渲染时,桌面端可能会出现瞬时内存峰值。
⚠️ 避坑预警 [大结果集内存溢出]:在无限制查询百万级表格时,严禁直接在桌面端加载全量数据网格。必须通过 CLI 或分页参数启用流式游标(Cursor Fetch),并在配置文件中设置
--max-row-limit=5000的硬性安全阈值,防止单次大查询击穿本地内存。