
1. 痛点突围:它究竟击穿了什么工程死穴?
当前在 Apple Silicon 设备上部署本地大模型时,开发者频繁遭遇的性能瓶颈在于标准推理框架的串行效率低下。以主流的 mlx-lm 为代表的方案在处理编码代理(Coding Agents)高频的多轮次工具调用时,KV 缓存重复计算、长上下文切换延迟以及流式输出吞吐不足等缺陷极大地拖慢了交互节奏。Rapid-MLX 绕过了传统的通用层包装,直接在底层针对苹果 M 系列芯片的内存统一架构进行流水线重构。它不仅引入了连续批处理(Continuous batching)与投机解码(Speculative decoding),还针对各类复杂工具调用语法进行了定向优化,从而将本地大模型推理的每秒生成 Token 数推向了硬件极限。
💡 架构核心洞见:通过将投机解码策略作为默认执行路径并内置 27 种工具解析器,Rapid-MLX 成功把本地推理服务器从“玩具级沙箱”拉入了“生产级代理”的工业竞技场。
2. 核心架构与底层数据流向解析
Rapid-MLX 在架构设计上高度解耦了解析层、内存管理层与执行引擎。客户端通过标准 OpenAI 或 Anthropic 兼容端点发送请求后,网关层立即通过模块化的 Parser 识别工具调用结构,随后请求进入内存层进行 Radix 前缀匹配与状态快照恢复。
[ Client / CLI ] ---> [ Gateway / Tool Parsers ] ---> [ Radix Memory Layer ]
                                                               │
                                                               ▼
                      [ Dynamic Execution Engine (MTP + Lookup) ]
执行引擎的核心竞争力来自于双轨制投机解码(多 Token 预测与提示词查找),这使得模型在处理结构化代码生成任务时能够并行吞吐多个候选 Token。同时,内存层将历史 Prompt 的 KV 缓存持久化至本地磁盘,在服务重启时直接恢复内存映射,消除了大模型重新加载与预热的等待开销。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (Rapid-MLX) | 传统实现范式 (mlx-lm) | 典型竞品方案 (Ollama) | 生产环境收益 |
|---|---|---|---|---|
| 推理引擎 | Apple MLX 原生底层 | Apple MLX (mlx_lm.server) |
GGML / GGUF 混合引擎 | 榨干统一内存带宽极限 |
| 并发控制 | 连续批处理 (Continuous Batching) | 单任务串行或基础队列 | OLLAMA_NUM_PARALLEL 参数限制 |
多代理并发请求不阻塞 |
| KV 缓存策略 | 内存 Radix 树 + 磁盘持久化快照 | 纯内存临时缓存 | 上下文重用但缺乏持久化 | 服务重启零冷启动加载延迟 |
| 工具调用解析 | 内置 27 个专项解析模块 | 依赖模型分词器显式声明 | 社区标准兼容子集 | 彻底消除代理工具解析崩溃 |
横向技术指标表明,Rapid-MLX 在保留 MLX 生态对 Safetensors 权重完美支持的同时,补齐了 Ollama 在苹果芯片上的并发短板,并且在工具解析的鲁棒性上超越了标准 mlx-lm 的弱类型映射。
4. 手把手极客实操:从零构建最小闭环
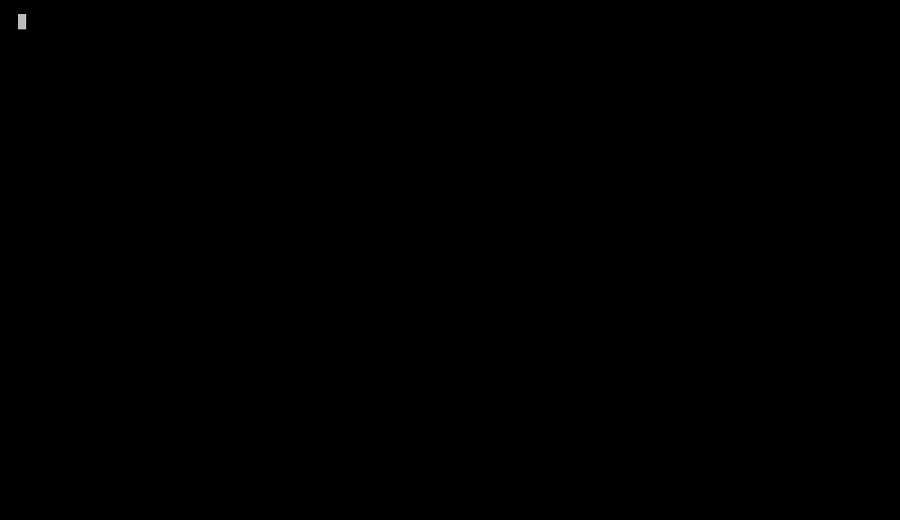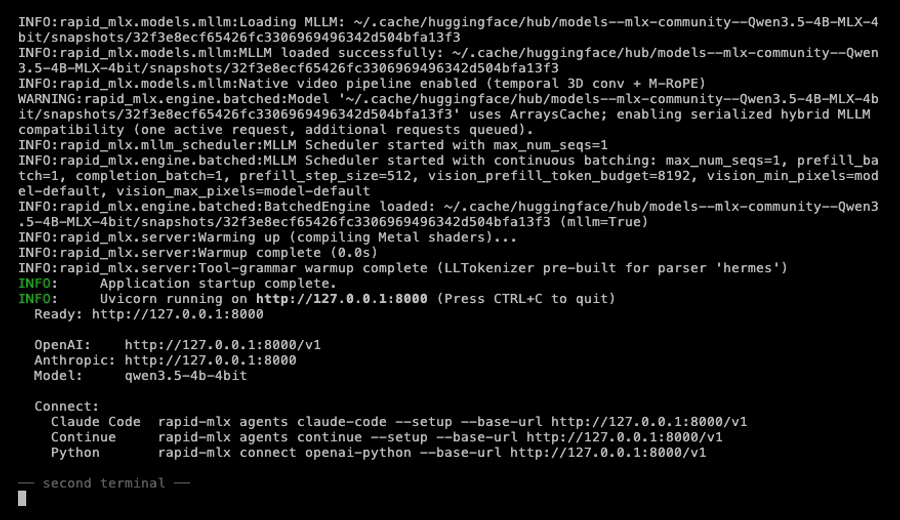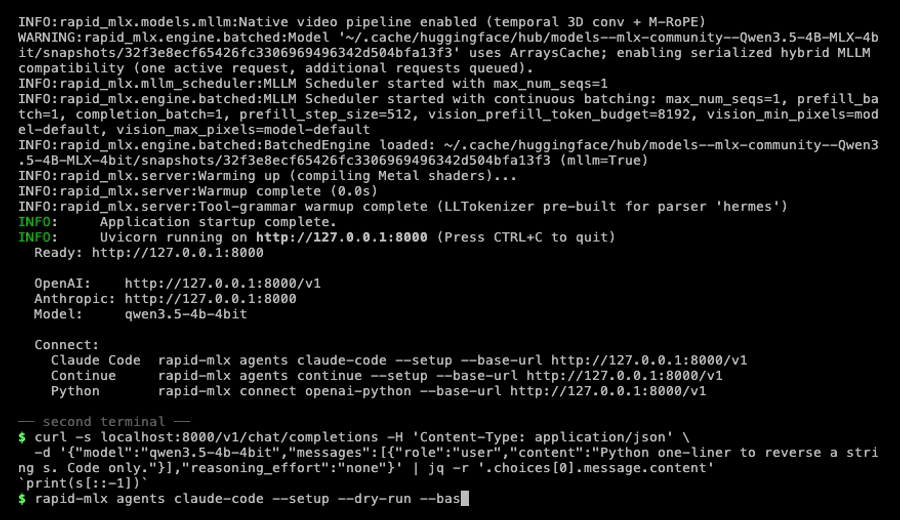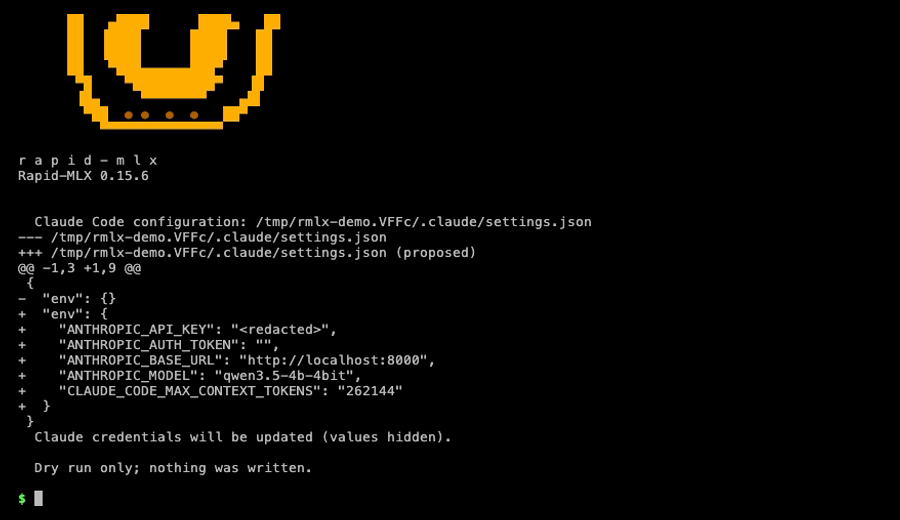
要在本地快速启动 Rapid-MLX 服务端并完成第一个 OpenAI 兼容格式的 API 请求,开发者可以直接通过 Homebrew 安装其 macOS 桌面端或通过源码进行 Python 生产级部署。
# 通过 Homebrew 直接安装 macOS 桌面及服务端组件
brew install rapid-mlx

# 或者使用 Python 虚拟环境启动本地推理服务器
pip install rapid-mlx

# 启动指定模型的本地兼容服务,默认监听 8000 端口
python -m rapid_mlx.server --model Qwen/Qwen3.5-9B-Instruct-4bit --port 8000
部署完成后,利用 Python 脚本进行标准的流式工具调用与生成测试:
import openai

# 初始化指向本地 Rapid-MLX 服务的客户端实例
client = openai.OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="not-needed"
)

# 发起流式聊天补全请求,激活底层投机解码与 Radix 缓存
response = client.chat.completions.create(
    model="Qwen/Qwen3.5-9B-Instruct-4bit",
    messages=[
        {"role": "system", "content": "You are a precise coding agent."},
        {"role": "user", "content": "Write a python function to compute fibonacci numbers."}
    ],
    stream=True,
    temperature=0.0
)

# 实时消费流式输出 Token
for chunk in response:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
运行上述脚本后,控制台将以接近硬件极限的流式速率输出 Python 代码,解码延迟相比 mlx-lm 缩减显著。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在将 Rapid-MLX 接入生产环境的复杂 Coding Agent 工作流时,必须注意特定的硬件与软件约束条件,以规避潜在的架构风险。
⚠️ 避坑预警 [硬件平台限制]:Rapid-MLX 的底层加速特性深度绑定 Apple Silicon 架构。目前官方未提供 Windows 与 Linux 的桌面端及原生后端二进制构建,跨平台服务器集群切勿将其作为异构推理节点。
⚠️ 避坑预警 [默认投机解码开关]:部分小参数模型(如 Qwen3.5-4B)默认关闭了投机解码。强行在低端芯片上开启过大的 MTP 候选头可能导致显存带宽争抢,建议通过基准测试工具在特定模型权重上验证吞吐表现后再调整默认超参数。