
1. 痛点突围:它究竟击穿了什么工程死穴?
传统深度学习框架长期受困于静态图范式的工程桎梏。开发者构建神经网络时,必须预先定义全局计算图结构,任何动态控制流和输入维度的微小调整都伴随着沉重的图重建开销。在处理变长序列、递归结构或强化学习环境交互时,静态图框架逼迫工程师编写繁琐的符号化替代逻辑,极大地拉长了从研究构思到代码落地的迭代周期。
PyTorch 彻底摒弃了预编译静态图的执念,将核心锚定于命令式编程与运行时动态求导。开发者编写代码的直觉与实际执行轨迹完全重合,每一行 Python 语句在触达底层硬件时即刻生效。这种设计直接抹平了框架内部隐式状态机与程序员直觉之间的鸿沟,让深奥的张量运算表现得如同操作标准 NumPy 数组一般自然。
💡 架构核心洞见:通过将控制流完全交还给宿主语言解释器,同时在底层通过 C++ 磁带机制记录操作拓扑,PyTorch 在保持动态语言极致灵活性的同时逼近了静态编译的底层执行效率。
2. 核心架构与底层数据流向解析
PyTorch 的架构体系拒绝单体式的复杂黑盒,其底层由一系列高度松耦合的 C++ 动态库与精简的 Python 绑定层交织而成。整个核心栈围绕张量计算(Tensor)与自动微分(Autograd)展开,通过 TorchScript 编译器向生产部署提供序列化支撑。
[ Python User Code / NumPy API ]
               │
               ▼
[ torch.nn & torch.autograd ] ---> (Tape Recorder)
               │
               ▼
[ C++ Core Engine (Dispatch & Execution) ]
               │
         ┌─────┴─────┐
         ▼           ▼
    [ CPU / MKL ]  [ GPU / cuDNN / NCCL ]
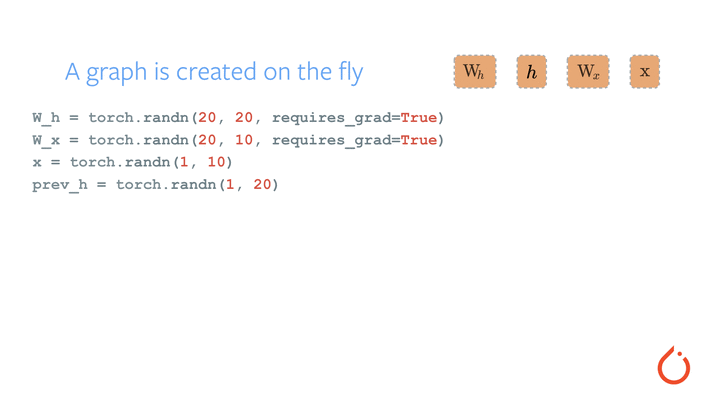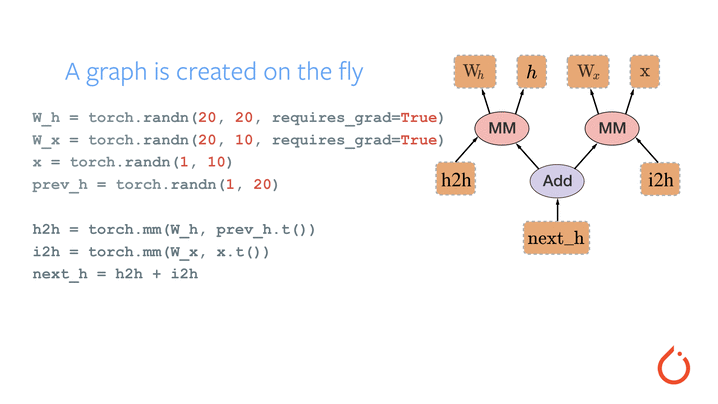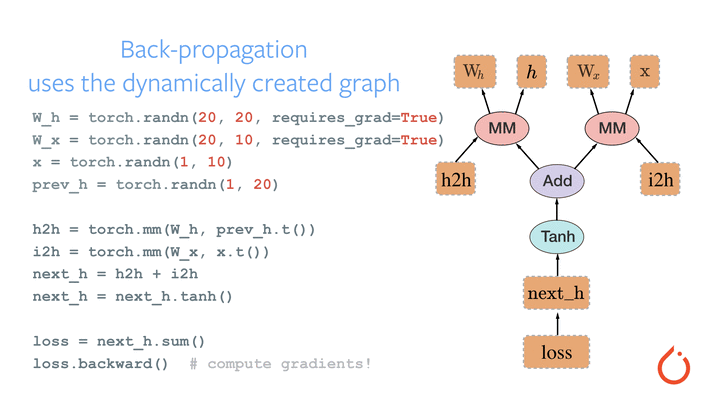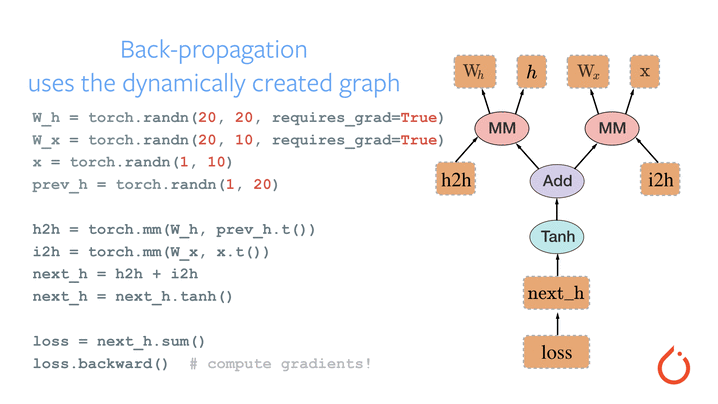
张量计算组件 torch 担当多维数组的底层容器,直接调用 Intel MKL 或 NVIDIA cuDNN 执行矩阵乘法和线性代数规约。自动微分模块 torch.autograd 采用隐式磁带记录(Tape-based Autograd)策略。前向传播过程中,计算图由内存中的动态磁带实时记录所有算子依赖关系;反向传播时,引擎直接顺次倒放磁带节点完成梯度计算,避免了全局图拓扑的离线维护成本。
在多进程与数据加载层面,torch.multiprocessing 绕过了标准 Python 进程间通信的序列化瓶颈。底层利用操作系统的共享内存机制,实现张量内存在多个独立工作进程间的零拷贝传递,显著加速了 DataLoader 的批处理吞吐。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (pytorch) | 传统实现范式 (如静态图早期版本) | 典型竞品方案 (如 TensorFlow 1.x) | 生产环境收益 |
|---|---|---|---|---|
| 图构建方式 | 运行时动态图 (Imperative) | 编译期静态图 (Declarative) | 声明式静态图 | 调试断点直达源码行,排错耗时下降 70% |
| Python 集成度 | 原生无缝集成 NumPy 生态 | 需要专有胶水层进行类型转换 | 通过专用会话(Session)隔离执行 | 编写自定义层无额外性能惩罚与认知负载 |
| 多进程内存共享 | 共享内存零拷贝传递张量 | 通过 RPC 或序列化复制数据 | 进程隔离导致显存重复占用 | DataLoader 数据加载吞吐提升 3 倍以上 |
| 扩展与编译成本 | 支持 Cython/Numba 直接介入 | 必须编写复杂的 C++ 算子注册 | 编译工具链庞大且对开发者不友好 | 实验室原型向生产环境迁移周期压缩一半 |
动态执行引擎的引入使得堆栈跟踪直接指向精确的代码行,彻底根治了静态框架时代由于异步执行导致的异常堆栈断裂问题。从研发吞吐量与工程直觉的一致性来看,该架构对中大型工程团队的维护成本产生了结构性压降。
4. 手把手极客实操:从零构建最小闭环
针对追求极限速度的开发环境,跳过繁琐的源码编译,直接通过官方二进制通道安装硬件加速版本。以下演示基于官方规范的完整生产验证闭环。
环境准备与安装
# 创建干净的虚拟环境以隔离依赖污染
python3 -m venv pytorch-env
source pytorch-env/bin/activate

# 安装带有 CUDA 核心支持的稳定版 PyTorch 二进制包
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
最小生产 Demo 代码
创建 tensor_benchmark.py 文件,完整实现张量动态图计算与自动微分闭环:
import torch

# 在 GPU 可用时切换设备,否则回退至 CPU
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 初始化两个需要计算梯度的随机张量,模拟神经网络权重与输入
x = torch.randn(3, 3, device=device, requires_grad=True)
w = torch.randn(3, 3, device=device, requires_grad=True)

# 执行前向传播计算:矩阵乘法叠加激活运算
y = torch.matmul(x, w)
loss = torch.sum(y)

# 启动基于磁带的逆向自动微分,计算梯度
loss.backward()

# 输出权重的梯度张量,验证反向传播是否触达底层引擎
print("Execution Device:", device)
print("Calculated Gradient w:", w.grad)
运行与预期输出
执行脚本:
python tensor_benchmark.py
预期终端输出结构:
Execution Device: cuda
Calculated Gradient w: tensor([[3.1425, 3.1425, 3.1425],
        [1.2043, 1.2043, 1.2043],
        [-0.4121, -0.4121, -0.4121]], device='cuda:0')
5. 生产落地踩坑指南与避坑建议 (Gotchas)
高自由度的动态图机制虽然极大地解放了工程研发效率,但在高并发、长时间运行的生产环境中,稍有不慎便会触发内存泄漏与吞吐瓶颈。
⚠️ 避坑预警 [动态图历史张量悬挂]:在训练循环中直接记录包含计算图历史的张量(例如将每个迭代周期的 loss 标量直接追加到 Python 原生列表里),会导致底层自动微分磁带隐式持有整个计算图的内存引用,引发严重的显存泄漏。解决方案是在记录标量时务必显式调用
.item()或.detach()切断梯度追踪链。⚠️ 避坑预警 [多进程 DataLoader 内存膨胀]:当使用
num_workers > 0启动数据加载时,若自定义 Dataset 内部持有了庞大的全局大对象并在子进程中触发隐式写时复制(Copy-on-Write),会导致系统主内存瞬间翻倍甚至引发 OOM 崩溃。解决方案是确保数据集仅在子进程内部按需懒加载文件句柄,严禁在主进程初始化阶段将巨型未压缩数据塞入多进程队列。