
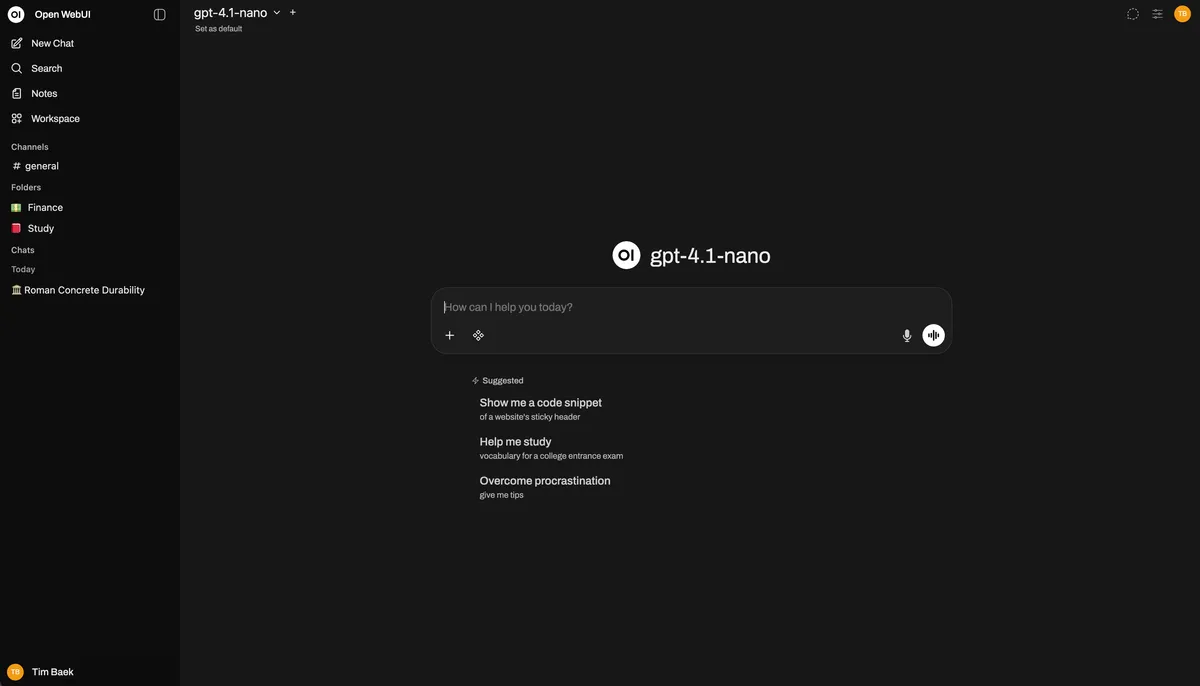
1. 痛点突围:它究竟击穿了什么工程死穴?
大模型落地过程中,开发者经常陷入碎片化工具链的泥潭。前端需要对接多家的 API,后端要自己写胶水代码去处理流式响应,知识库检索依赖各种零散的 Python 脚本,权限管理和多租户隔离则需要从零重构一套鉴权系统。这种割裂的架构导致研发团队把大量精力消耗在维护底层集成上,业务逻辑反而成了次要任务。
open-webui 将这些分散的零组件压缩进单一的可执行边界内。它通过 Provider-agnostic 接口抽象,把本地运行的轻量模型与云端的超大规模推理后端映射到完全相同的调用规范下。研发人员不再需要为切换大模型服务商而重写前端路由逻辑,系统直接在应用层抹平了异构 API 之间的协议差异。
💡 架构核心洞见:通过将协议适配、向量检索、终端沙箱与细粒度权限控制收敛至单一服务边界,open-webui 用纯粹的工程收敛消除了大模型落地的胶水代码复杂度。
2. 核心架构与底层数据流向解析
open-webui 采用前后端分离但打包部署的单体架构设计。底层使用 FastAPI 作为核心控制面,通过 WebSocket 支撑全双工的实时交互与多路流式传输。数据在系统内部的流转遵循严格的管道化模型,从客户端发起的请求首先经过鉴权与 RBAC 拦截器,随后进入上下文路由器进行意图分类与提示词增强。
[ Client / Browser ] ---> [ FastAPI Gateway / RBAC ] ---> [ Context Router ]
                                                              │
                                                              ▼
[ Open Terminal Sandboxes ] <---> [ Vector RAG Engine ] <---> [ Model Providers ]
在这个流向拓扑中,动态执行引擎与 Open Terminal 组件形成了直接闭环。当 Agent 触发代码生成或文件处理任务时,系统会跳出单纯的文本生成范式,将指令分发至隔离的沙箱环境运行。执行结果的 stdout 与 stderr 实时捕获并反哺回上下文窗口,实现了多步任务的自主迭代与纠错。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (open-webui) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 接口抽象 | Unified OpenAI-compatible | 各厂商定制 SDK | LangChain 链式封装 | 切换大模型后端代码改动量归零 |
| RAG 支撑 | 9 种向量库 + BM25 混合检索 | 孤立 Python 脚本 | 商业闭源知识库 SaaS | 数据主权归本地,无隐私泄露风险 |
| 多租户权限 | 细粒度 RBAC + LDAP / SCIM | 硬编码用户表 | 基础 API Key 隔离 | 企业级合规落地,防越权访问 |
| 代码执行 | Open Terminal 隔离沙箱 | 本地裸机直接运行 | 无原生终端交互 | 赋能 Agent 具备真实的写代码能力 |
这套对比数据展现了 open-webui 在工程完成度上的优势。相比于零散的开源脚本组合,它提供了一整套经过工业级验证的闭环组件,省去了自研管理后台与权限控制的巨大沉淀成本。
4. 手把手极客实操:从零构建最小闭环
在生产环境或本地开发机中部署 open-webui 最稳妥的方式是使用 Docker。以下命令拉取官方镜像并挂载本地 Ollama 服务,同时指定卷持久化存储路径。
# 拉取包含 Ollama 支持与 CUDA 加速的官方生产镜像
docker run -d \
  -p 3000:8080 \
  --gpus all \
  -v open-webui:/app/backend/data \
  --name open-webui \
  --restart always \
  ghcr.io/open-webui/open-webui:cuda
运行成功后,通过浏览器访问 http://localhost:3000 即可初始化管理员账号。若需对接自定义的 OpenAI-compatible 后端,仅需在管理后台设置中注入对应的 API_BASE_URL 与 API_KEY,系统会自动拉取远端模型列表并注册至前端选择器。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在容器化多用户并发场景下运行 open-webui 时,如果未对 SQLite 数据库并发或向量检索引擎做针对性调优,极易遭遇性能瓶颈。
⚠️ 避坑预警 [SQLite 并发死锁]:在高并发多用户同时写入聊天记录时,默认的 SQLite 后端可能触发数据库锁定错误。生产环境务必切换至 PostgreSQL 后端,并通过环境变量
DATABASE_URL指定连接串。⚠️ 避坑预警 [RAG 内存暴涨]:处理超长 PDF 或多模态文档切片时,若加载了过重的本地嵌入模型,容器内存占用会迅速飙升。建议配置外部向量数据库如 Qdrant 或 Milvus,将嵌入计算与向量存储进行物理剥离。