
1. 痛点突围:它究竟击穿了什么工程死穴?
企业级 AI Agent 的核心卡点不在于大模型生成 SQL 的能力,而在于底层数据的语义模糊性。传统工程实践中,开发者将庞大的数据库 Schema 直接塞进 Prompt 上下文窗口。随着业务表数量的膨胀,Context 窗口被冗余字段撑满,Token 消耗失控,大模型对同名字段的猜测必然引发灾难性的错误查询。销售额被错误计算、关联键拼凑失误,导致生成的分析报表在真实生产环境中毫无价值。
Auto-Ontology 的切入点极其克制。它不在模型内部做文章,而是在数据库旁边部署一层专用的上下文服务。该服务自动采集数据库元数据,将其编译为本体语义图谱。业务术语被精准映射到底层列,经过人工验证的 SQL 测量指标和表间物理关系被固化在图谱中。AI Agent 查询时只获取相关术语和涉及的表,从根源上截断了盲目推断导致的幻觉链条。
💡 架构核心洞见:通过独立上下文层将动态 Schema 推导转化为确定性的语义图谱匹配,让 AI 在受控的业务网格内执行查询,用规则过滤替代概率猜测。
2. 核心架构与底层数据流向解析
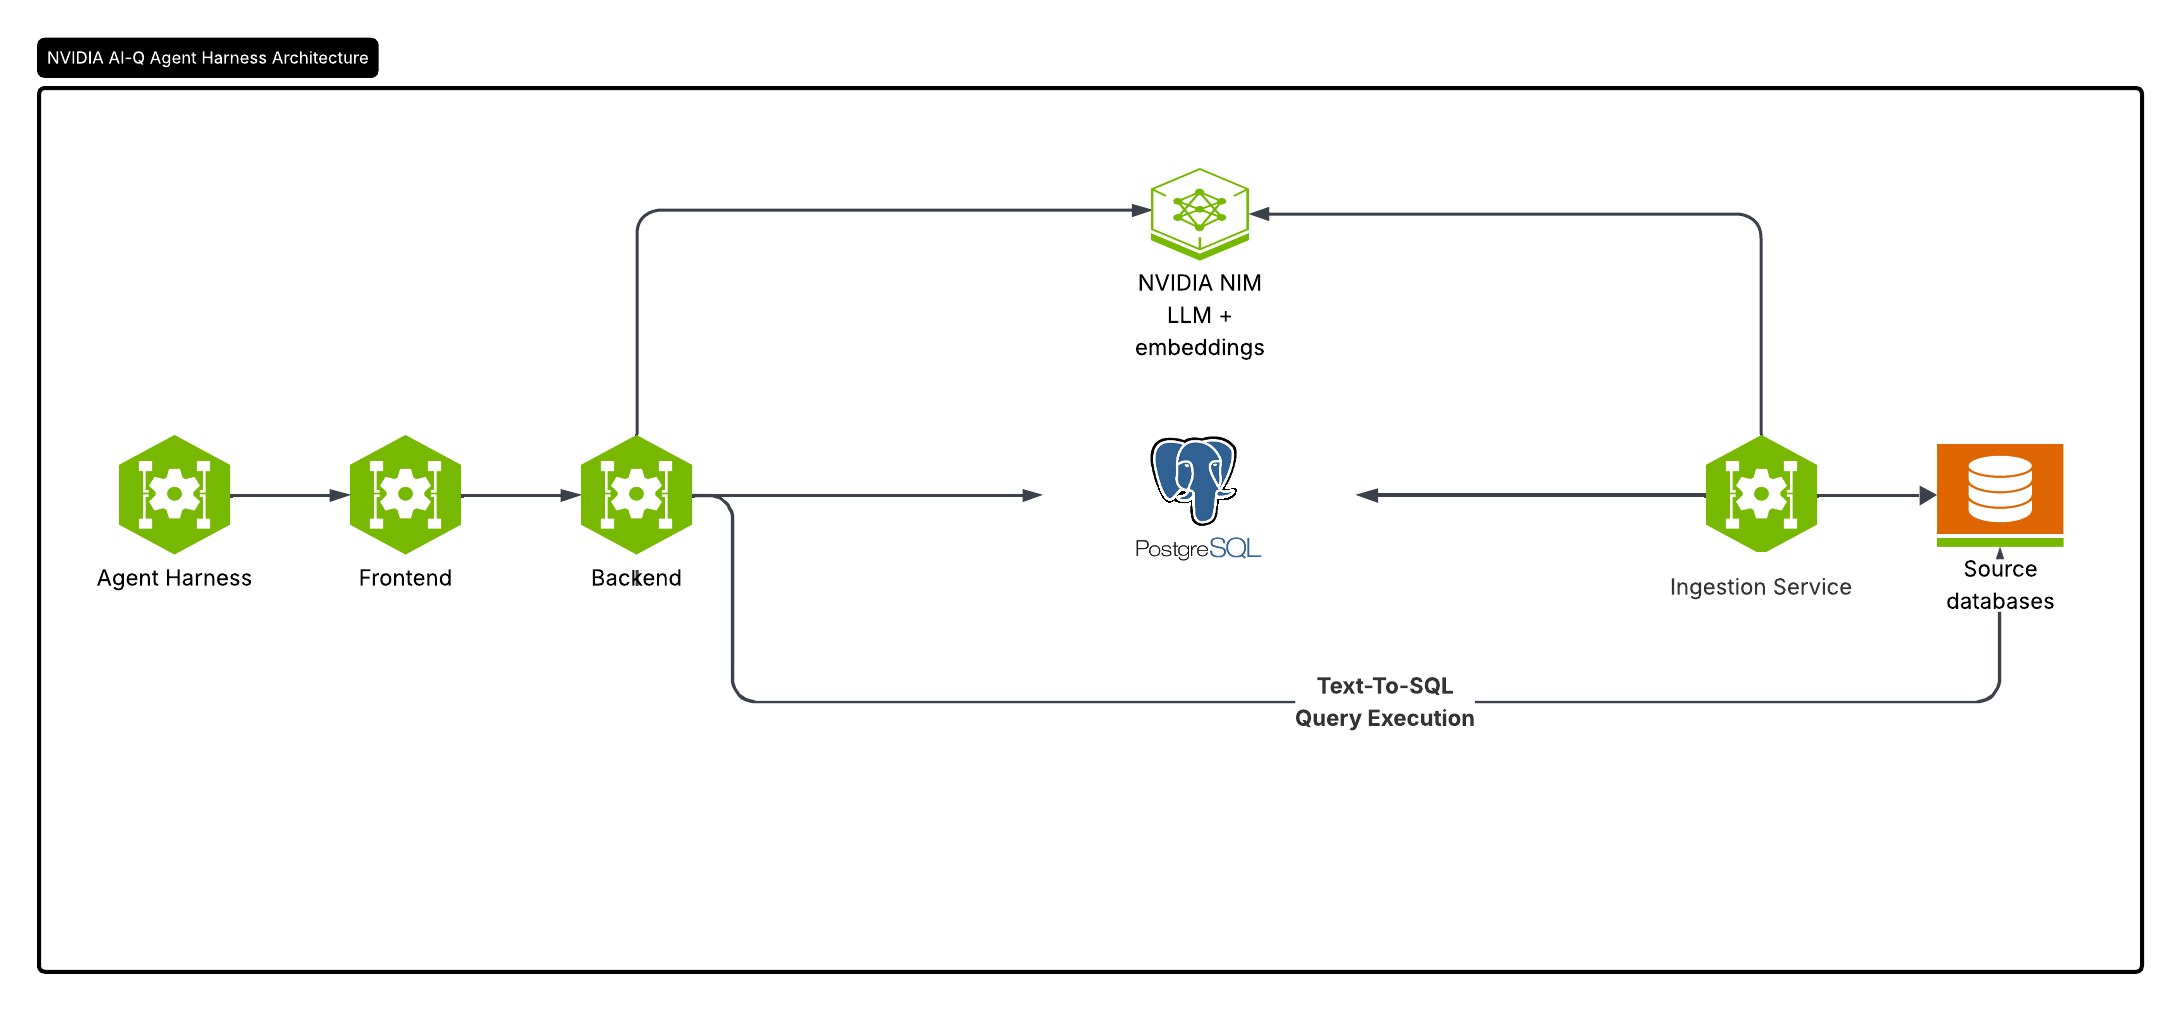
Auto-Ontology 的底层架构由元数据导入器、语义编译器、Web 审阅面板以及面向 Agent 的 MCP 接口组成。系统启动时,解析器从目标数据库拉取原始 Schema,通过大模型辅助与规则引擎将其转换为包含业务概念、度量指标以及多表连接关系的本体对象。开发者可以通过内置的 Web UI 审查这些映射结果,并对生成的 SQL 表达式进行纠偏与认证。
数据在系统内部的流转路径遵循清晰的单一职责原则。当客户端提交自然语言查询时,网关层首先解析意图,命中图谱中的业务实体与关系路径,动态组装出最小化的上下文集与可执行 SQL,交由执行引擎落地。
[ Client / Agent ] ---> [ Gateway / Intent Parser ] ---> [ Ontology Semantic Graph ]
                                                                  │
                                                                  ▼
[ Verified SQL Output ] <--- [ Execution Engine & Verifier ] <--- [ Minimized Context ]
工程权衡体现实用主义。系统没有强迫研发团队推翻现有的数据仓库建模,而是作为旁路服务运行。它既可以兼容现有的语义模型,也能向任何支持 Model Context Protocol 的 Agent Harness 提供确定性上下文,平衡了自动化构建效率与企业级数据治理的精细度。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (auto-ontology) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 上下文维护 | 图谱按需加载相关术语 | 全量 Schema 塞入 Prompt | 静态大文档嵌入检索 | 消除 Token 浪费与混淆 |
| 语义准确度 | 业务术语绑定列与 SQL | 靠大模型运行时猜测 | 依赖硬编码 ORM 映射 | 杜绝盲目自信的错误查询 |
| 验证与纠错 | 具备可执行前的答案检查 | 无验证直接抛出结果 | 仅支持单元测试用例 | 遇到不可答问题主动追问 |
| 架构侵入性 | 旁路运行不改动核心库 | 强依赖应用层拼装 | 需要重构整个数仓语义 | 部署成本极低零风险上线 |
| 扩展生态 | 原生支持 MCP 与 REST | 自定义私有 API 封装 | 绑定特定商业数据库 | 快速接入主流 AI 框架 |
表格中的指标对比呈现出明显的工程分水岭。传统方案将 Schema 暴露给模型,将数据安全和语义理解寄托于大模型的涌现能力。而 Auto-Ontology 引入确定性的图谱约束,将不可控的自由发挥收敛到已审核的业务边界之内。
4. 手把手极客实操:从零构建最小闭环
在本地部署 Auto-Ontology 并连接微软的经典测试数据库 Wide World Importers。确保本地已安装 Docker Compose v2 与 astral.sh/uv。
克隆仓库并初始化环境变量:
git clone https://github.com/NVIDIA/auto-ontology.git && cd auto-ontology
cp .env.example .env
编辑 .env 文件,填入 NVIDIA API 密钥与自定义的生产密码:
# 统一调用的 NVIDIA API 密钥
DEFAULT_MODELS_API_KEY=nvapi-your-api-key-here
# 后端服务安全密钥,用于生成 Session 与加密
AUTH_SECRET=a_long_random_string_from_openssl_rand
# Web UI 访问地址
APP_URL=http://localhost:3000
# PostgreSQL 数据库超级密码
POSTGRES_PASSWORD=secure_postgres_password_123
# 目标测试数据库连接字符串
CONNECTION_STRINGS=postgresql://postgres:secure_postgres_password_123@postgres:5432/wideworldimporters
# Web 管理后台管理员密码
AUTO_ONTOLOGY_ADMIN_PASSWORD=admin_password_123
PGADMIN_PASSWORD=pgadmin_password_123
启动底层 PostgreSQL 数据库并执行测试数据灌库脚本:
# 启动容器服务中的 PostgreSQL
docker compose up -d --wait postgres

# 克隆评测及种子脚本仓库并执行灌库
git clone https://github.com/NVIDIA/auto-ontology-eval.git ../auto-ontology-eval
(cd ../auto-ontology-eval && uv sync && cp .env.example .env && \
  POSTGRES_PASSWORD='secure_postgres_password_123' \
  uv run python scripts/seed/seed_wwi.py --database-name wideworldimporters --drop)
构建并拉起整体应用容器集群:
docker compose up -d --build
打开浏览器访问 http://localhost:3000,使用环境变量中配置的管理员邮箱与密码登录。进入 Settings -> Semantic Compilation 并开启编译开关。等待系统完成元数据摄取与语义图谱构建,出现状态提示后即可进入 Chat 页面执行自然语言分析查询。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
将此架构引入生产环境时,必须警惕几个隐蔽的工程陷阱。元数据自动摄取依赖大模型对列名的理解,若企业内部存在大量无规范命名的历史遗留表,初始图谱会产生大量脏映射。必须在 Web UI 中人工介入审阅,切忌直接将未经校验的图谱暴露给线上 Agent。
⚠️ 避坑预警 [API 密钥回退冲突]:
.env.example中同时存在全局默认密钥与按模型角色的独立密钥配置。若误删全局密钥却未完整配置所有模型角色的 Key,会导致部分子代理在冷启动时报认证错误。建议生产环境仅保留DEFAULT_MODELS_API_KEY。⚠️ 避坑预警 [大模型吞吐与超时设置]:在进行大规模复杂 Schema 语义编译时,初始编译阶段会并发调用多次大模型接口。若企业 API 网关存在严格的并发限流或较短的超时时间,会导致语义编译中断。务必调整反向代理与 API 客户端的超时阈值,确保首轮全量图谱构建顺利收敛。