
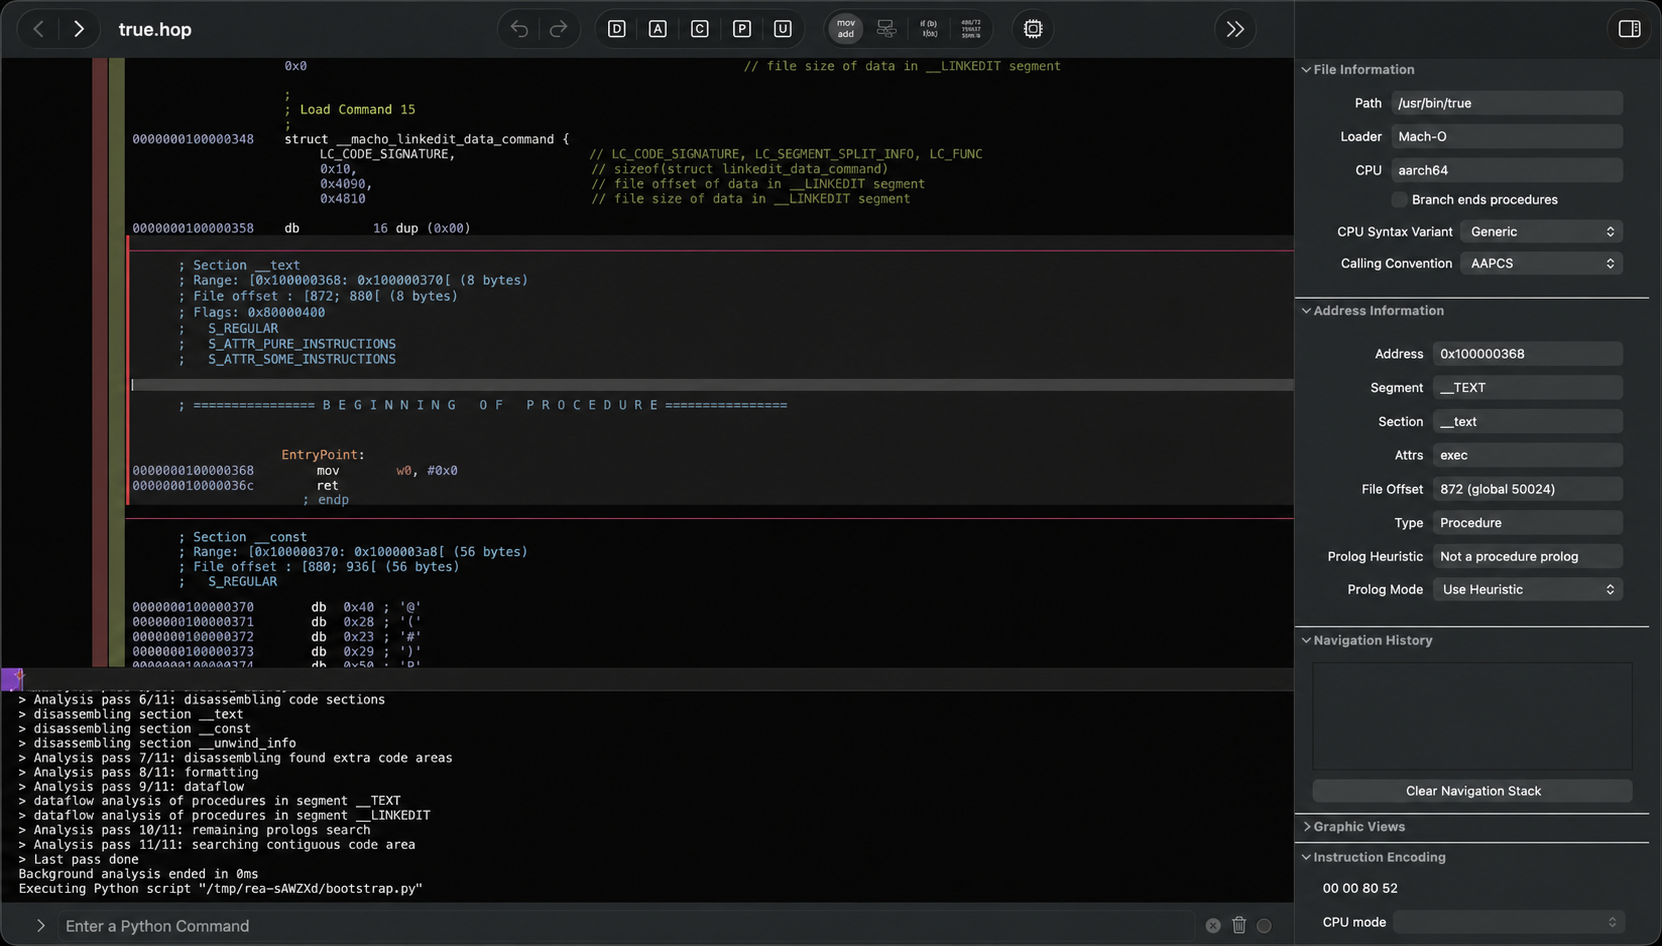
1. 痛点突围:它究竟击穿了什么工程死穴?
传统软件逆向工程长期被繁琐的符号表恢复、晦涩的汇编跳转以及孤立的调试工具链锁死。开发者在复刻竞品特性时,必须在 IDA Pro、Hopper、Ghidra 与自身的 IDE 之间进行高频且痛苦的上下文切换。大语言模型虽然擅长生成代码,却在此类场景中失语,因为它们无法直接接触闭源应用的二进制资产,也缺乏操作反编译工具的本地代理通道。morluto/rea 项目通过引入模型上下文协议(MCP),将 AI 代理直接织入本地二进制与前端应用的检查流水线。它不依赖未经授权的源码托管服务,而是将反编译器的符号解析结果作为结构化上下文注入代理,彻底消除了从二进制洞察到产品代码实现的中间鸿沟。
💡 架构核心洞见:REA 的本质是将大语言模型的符号推理能力,与底层静态分析引擎(Hopper/Ghidra)通过标准 MCP 协议做无损对齐,让 AI 代理具备自主追溯函数调用栈的能力。
2. 核心架构与底层数据流向解析
REA 的整体架构由三个核心阶段驱动:反编译(Decompile)、理解(Understand)以及重构(Recreate)。在执行层,它完全遵循本地优先的工程约束,绝不将二进制数据上传至远程托管服务。整个工具链通过 npx rea-agents setup 注入到支持的宿主代理中(如 Claude Code、Cursor、Windsurf 等),并通过标准化接口与本地反编译程序建立双向通信。
[ Host Agent / CLI ] ---> [ REA Gateway / MCP ] ---> [ Local Decompilers (Hopper / Ghidra) ]
         │                                                                   │
         ▼                                                                   ▼
[ Recreated Code Output ] <------------------------------------- [ Symbol & Binary Evidence ]
在底层状态流转中,REA 维持一个跨应用的持久化上下文层。当开发者在终端或代理对话中输入调查指令时,CLI 会调用本地注册的工具链打开目标 .app 或二进制文件。静态分析提供商提取字符串、函数名与交叉引用(XREFS),随后将这些具象化的证据链条回传给大模型。代理依据这些汇编级别的真凭实据,推导出功能实现的真实控制流,最后在当前开发者的技术栈中落地对应的业务逻辑。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (rea) | 传统 IDA/Ghidra 纯手工逆向 | 闭源 SaaS 逆向分析服务 | 纯 LLM 猜测与幻想代码 |
|---|---|---|---|---|
| 自动化程度 | AI 代理驱动自动化追溯 | 完全人工寻找汇编交叉引用 | 依赖黑盒云端大模型推测 | 无真实二进制依据,全靠幻觉 |
| 数据隐私 | 100% 本地运行,绝不上传 | 100% 本地运行 | 二进制及符号需上传云端 | 提示词包含业务逻辑代码 |
| 工具链集成 | 原生对接 MCP 与各类 AI 代理 | 需编写复杂 IDC/Python 脚本 | 独立 Web 界面,割裂开发流 | 无反编译工具链支撑 |
| 输出结果 | 附带证据链的适配代码 | 晦涩的汇编与反编译 C 伪代码 | 泛化的分析报告 | 语法正确但逻辑完全脱节的幻觉代码 |
| 环境依赖 | Node.js 22+ 及 Hopper/Ghidra | 笨重的专业逆向套件 | 浏览器与云端 API 额度 | 任意 LLM API |
表格对比清晰表明,REA 在保留传统反编译工具安全合规与本地运行优势的同时,借助 AI 代理的推理能力省去了海量的人工符号对齐时间。它不是用幻觉替代分析,而是将汇编级证据作为上下文喂给大模型,产出具备生产可用性的工程代码。
4. 手把手极客实操:从零构建最小闭环
要在本地工作站跑通 REA 的最小分析闭环,需要确保宿主机满足最低软硬件要求(macOS 12+ 或 Linux 64位环境,且安装 Node.js 22.x/24.x/26+)。
使用官方推荐的交互式引导完成代理与分析工具的绑定:
# 运行一键配置脚本,自动检测系统中的 AI 代理并注入 MCP 协议
npx rea-agents setup
配置完成后,在终端通过健康检查命令验证环境连通性,并对目标应用发起首次逆向分析:
# 验证当前主机环境、依赖项、分析工具与代理配置状态
npx -y rea-agents@latest doctor

# 对指定的 macOS 本地应用程序发起逆向分析工作流
npx -y rea-agents@latest analyze /Applications/Notes.app
在完成上述初始化并重启你的 AI 代理(如 Cursor 或 Claude Code)后,即可在对话框中直接输入实战指令:
Understand how search works in the Notes app, show me the evidence, and build a similar feature for my project.
执行后,REA 会驱动本地 Hopper 或 Ghidra 提取相关符号,代理将在终端或编辑器内输出底层的证据链条,并自动生成适配你当前技术栈的搜索功能实现。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在将 REA 纳入日常开发与逆向流水线时,底层二进制分析的复杂性决定了开发者必须规避若干已知的工程陷阱。
⚠️ 避坑预警 [二进制分析工具依赖缺失]:REA 依赖本地安装的 Hopper 或 Ghidra 提供静态分析能力。若未在
setup阶段正确关联 Hopper 或配置 Ghidra 路径,代理在执行分析时将无法获取底层的符号与交叉引用,导致大模型退化为纯文本推测。务必在运行前通过rea doctor确认分析工具链状态。⚠️ 避坑预警 [Windows 平台实验性质限制]:Windows 环境下对 Ghidra 的支持目前仅限于本地 NTFS 文件系统上的原生 x86-64 PE 应用程序。若尝试在跨盘符、网络共享路径或非标准容器内运行 Windows 原生分析,会触发路径准入控制(Path-admission controls)或 Job Object 异常。生产环境请严格在 macOS 或官方验证过的 Linux(Ubuntu 24.04+/Fedora 41+/Arch Linux)宿主机上部署。