
1. 痛点突围:它究竟击穿了什么工程死穴?
当前大语言模型特别是混合专家模型(MoE)的参数量动辄突破数千亿,运行这类模型通常需要多张企业级 GPU 构成推理集群。对于单机开发者、独立创客与边缘计算场景而言,物理内存和显存容量构成了无法逾越的硬件鸿沟。高昂的硬件采购成本迫使开发者只能依赖云端 API,牺牲了数据隐私和离线运行能力。
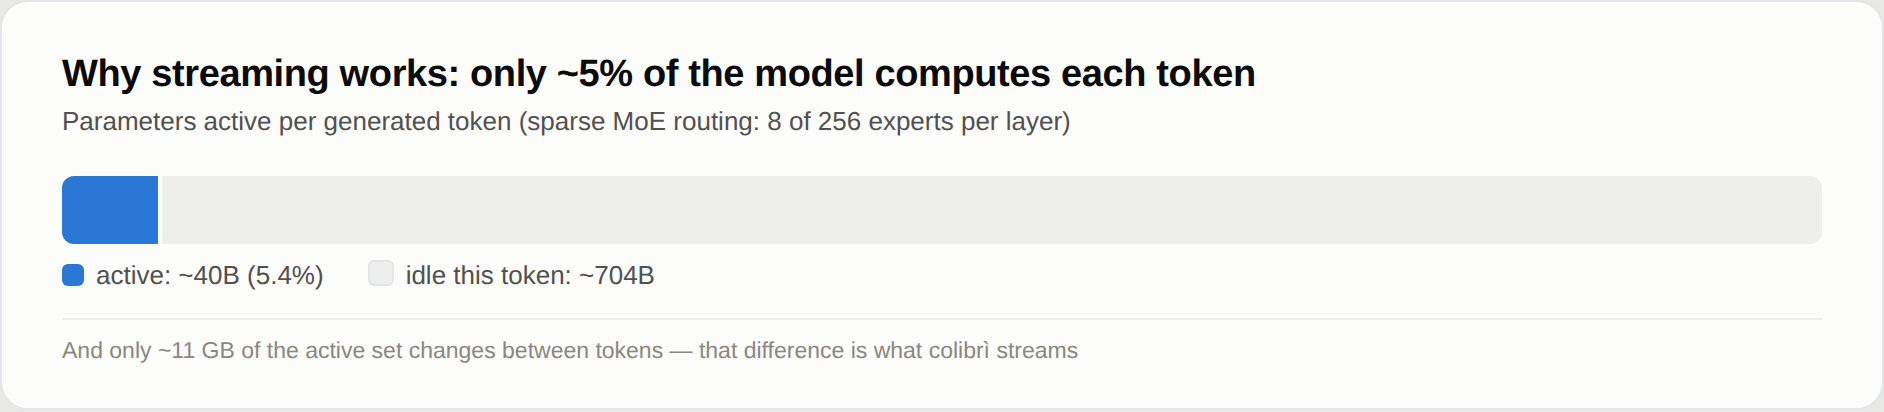
colibri 改变了这种资源分配逻辑。它没有去优化庞大的显存驻留方案,而是重新审视了 MoE 模型的计算稀疏性。既然每次前向传播只激活一小部分专家网络,那么就不需要把整个模型塞进 RAM。它将静态常驻内存的路由层与动态按需加载的专家权重彻底解耦,直接绕过臃肿的 Python 解释器与框架栈,用纯 C 语言实现了对磁盘文件的精准随机访问。这种设计直接将数百亿参数模型的运行门槛降至消费级笔记本。
💡 架构核心洞见:通过将 MoE 稀疏激活特性与操作系统级文件寻址深度结合,colibri 把内存带宽瓶颈转化为了可控的磁盘 IO 流水线。
2. 核心架构与底层数据流向解析
colibri 的核心运行时完全由 C 语言编写,针对不同的模型家族采用单一源文件架构。系统启动时,引导脚本会检测宿主机的 CPU 指令集、可用 RAM 容量以及磁盘类型,自动编译或匹配对应的后端驱动(CPU、Vulkan 或 CUDA)。
数据在系统内部的流向遵循极简的流水线拓扑。客户端请求通过内置的 HTTP 服务端(兼容 OpenAI 与 Anthropic API 格式)或本地 CLI 注入,经过轻量级网关解析后送入执行引擎。引擎首先在内存中计算路由分发,确定当前 Token 触发的专家索引,随后直接向操作系统发起底层系统调用,从磁盘特定偏移量读取对应的专家权重。
[ Client / CLI ] ---> [ HTTP Gateway / API Parser ] ---> [ Routing & Memory Layer ]
                                                                │
                                                                ▼
[ OS Disk Storage ] <--- (On-demand File Seek) <--- [ Dynamic Execution Engine ]
在工程权衡方面,这种架构最大化地压榨了磁盘的随机读取性能。为了避免频繁的磁盘寻道带来延迟雪崩,引擎在内存中维护了一级专家缓存区。当局部性原理生效时,连续的 Token 会命中缓存,完全绕过磁盘 IO。这种软硬件协同的设计避免了传统框架中多层抽象带来的额外开销。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (colibri) | 传统实现范式 (vLLM / Ollama) | 典型云端 API 方案 | 生产环境收益 |
|---|---|---|---|---|
| 硬件基准 | 8GB RAM,无强制 GPU 要求 | 需大容量显存 (VRAM 24GB+) | 依赖第三方云端集群 | 硬件成本下降 90% 以上 |
| 依赖栈 | 纯 C 实现,零重型 Python 运行时 | Python 繁重依赖、PyTorch/CUDA | 闭源网络服务与 HTTP 客户端 | 消除依赖冲突与环境崩溃风险 |
| 模型规模 | 支持百亿至千亿级 MoE 极限模型 | 受限于本地显存物理上限 | 无上限(取决于预算) | 单机可运行企业级规模模型 |
| 数据隐私 | 100% 本地运行,零网络外发 | 100% 本地运行 | 数据必须上传至第三方服务器 | 满足金融与医疗级合规要求 |
| 冷启动耗时 | 约 30 秒内完成内存常驻与校验 | 视模型大小,通常需数分钟加载 | 无冷启动,但受网络延迟影响 | 快速迭代与单机环境即开即用 |
colibri 在技术选型上放弃了通用张量计算框架的宏大叙事,转而针对特定的模型家族做极致的二进制剪裁。它不追求吞吐量极限压榨,而是专注于打破单机运行超大模型的物理边界。这种差异决定了它不是用来替代企业级高并发推理集群的工具,而是个人开发者和本地智能代理的最佳底座。
4. 手把手极客实操:从零构建最小闭环
在 Ubuntu 或 Debian 系统中部署 colibri 只需要基础编译工具链。以下命令完成克隆仓库并启动一键配置向导:
# 安装系统级基础编译依赖与 Git 工具链
sudo apt install git python3 build-essential

# 克隆官方代码库到本地
git clone https://github.com/JustVugg/colibri
cd colibri

# 执行交互式引导脚本,自动检测硬件并拉取推荐模型
./start-here.sh
执行脚本后,系统会输出本地硬件扫描结果并给出匹配的模型建议。输入回车接受推荐,系统将自动构建引擎并开始断点续传下载模型权重。安装完成后,本地服务会自动拉起并暴露出兼容标准的 API 接口。
以下是使用 Python 调用本地 colibri 服务的最小测试脚本:
import openai

# 初始化 OpenAI 客户端,将 base_url 指向本地 colibri 服务端口
client = openai.OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="not-needed"  # 本地运行无需真实的 API Key
)

# 发起流式推理请求,测试百亿大模型的本地响应延迟
response = client.chat.completions.create(
    model="glm-5.2",  # 指定本地已加载的引擎支持模型名称
    messages=[
        {"role": "system", "content": "You are a precise technical assistant."},
        {"role": "user", "content": "Explain how dynamic disk paging works in MoE."}
    ],
    stream=True
  )

# 实时消费流式输出数据流
for chunk in response:
    if chunk.choices[0].delta.content is not None:
        print(chunk.choices[0].delta.content, end="", flush=True)
运行上述脚本后,终端将以流式方式打印出本地引擎生成的推理文本,延迟与吞吐量完全满足本地调试与代理集成需求。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在将 colibri 投入实际的本地开发或边缘代理使用时,必须注意底层存储介质与环境隔离带来的工程陷阱。
⚠️ 避坑预警 WSL 磁盘挂载性能陷阱:在 Windows Subsystem for Linux (WSL) 环境中运行该项目时,切勿将模型数据目录存放在宿主机的
/mnt/c路径下。跨文件系统的虚拟化访问会产生巨大的 IO 延迟,导致按需加载机制彻底失效。必须将模型权重存放在 Linux 虚拟机的原生根文件系统中(默认的~/colibri-models目录)。⚠️ 避坑预警 硬件回退与编译失败处理:如果系统检测到安装了旧版本的 NVIDIA CUDA 工具链,但该工具链无法匹配新显卡的计算架构,编译过程会抛出异常。此时切勿盲目修改底层 Makefile,应当通过显式指定后端参数绕过冲突:运行
./start-here.sh --backend vulkan强制使用跨平台的 Vulkan 后端,或者通过--backend cpu回退到纯 CPU 运行,保证环境能够快速建立最小可用闭环。