
1. 痛点突围:它究竟击穿了什么工程死穴?
当前主流的 AI 编码代理在处理任务时,输出文本包含大量诸如“The reason why...”与“I'd recommend using...”的机械性客套话。这些长篇大论直接推高了输入输出 Token 消耗量。开发者既要为代理写出的冗长解释买单,又要在读取海量日志、测试输出与 JSON 响应时承受不必要的上下文开销。
Caveman 采用极简主义的设计范式,强制代理过滤所有不必要的修饰性散文。代码块、终端命令、文件路径以及准确的错误信息保持原样输出,只有包裹在这些核心技术资产周围的叙述性文本被压缩。这种策略在维持诊断与修复准确度的同时,显著降低了单次交互的计算开销。
💡 架构核心洞见:通过重塑代理的表达协议而非修改底层模型权重,在维持推理质量的基准线上直接挤出 Token 经济学的水分。
2. 核心架构与底层数据流向解析
Caveman 的工程架构分为三个渐进式层级:Skill 规则文件、Local Proxy 本地代理以及 Runtime Middleware 运行时中间件。用户可以根据实际需求选择单一组件或全栈部署。
[ AI Agent / Client ] ---> [ Local Proxy / Middleware ] ---> [ Token Compression Engine ] ---> [ LLM Provider ]
                                     │                                                              |
                                     └─────────────<── [ Original Backup Store ] <──────────────────┘
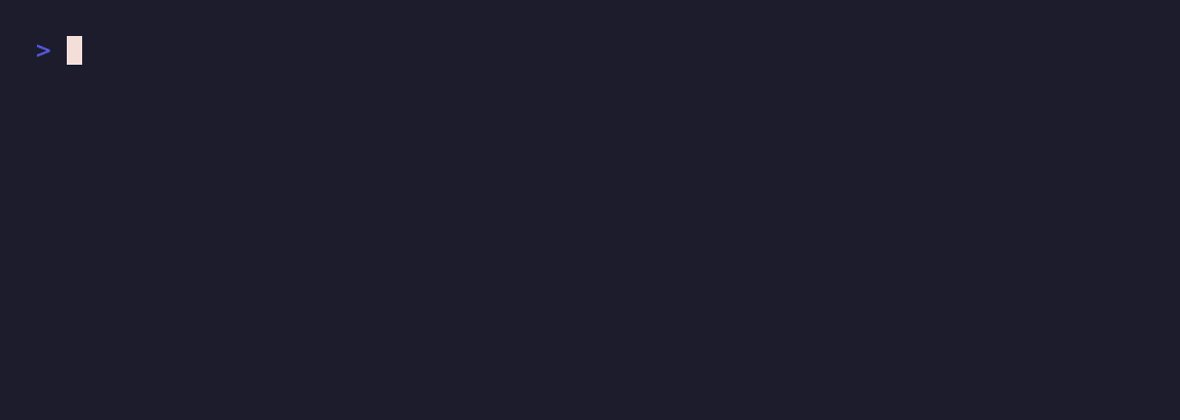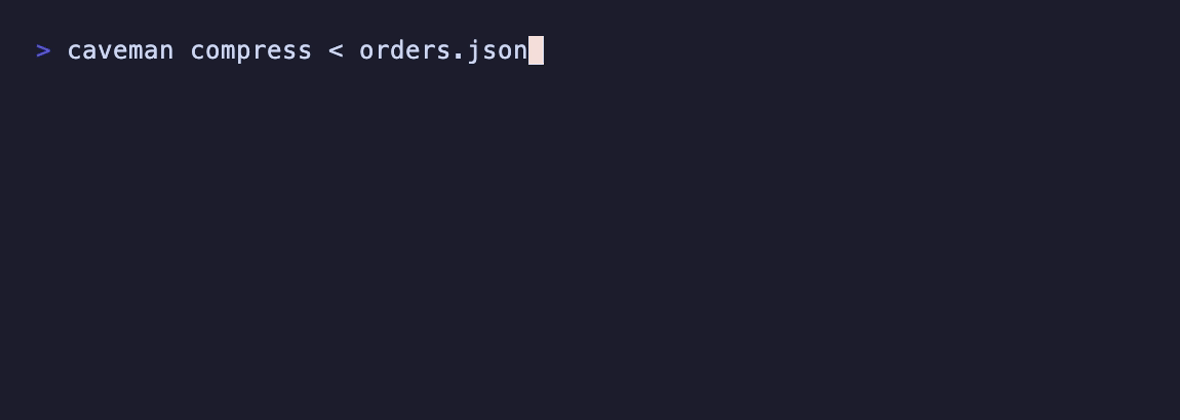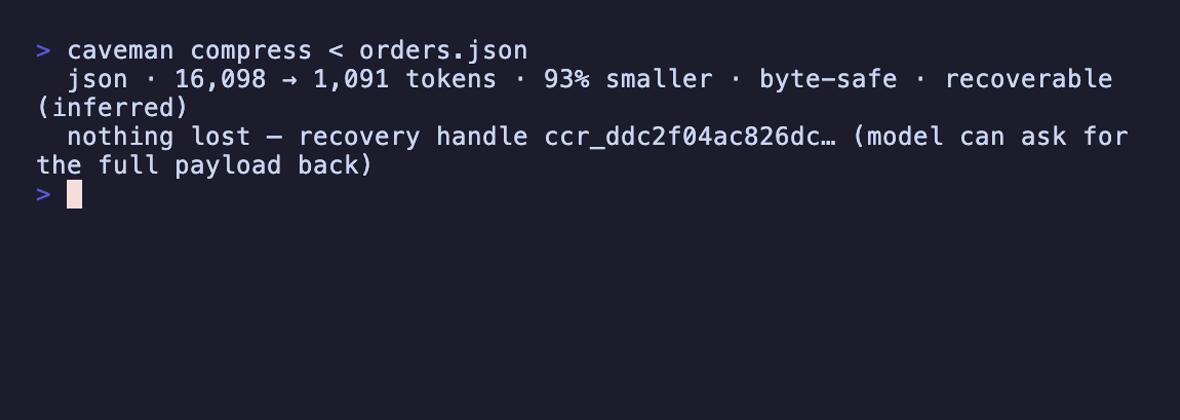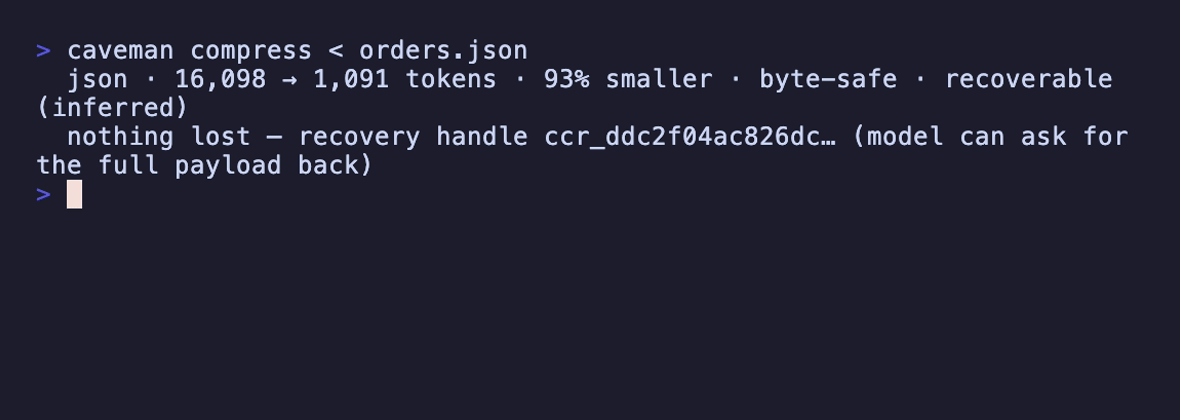
在底层数据流向中,Local Proxy 拦截代理与 AI 提供商之间的通信流。当代理读取日志、测试输出或大型 JSON 负载时,中间层执行动态蒸馏,移除冗余字符并将核心数据压缩。所有被压缩的原始字节会实时写入本地备份存储,确保大模型在需要追溯原始上下文时可以通过轻量指针瞬间还原,不会破坏整体状态机的连贯性。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (caveman) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 接入成本 | 单条 CLI 命令瞬时生效 | 修改底层 Prompt 模板与微调权重 | 购置第三方商业网关代理服务 | 零运维切换,分钟级部署上线的工程吞吐 |
| Token 压缩比 | 1.4x 至 2.4x(实测最高达 3x) | 1.0x(无优化) | 1.1x 至 1.3x(常规无损压缩) | 直接砍掉三分之一以上的 API 账单开销 |
| 代理兼容性 | 原生支持 30+ 主流 IDE 与 CLI 代理 | 绑定特定厂商模型接口 | 仅限特定框架(如 LangChain 专属插件) | 无需更换现有技术栈与开发工具链 |
| 上下文安全性 | 原始字节本地实时备份,模型可召回 | 全量传输无状态丢失风险 | 盲目丢弃导致大模型幻觉率上升 | 保证代码修复准确率零下降 |
这套架构的优势在于解耦了提示词约束与通信管道。传统方案依赖开发者手动调整 System Prompt 且效果不稳定,而 Caveman 通过“规则 + 代理 + 中间件”组合拳,在系统调用的最前端完成结构化瘦身。
4. 手把手极客实操:从零构建最小闭环
在终端环境中运行最小安装命令,快速启用全局 Skill 规则:
# 通过 npm 全球注册表安装 skills 工具并加载 caveman 规则
npx skills add JuliusBrussee/caveman -g
若需在生产环境拦截读取流,启动本地代理服务:
# 安装 caveman 命令行工具并初始化环境配置
npm install -g @caveman-ai/cli && caveman setup --install

# 启动特定代理(以 Claude Code 为例)
caveman claude
在自定义 TypeScript/Node.js 代理应用中集成中间件:
import { createCavemanMiddleware } from '@caveman-ai/middleware';
import { OpenAI } from 'openai';

// 初始化 OpenAI 客户端实例
const openai = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

// 包装 API 调用,自动在传输层对工具执行结果进行字节蒸馏
const cavemanMiddleware = createCavemanMiddleware({
  compressionLevel: 'aggressive',
  backupStore: './.caveman_cache'
});

async function runAgentTask(prompt: string) {
  // 传入执行上下文并由中间件处理输入输出 Token 密度
  const response = await openai.chat.completions.create({
    model: 'gpt-4o',
    messages: [{ role: 'user', content: prompt }],
  });
  return response;
}
运行上述脚本后,所有发往 LLM 的负载均会在底层被剥离冗余自然语言,而原始代码和报错轨迹被精准保留在缓存目录中供模型检索。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在真实高并发生产环境部署时,需要警惕本地缓存与极端文本解析带来的负面效应。
⚠️ 避坑预警 [本地备份存储膨胀]:代理在频繁执行长文本测试时,本地
.caveman_cache目录可能会快速累积海量原始数据。必须在部署脚本中配置定期清理任务,或在 CLI 中限制最大缓存生命周期。⚠️ 避坑预警 [严格模式类型冲突]:当中间件处理强类型 JSON Schema 输出时,过度激进的 Token 蒸馏可能导致某些边缘属性被错误修剪。在涉及复杂对象结构的代码段中,应通过配置白名单显式跳过特定结构体。