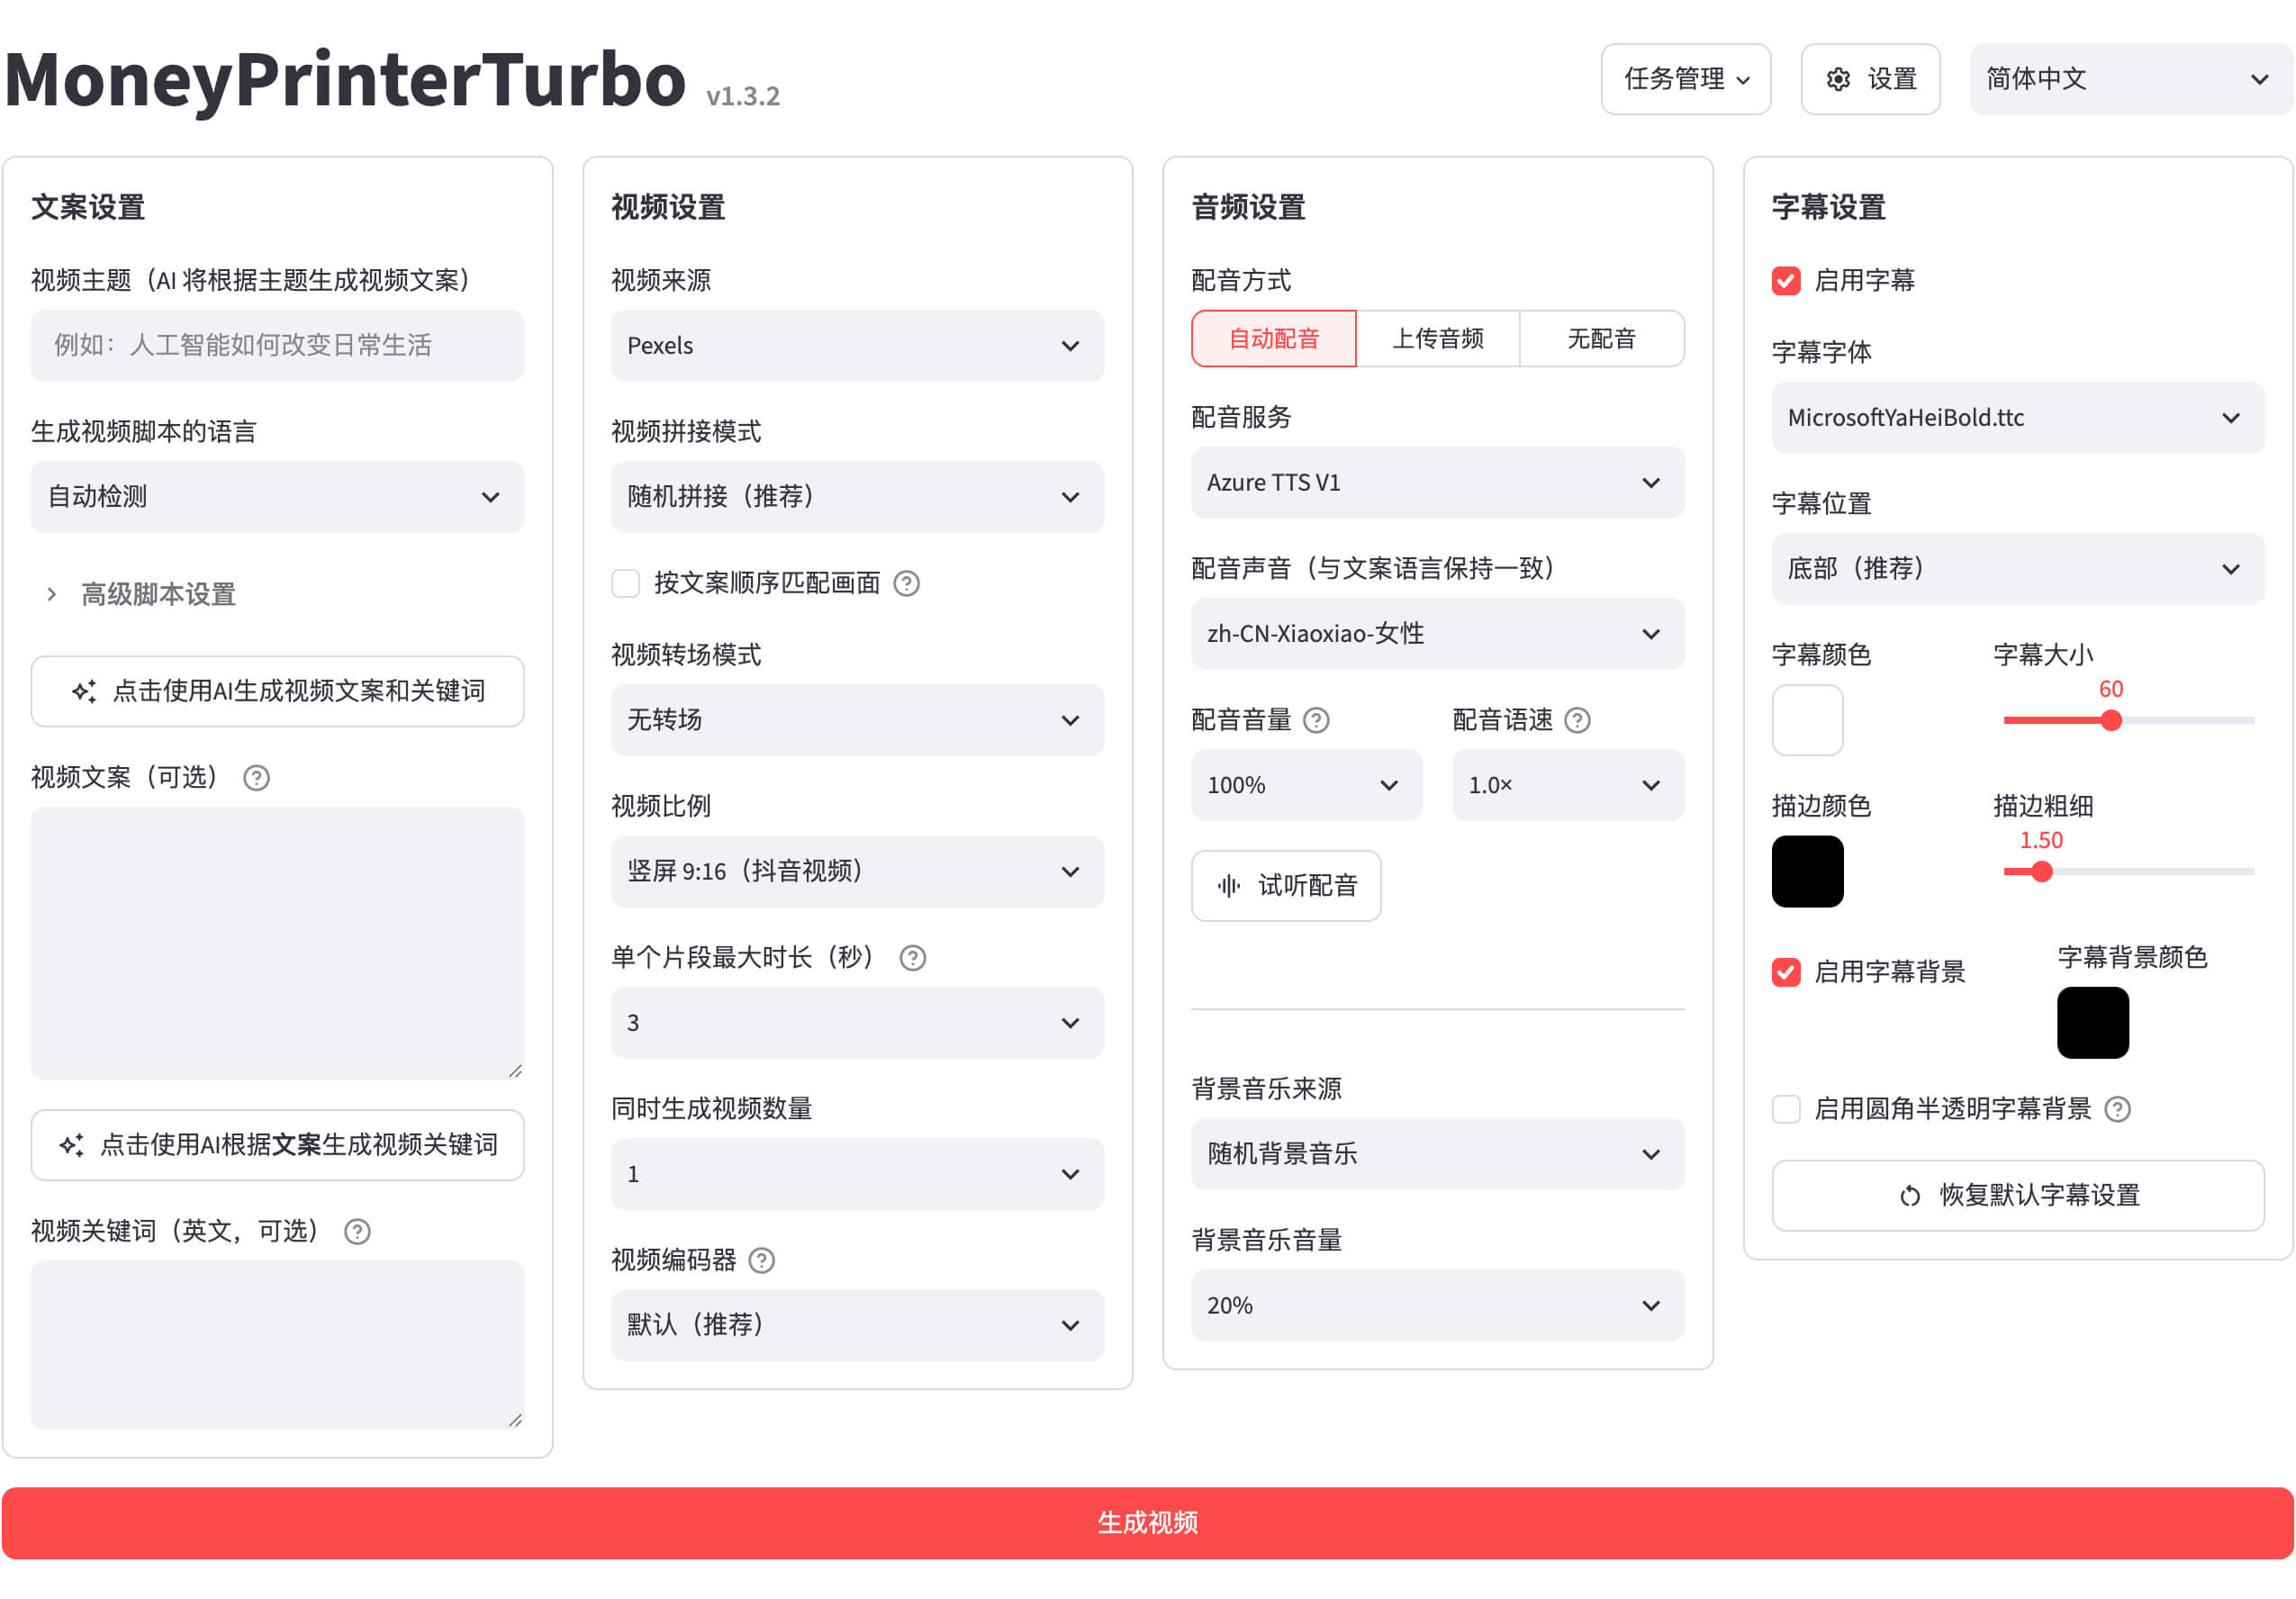
1. 痛点突围:它究竟击穿了什么工程死穴?
短视频自动化领域的工程痛点长期集中于工具链极度碎片化。开发者构建一个批量产出系统,通常需要手动缝合文案生成服务、视觉关键词提取脚本、第三方图库爬虫、文本转语音引擎以及 FFmpeg 混流剪辑程序。任何一个环节的 API 协议变更或超时,都会导致整个批处理流水线崩溃。MoneyPrinterTurbo 放弃了脆弱的黑盒拼接,采用统一的 Agent 编排与模块化 API 接口,将复杂的创意产出过程收敛为确定性的数据流。
💡 架构核心洞见:通过将大模型的长上下文检索能力与多媒体生成原语直接绑定,该架构消除了传统剪辑流中繁琐的中间态数据清洗,实现了端到端的状态机托管。
2. 核心架构与底层数据流向解析
MoneyPrinterTurbo 采用经典的前后端分离与任务队列解耦设计。WebUI 或 CLI 终端作为前端交互界面接收用户的创作指令,后端解析模块负责对输入的关键词进行富化。长文本大模型在此阶段输出带时间戳的结构化剧本和对应画面的精准检索词,随后任务分发器将音视频渲染作业压入执行引擎。
[ Client / CLI / WebUI ] ---> [ Gateway / Parser ] ---> [ LLM Orchestrator (Kimi/DeepSeek) ]
                                                                   │
                                                                   ▼
[ Video Composer (FFmpeg) ] <--- [ Media Router (Minimax/OpenAI) ] <--- [ Task Dispatcher ]
在执行层,系统通过松耦合策略适配不同的底层供应商。文案处理、语音合成、图像/视频生成分别通过标准化接口抽象。无论是火山引擎的编解码能力还是 APItask 的异步轮询,均被封装在统一的策略类中。这种设计确保了更换底层大模型或生图服务时,核心业务编排代码保持完全静默,大幅降低了系统维护成本。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (MoneyPrinterTurbo) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 架构模式 | 模块化 API 统一调度与异步队列 | 脚本堆砌与手动文件搬运 | 闭环 SaaS 网页端操作 | 支持万级批量并行与私有化二次开发 |
| 模型适配 | 原生兼容 OpenAI 协议与多厂商聚合 | 绑死单一闭源厂商 SDK | 仅支持固定几个大模型 | 彻底摆脱供应商锁定,按需切换高性价比模型 |
| 部署成本 | 轻量化 Python 服务,支持 Docker | 依赖重型本地 GPU 工作站 | 昂贵的企业版订阅费用 | 零本地显卡开销,云端 API 按量结算 |
| 扩展能力 | 开放源代码,组件可插拔替换 | 修改困难,牵一发而动全身 | 接口封闭,无法接入私有工作流 | 开发者可在 2 小时内接入自定义 TTS 或音效库 |
表格对比结果表明,MoneyPrinterTurbo 在保持低部署门槛的同时,赋予了开发者对底层生产链条的绝对控制权。传统方案受限于固定的厂商生态,而该开源架构允许团队通过调整配置文件自由组合模型,在成本与成片质量之间寻找最优平衡点。
4. 手把手极客实操:从零构建最小闭环
在本地或服务器部署 MoneyPrinterTurbo 需准备 Python 3.10 及以上环境。执行以下命令拉取仓库并安装依赖:
# 克隆官方仓库到本地工作目录
git clone https://github.com/harry0703/MoneyPrinterTurbo.git

# 进入项目根目录
cd MoneyPrinterTurbo

# 创建并激活 Python 虚拟环境
python -m venv venv
source venv/bin/activate

# 安装核心运行依赖包
pip install -r requirements.txt
完成依赖安装后,复制配置模板并填入对应的大模型及媒体 API 密钥。以下为调用核心生成逻辑的 Python 最小闭环脚本:
# 导入 MoneyPrinterTurbo 核心工作流模块
from app.config import config
from app.services import workflow

def run_minimal_pipeline():
    # 定义短视频主题与核心参数
    video_topic = "人工智能如何重构现代软件工程"

    # 初始化配置上下文
    cfg = config.load()

    # 触发端到端异步生成流水线:文案 -> 语音 -> 素材 -> 合成
    print(f"[INFO] 正在启动主题生成任务: {video_topic}")
    task_id = workflow.start_generation_task(
        topic=video_topic,
        language="zh",
        voice_name="zh-CN-XiaoxiaoNeural"
    )

    print(f"[SUCCESS] 任务已投递,当前任务ID: {task_id}")

if __name__ == "__main__":
    run_minimal_pipeline()
运行上述脚本后,终端将输出任务投递成功的状态码。系统会自动调用大模型生成分镜脚本,并通过配置的语音服务与视频素材接口拉取对应媒体文件,最终在输出目录生成完整的 MP4 格式成片。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
⚠️ 避坑预警:异步 API 轮询超时:在处理长视频或高并发批量生成任务时,部分第三方视频生成 API 会出现任务排队超时。解决方案是在任务调度层引入指数退避重试机制,并将单次渲染任务拆解为小片段并行提交。
⚠️ 避坑预警:Token 账单失控风险:使用长文本大模型(如 Kimi K3)生成复杂剧本时,若未对输入关键词的上下文长度进行截断限制,极易触发高额 API 费用。建议在网关层设置单次任务的 Token 消耗硬阈值,并对高频调用的提示词模板进行静态缓存。
生产环境中的稳定性取决于对第三方供应商响应延迟的容忍度。开发者在进行二次开发时,应当为音频合成和视频渲染节点配置独立的本地缓存目录,避免因网络抖动导致已生成的中间媒体素材丢失。