
1. 痛点突围:它究竟击穿了什么工程死穴?
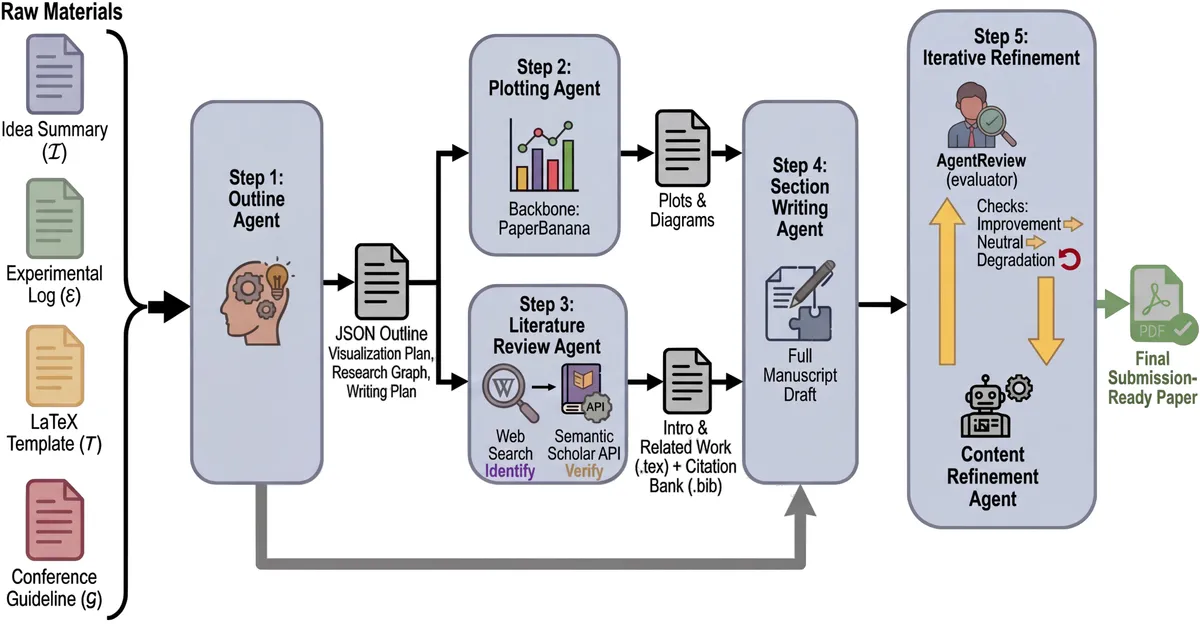
AI 领域的研究人员长期被琐碎的论文撰写流程拖累,代码实现与实验日志往往无法直接转化为逻辑严密的学术文本。传统的单次提示词生成方案缺乏状态管理,输出的 LaTeX 代码常常伴随排版断裂、文献缺失以及图表丢失等硬伤。paper-orchestra 引入了多 Agent 任务协同设计,把整个写作过程拆解为大纲规划、文献合成、章节编写、内容反思与绘图渲染等独立子任务,从根本上解决了长文本生成的幻觉与结构失控问题。
💡 架构核心洞见:通过将大语言模型嵌入专职 Agent 的状态机流转中,该框架避免了单体模型直接生成长文本时出现的上下文污染与逻辑断层。
2. 核心架构与底层数据流向解析
该项目的核心逻辑内聚于 methods/ 与 utils/ 目录中。框架接收原始材料目录与目标会议的 LaTeX 模板目录,随后通过统一网关分发给各功能 Agent。文献检索模块对接 Semantic Scholar API,动态筛选并组装背景引用。绘图代理与内容生成代理并行运转,最终将结构化文本与生成的图表注入 LaTeX 模板进行渲染。
[ CLI / Streamlit Demo ] ---> [ Raw Materials & Template Parser ] ---> [ State Manager ]
                                                                        │
         ┌──────────────────────────────────────────────────────────────┘
         ▼
[ Dynamic Execution Engine ] ---> [ Outline Agent ] ---> [ Literature Review Agent ]
                                                         │
                                                         ▼
[ LaTeX Compiler ] <--- [ Plotting Agent ] <--- [ Section Writing & Refinement Agent ]
底层执行流采用显式状态暂存机制,每个 Agent 的输出结果会经过校验模块的合规性检查,若检测到引用格式错误或逻辑断层,系统会触发反思代理进行局部重写。这种基于反馈的迭代闭环显著提升了生成文本的学术严肃性。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (paper-orchestra) | 传统单体 Prompt 方案 | 脚本拼接式工作流 | 生产环境收益 |
|---|---|---|---|---|
| 架构范式 | 多 Agent 协作与状态机 | 单次大模型调用 | Python 脚本串联 API | 降低单点崩溃概率,支持错误重试 |
| 文献接入 | 动态调用 Semantic Scholar | 依赖模型内部静态记忆 | 静态文献列表硬编码 | 确保文献时效性与引用准确率 |
| 模板适配 | 支持自定义 LaTeX 子文件夹 | 纯文本输出手动排版 | 固定单一模板 | 无缝对接目标会议排版标准 |
| 绘图能力 | 代码生成图表与概念图支持 | 仅输出文本描述 | 无原生绘图能力 | 自动化产出符合 IEEE/ACM 标准的插图 |
该架构通过解耦计算单元,将大模型的不确定性风险控制在局部 Agent 内部,避免了传统单体调用在处理十万字级学术大纲时的雪崩效应。
4. 手把手极客实操:从零构建最小闭环
环境初始化依赖 Conda 工具链,必须使用 Python 3.11 运行时。通过终端克隆仓库后,执行以下命令构建隔离的虚拟环境。
# 创建并激活专用的 Conda 运行环境
conda create -n paper_orchestra python=3.11
conda activate paper_orchestra

# 安装项目运行所需的全部依赖包
pip install -r requirements.txt
在项目根目录下创建 .env 配置文件,填入对应的大模型 API 密钥以及学术检索凭证:
SEMANTIC_SCHOLAR_API_KEY=your_semantic_scholar_api_key
OPENAI_API_KEY=your_openai_api_key
GEMINI_API_KEY=your_gemini_api_key
通过 Python 命令行直接启动论文生成流水线:
python paper_writing_cli.py \
  --raw_materials_dir /path_to_your_raw_materials/ \
  --latex_template_dir templates/cvpr2025 \
  --output_dir ./output_paper \
  --use_plotting true
执行成功后,目标输出目录下将生成完整的 LaTeX 源文件及编译所需的各类 .bib 与图表资产。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
大规模自动化生成 LaTeX 文件时,API 的并发请求限制与网络波动极易导致文献检索中断。开发者在配置 .env 文件时必须确保 Semantic Scholar 的配额充足,否则文献综述模块会降级运行,输出缺乏前沿引用的残缺文稿。
⚠️ 避坑预警 [API 速率限制]:高频调用文献检索接口时容易触发服务端的 429 频控封锁,建议在检索模块中加入指数退避重试策略并合理设置并发线程数。
LaTeX 模板的路径结构必须严格契合官方子文件夹规范。自定义会议模板时,若缺少必要的宏包声明,编译代理在最后阶段会抛出语法错误。
⚠️ 避坑预警 [模板编译报错]:自定义 LaTeX 模板放置于
templates/目录时,必须保证根目录下的.cls或.sty样式文件完整可用,避免因环境缺少宏包导致生成流程在终端卡死。