
1. 痛点突围:它究竟击穿了什么工程死穴?
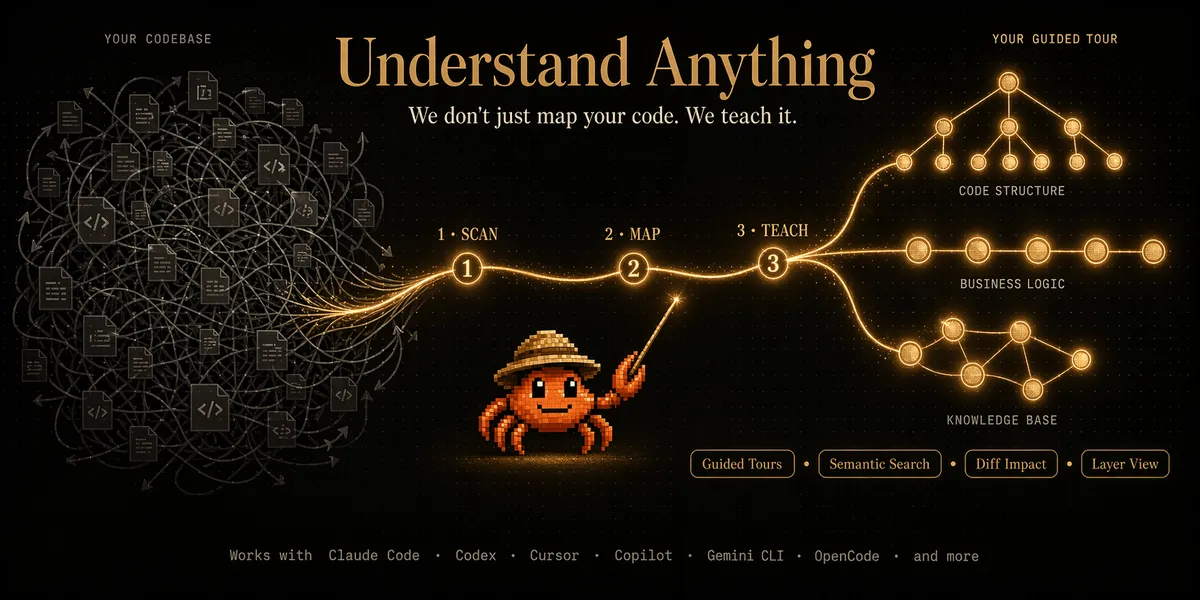
新开发者加入拥有 20 万行代码的复杂项目时,往往陷入无从下手的困境。传统的文本搜索与静态分析工具无法提供直观的宏观架构视角,导致团队成员花费大量时间梳理依赖关系和业务逻辑。Understand-Anything 放弃了单纯的文本检索范式,转而构建多代理流水线,直接从源码中提取文件、函数、类及依赖项,将其渲染为可视化的交互式知识图谱。
💡 架构核心洞见:通过将扁平的代码文本降维转化为多维图数据结构,把开发者的认知负担从线性阅读转移到空间拓扑探索上。
2. 核心架构与底层数据流向解析
Understand-Anything 的底层运行依赖于 Claude Code 插件生态。当用户在终端执行初始化指令后,多代理异步解析器会介入项目目录,进行语法树解析与实体抽取,随后将处理结果持久化存储。
[ Claude Code CLI ] ---> [ Multi-Agent Parser ] ---> [ Storage Layer (.ua/) ]
         │                                                       │
         ▼                                                       ▼
[ Interactive Dashboard ] <----------------------------- [ Knowledge Graph ]
在数据流转过程中,系统首先对全量代码进行冷启动扫描,生成基础知识图谱文件。后续的每次变更触发增量检测,只将修改过的内容送入代理管道更新局部图谱,从而有效控制 Token 开销并维持数据的一致性。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (Understand-Anything) | 传统实现范式 (IDE Symbol Search) | 典型竞品方案 (Standard LLM RAG) | 生产环境收益 |
|---|---|---|---|---|
| 架构呈现 | 交互式多维知识图谱 | 扁平文件树与符号列表 | 纯文本片段检索与拼接 | 建立全局空间认知,降低上手周期 |
| 增量更新 | 仅重分析变更文件的局部更新 | 每次实时索引,资源开销固定 | 每次需重新向量化全部语料 | 显著降低长期维护的 Token 成本 |
| 交互体验 | 浏览器端平移、缩放、点击节点 | 文本终端或 IDE 侧边栏跳转 | 聊天对话框式问答输出 | 提供直观的业务流程与依赖拓扑 |
| 隐私与本地化 | 支持对接 Ollama 等本地模型 | 完全本地运行,无网络依赖 | 强依赖云端大模型 API 接口 | 满足企业级严格的数据合规要求 |
该架构通过将图数据落地为本地 JSON 文件,避免了传统数据库部署的繁琐运维成本。前端通过轻量化 Web Dashboard 直接加载图数据,保证了复杂项目渲染时的流畅度。
4. 手把手极客实操:从零构建最小闭环
在本地开发环境中,确保已安装 Claude Code 插件运行环境。通过终端命令行加载插件并对目标项目执行解析操作。
# 将 Understand-Anything 插件添加到本地市场
/plugin marketplace add Egonex-AI/Understand-Anything

# 在当前项目环境中正式安装插件
/plugin install understand-anything

# 运行多代理扫描流水线,生成本地知识图谱
/understand --language zh

# 启动可视化交互仪表盘
/understand-dashboard
执行 /understand 后,系统会在当前项目根目录下生成 .ua/knowledge-graph.json 文件。随后启动 Dashboard,即可在浏览器中查看按架构层级分类的代码拓扑图。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
大型项目在首次执行全量扫描时,会产生较大的 Token 消耗,若直接使用默认云端大模型容易导致账单超支。
⚠️ 避坑预警 [Token 消耗陷阱]:首次运行
/understand会全量分析数十万行代码。建议在企业或大型代码库初始化时,通过 Ollama 对接本地模型提供算力支持,避免消耗过多的在线 API 配额。
团队协作场景下,自动生成的 .ua/ 目录需要正确配置版本控制策略,避免将本地临时状态污染公共仓库。
⚠️ 避坑预警 [版本控制污染]:
.ua/knowledge-graph.json包含特定环境的分析路径与元数据。建议将其加入.gitignore文件,或者团队统一通过 CI 流程按需生成。