
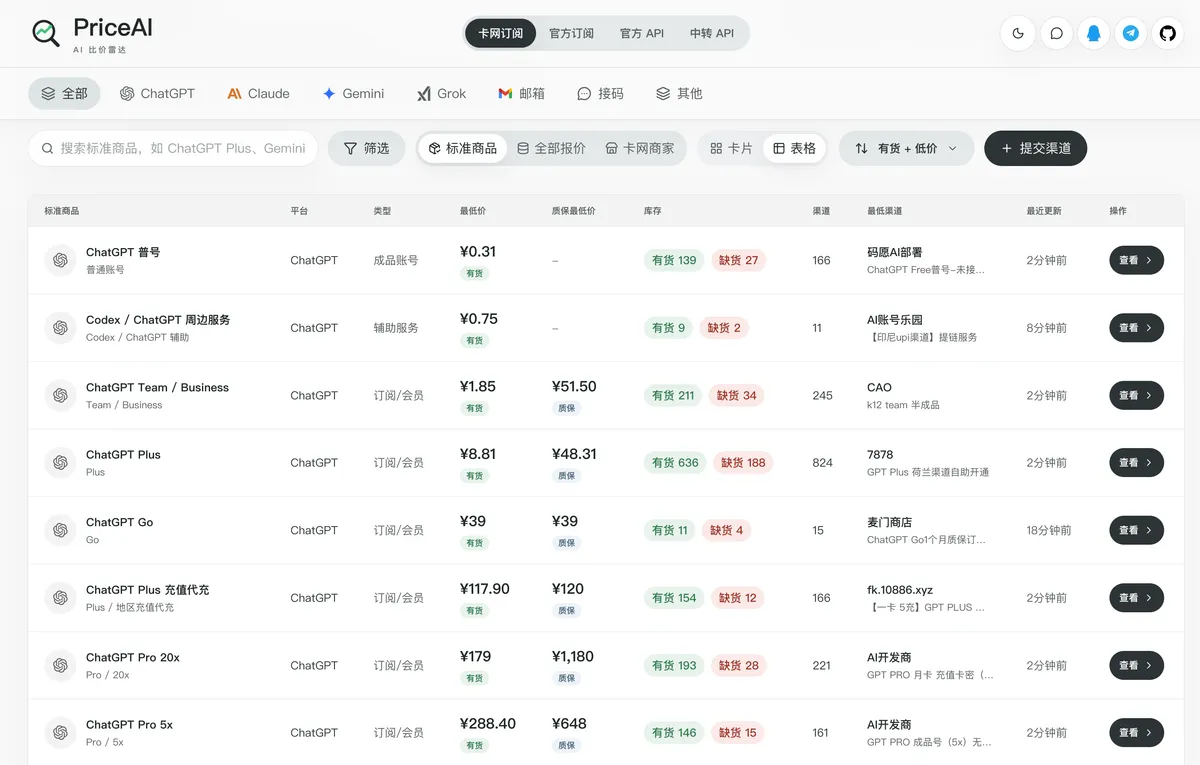
1. 痛点突围:它究竟击穿了什么工程死穴?
AI 生产环境的隐形成本长期被严重低估。对于高频调用大模型的全栈开发者、团队负责人以及个人创客而言,维持 ChatGPT Plus、Claude Pro、Gemini Advanced 等官方订阅,或者批量采购 DeepSeek、Qwen、Kimi 的官方 API 与第三方中转站额度,需要跨越极高的信息不对称鸿沟。官方地区价随汇率与渠道浮动,App Store 与 Google Play 存在策略差异,而 200 多家自动发货卡网、Telegram 渠道、闲鱼代充和网关站点的价格命名极度混乱。商品标题中的代充、成品号、卡密、CDK 往往混淆了底层交付安全边界。
PriceAI 的破局点在于放弃交易闭环,转而定位为纯粹的采购前决策基础设施。它不碰资金、不接支付、不替任何第三方渠道担保,而是通过数据采集、结构化清洗与有货最低价过滤,把散落在全网的非标报价拉齐到同一基准线上。开发者在接入任何大模型资源前,能够直接看清官方底价与第三方渠道的真实溢价空间,从而在算力消耗与财务预算之间找到工程平衡点。
💡 架构核心洞见:用元数据归一化和独立模型探针替代传统的肉眼比价,将非标的卡网订阅与网关倍率转化为可编程、可核验的消费级证据链。
2. 核心架构与底层数据流向解析
PriceAI 采用 Next.js 构建前台展现与管理后台,配合 Supabase 承载结构化持久层。其底层架构的核心难点在于非标异构数据的清洗与关联。官方订阅、卡网发卡站、官方 API 计费口径、中转网关倍率在物理世界中具有完全不同的数据形态和更新频率。
系统通过定时采集脚本或人工审核通道吞吐外部报价。数据进入核心归一化流水线后,会被拆解映射为标准商品、标准模型和标准站点。过滤层会剔除缺货、隐藏、未审核或长期无响应的异常条目,确保最终暴露给前端的最低价指标具备实际交易意义。
[ Public Sources / User Submissions ] ---> [ Collector & Parser ] ---> [ Admin Review Pipeline ]
                                                                           │
                                                                           ▼
[ Detection Service Engine ] <---> [ Supabase DB & Standard Mapping ] <---> [ Next.js Frontend ]
针对 API 中转站的验证需求,系统独立维护了基于 veridrop 协议修改的检测服务。当前端向 /api-transit/detector 提交临时 Key 和目标模型名时,主站将请求分发至独立容器集群。该独立服务执行 OpenAI、Claude、Gemini 等多协议探针,对中转站的响应延迟、支持协议、能力边界与计费倍率进行黑盒探测,最终生成结构化证据报告写入展示页。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (PriceAI) | 传统实现范式 (Telegram群/闲鱼) | 传统比价表格 (Notion/Excel) | 纯人工盲测方案 | 生产环境收益 |
|---|---|---|---|---|---|
| 数据更新频次 | 自动化脚本与定时采集 | 人工刷屏,极度滞后 | 手动维护,天级延迟 | 临时测试,无沉淀 | 避免采购过期失效的低价额度 |
| 风险披露机制 | 严格剥离广告,独立风险标签 | 无边界包装,信息失真 | 无自动化风控拦截 | 无法量化上游来源 | 降低账号封禁与数据泄露概率 |
| 异构数据对齐 | 标准商品、模型与站点映射 | 命名混乱,无法横向比较 | 字段定制简陋,缺乏关联 | 无统一协议探针 | 消除同名不同质的采购陷阱 |
| 验证能力集成 | 集成独立中转模型检测探针 | 依赖商家口头承诺 | 无法验证中转真实倍率 | 耗费大量 API 调试成本 | 毫秒级洞察网关协议与计费真实性 |
| 部署与二次开发 | 开源自托管,支持 Supabase | 闭环黑产或私聊交易 | 协同效率低下,版本冲突 | 无法团队共享决策资产 | 具备高扩展性的工程基建底座 |
这套技术选型彻底将原本充满灰色地带的 AI 资源采购拉入工程化管理轨道。通过将非结构化文本映射为可过滤的数据库记录,系统消除了人工搜集信息时产生的盲目试错成本。
4. 手把手极客实操:从零构建最小闭环
在本地开发环境中拉起这套比价雷达,只需完成基础依赖安装并配置对应的 Supabase 环境变量。若未连接外部数据库,系统会自动降级加载内置演示数据,供开发者直接评估前端交互与后台管理逻辑。
# 克隆官方仓库到本地工作区
git clone https://github.com/dimthink/PriceAI.git
cd PriceAI

# 安装项目运行所需的 npm 依赖包
npm install

# 复制环境变量模板并填入本地配置
cp .env.example .env.local

# 启动本地开发服务器
npm run dev
以下是通过 Node.js 脚本触发价格采集或执行后台任务的典型代码片段。开发者可以通过命令行直接调用数据采集器,实现特定渠道的增量抓取与持久化推送:
import { execSync } from 'child_process';

/**
 * 触发指定卡网渠道的价格采集脚本
 * @param sourceId 目标渠道唯一标识符,对应配置表中的来源代号
 * @param postFlag 是否在采集完成后直接推送到审核或发布状态
 */
function runPriceCollector(sourceId: string, postFlag: boolean = true): void {
  const command = `npm run collect:prices -- --source ${sourceId} ${postFlag ? '--post' : ''}`;

  console.log(`[PriceAI Engine] Executing collection task for source: ${sourceId}`);

  try {
    const output = execSync(command, { encoding: 'utf-8' });
    console.log('[Collector Output]:\n', output);
  } catch (error: any) {
    console.error(`[Collector Error] Failed to execute source ${sourceId}:`, error.message);
    process.exit(1);
  }
}

// 执行示例:采集 aisou-pro 渠道报价并自动发布
runPriceCollector('aisou-pro', true);
运行成功后,访问 http://localhost:3000 即可进入前台比价雷达页面,访问 http://localhost:3000/admin 进入后台管理面板进行来源审核与站点资料维护。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在生产环境部署 PriceAI 或复用其采集与检测逻辑时,必须注意以下工程陷阱。由于第三方卡网与 API 中转站的网页结构和接口频频变更,自动化采集模块极易遭遇反爬策略拦截或 DOM 结构漂移。
⚠️ 避坑预警 1:第三方卡网反爬与 IP 封锁:高频抓取 200+ 卡网和发卡站极易触发 Cloudflare 或各站点的 WAF 防御。解决方案是为采集器配置动态代理池,并将单站抓取时间间隔拉大至合理区间,避免因集中并发导致本地出口 IP 被永久拉黑。
⚠️ 避坑预警 2:中转模型检测服务的 Token 消耗与滥用:内置的
priceai-detector-service会向目标中转站发送真实测试请求。若开放给公网匿名用户无限制调用,极易被恶意攻击者当作免费测试工具,导致测试 Key 额度瞬间耗尽或遭受 DDoS 攻击。生产环境务必在主站网关层加入严格的 Rate Limiting 以及人机验证关卡。
维持数据源的干净与低价有效性需要团队持续的人工介入。自动化脚本仅能解决 80% 的结构化输入,剩余的 20% 风险边界与服务条款确认,依然依赖社区成员与架构师自身的审慎判断。