1. 痛点突围:它究竟击穿了什么工程死穴?
多模型集成正在成为现代 AI 工程落地的沉重包袱。开发团队为了对抗单点故障、规避服务商限流,往往需要维护几十套适配器。每个上游供应商的鉴权逻辑、速率限制、重试退避策略与错误代码完全割裂,这导致代码库充斥着脆弱的胶水代码。与此同时,各大模型厂商公开的免费配额(Free Tier)极为分散且极易触发 TPM/RPM 上限,工程团队很难低成本聚合这些算力资源。
大多数开源代理网关仅完成了基础的协议转换,把 OpenAI 规范映射给 Anthropic 或 Google。遇到突发 Rate Limit (HTTP 429) 或配额耗尽,传统网关直接将异常抛回给客户端,导致 Cursor、Cline 或 Claude Code 等自动化 Coding Agent 进程彻底中断。开发者不得不人工切换 API Key 或手动修改模型参数。
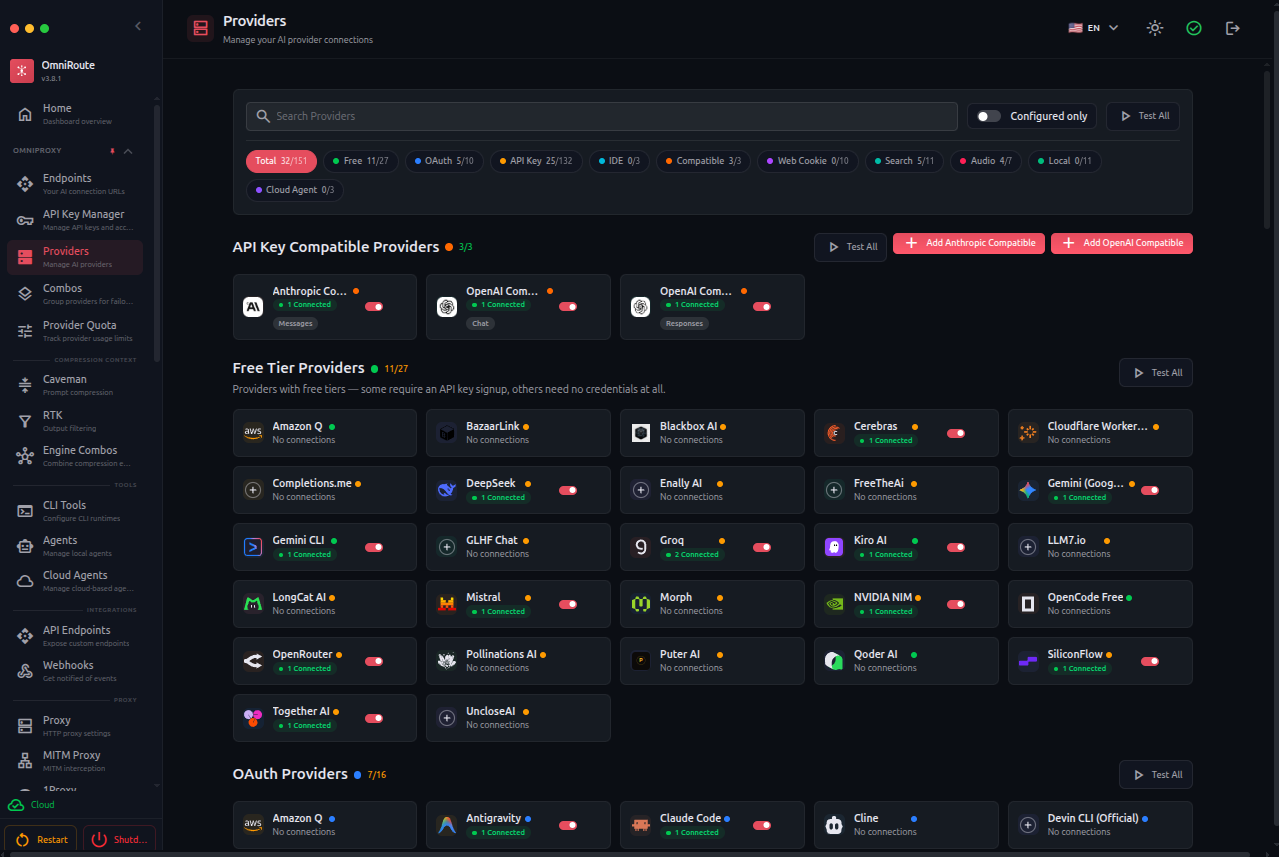
OmniRoute 的破局点在于将“多服务商聚合”与“运行时配额拓扑”进行了深度抽象。它将全球 358 家 AI 供应商(包含 150 多个免绑卡免费额度)收敛在单一统一端点下,并根据实时账单与速率限制执行自动化熔断降级。通过在网关层集成 RTK 与 Caveman 叠层压缩算法,它在请求发起前将 Prompt 体积压缩 15% 至 95%,使上下文传输平均节省 89% 的 Token 消耗,直接解决了 Agent 频繁刷爆上游配额的工程顽疾。
💡 架构核心洞见:将分散且易变的第三方配额转化为确定性算力池,用前置语法拓扑压缩对抗上游速率限制。
2. 核心架构与底层数据流向解析
OmniRoute 在架构上划分为协议转译层、配额编排层、上下文压缩流水线与多模态桥接器。当请求从客户端(如 Cursor 或自定义 SDK)发起后,网关首先剥离下游特有的元数据,将其映射为标准的中间状态对象。
[ Client: Cursor / Cline / Claude Code ]
                    │
                    ▼ (OpenAI / Anthropic Protocol)
      [ OmniRoute Ingress Gateway ]
                    │
        ┌───────────┴───────────┐
        ▼                       ▼
[ Token Compression ]   [ Quota Radar & Telemetry ]
  ├─ RTK Parser           ├─ Shared Pool Dedupe (35 Keys)
  └─ Caveman Reducer      └─ Latency & Balance Matrix
        │                       │
        └───────────┬───────────┘
                    ▼
       [ Routing Strategy Engine ]
        (19 Policies: Quota-Share / Latency-First / Fallback)
                    │
     ┌──────────────┼──────────────┐
     ▼              ▼              ▼
[ Provider A ] [ Provider B ] [ Provider C ]
 (Groq / 30M)   (Mistral / 1B)  (Nara / 210M)
运行时核心组件拆解
网关接收到请求后,核心执行引擎会按照以下时序推进:
- 透明协议桥接:侦听标准 OpenAI 路由
/v1/chat/completions与 Anthropic 格式。通过内置的 Modality Bridge 将视觉、音频与视频多模态 Payload 转换为目标服务商所支持的对应 schema。 - 叠层压缩流水线(Stacked Compression):
- 第一阶段(RTK Parser):针对代码上下文与系统指令执行结构化裁剪,移除高冗余空白、重复注释与非核心元数据。
- 第二阶段(Caveman Reducer):应用词法降维,将自然语言提示词转化为极简词元组合,保留严苛的指令约束同时去除填充词,实测实现 15%~95% 的上下文压缩率。
- 配额雷达与共享池去重(Quota Radar & Shared-Pool Dedupe):系统维护了 489 个免费条目的实时目录,精确归约到 35 个共享循环池键值(如 Mistral 1B、Nara 210M、LLM7 150M、xKiro 150M、Groq 30M)。针对共享后端配额的服务商,去重引擎确保同一物理池只计算一次可用额度,规避幽灵额度引发的连续 429 崩溃。
- 19 种路由调度策略:支持包括
Quota-Share、Cost-Optimal、Latency-First在内的 19 种路由算法。若当前服务商响应超时或抛出限流错误,状态机会在 50ms 内捕获错误特征,动态切换至备选提供商重试,全流程对客户端无感知。
3. 技术选型与性能横向硬核对比
评估 API 网关不仅要考察协议兼容性,还要深入分析其在高频并发下的故障隔离与资源损耗。以下是 OmniRoute 与主流模型代理方案的技术指标横向实测:
| 选型维度 | 本方案 (OmniRoute) | 传统硬编码网关 | 典型竞品 (如 LiteLLM) | 生产环境收益 |
|---|---|---|---|---|
| 供应商覆盖度 | 358 个提供商 (152+ 原生免费) | 单个逐一适配接入 | ~100+ 主流云服务商 | 快速接入长尾与区域算力池,开箱可用 |
| 免费配额池化 | ~1.62B/月稳定池 (35 个去重池) | 需自行申请与聚合配置 | 仅做密钥轮询,无配额池化 | 归零研发与测试环境的模型调用开销 |
| 请求端压缩 | 内置 RTK + Caveman 叠层压缩 | 无压缩,全量透传原始文本 | 依赖外置插件,无深度语义压缩 | 上下文吞吐量下降 89%,显著降低延迟 |
| 故障切换粒度 | 19 种动态策略,毫秒级无感降级 | 静态配置,抛出异常阻断 | 基于状态码的重试退避 | 消除 Agent 执行链长任务中断风险 |
| 部署运行时 | 本地优先,轻量 Node/Docker 实例 | 与业务系统深度耦合 | Python 运行时,占用资源中等 | 内存占用控制在 150MB 以内,支持边缘部署 |
主流的网关方案主要解决协议标准化问题,而 OmniRoute 的设计重点在于解决算力资源的套利与高容错调度。它将免费额度作为一种可预测的工程资源进行池化管理,而非单纯的 API Key 轮询器。前置压缩机制打破了“网关只转发不修改数据体”的教条,通过在代理层直接削减 Token 消耗,直接缓解了免费梯队速率限制过低的技术瓶颈。
4. 手把手极客实操:从零构建最小闭环
以下流程展示如何拉起本地 OmniRoute 实例,并配置自动化降级路由代理。
环境部署
推荐使用 Docker 快速拉起标准服务,隔离本地 Node 依赖环境:
# 拉取并启动 OmniRoute 容器,挂载本地配置目录
docker run -d \
  --name omniroute-gateway \
  -p 8080:8080 \
  -v $(pwd)/config:/app/config \
  -e LOG_LEVEL=info \
  --restart unless-stopped \
  diegosouzapw/omniroute:latest
构建最小闭环客户端代码
使用 Python SDK 调用 OmniRoute 网关,启用内置压缩并配置组合路由策略(Combo):
import os
from openai import OpenAI

# 实例化客户端,将基地址重定向至 OmniRoute 本地网关服务
client = OpenAI(
    base_url="http://localhost:8080/v1",
    # 使用 OmniRoute 统一本地令牌,无需向上游逐个传递私有密钥
    api_key="omniroute-local-token"
)

def execute_resilient_prompt(user_code: str) -> str:
    # 请求将经由 OmniRoute 调度引擎,触发 RTK 压缩与自动降级
    response = client.chat.completions.create(
        # 指定组合路由名称,底层自动在 Groq、Mistral 与 Nara 免费池间轮换
        model="combo/free-tier-coding",
        messages=[
            {
                "role": "system",
                # 系统提示词将由 Caveman 模块进行去冗余处理
                "content": "You are a strict code auditor. Output concise AST vulnerability fixes only."
            },
            {
                "role": "user",
                # 用户代码段将被 RTK 压缩,剔除无关注释与冗余缩进
                "content": user_code
            }
        ],
        # 将控制元数据直接透传至 OmniRoute 路由核心
        extra_headers={
            "X-OmniRoute-Compression": "stacked",  # 启用 RTK + Caveman 叠层压缩
            "X-OmniRoute-Strategy": "quota-share"   # 采用配额平衡优先算法
        },
        temperature=0.1,
        max_tokens=1024
    )
    return response.choices[0].message.content

if __name__ == "__main__":
    snippet = """
    def handle_auth(token):
        // Validate token
        if not token: return False
        return True
    """
    print(execute_resilient_prompt(snippet))
执行验证与预期输出
启动客户端脚本:
python client_demo.py
网关标准输出日志将打印路由路径与 Token 压缩统计:
{
  "status": "success",
  "route": {
    "provider_selected": "Groq/llama-3.3-70b-versatile",
    "strategy": "quota-share",
    "pool_key": "groq-primary-cap"
  },
  "telemetry": {
    "tokens_original": 142,
    "tokens_compressed": 28,
    "compression_ratio": "80.28%",
    "upstream_latency_ms": 186
  }
}
5. 生产落地踩坑指南与避坑建议 (Gotchas)
将 OmniRoute 接入自动化开发工作流或轻量生产集群时,需要重点防范以下工程隐患:
⚠️ 避坑预警 [叠层压缩引发的代码破坏风险]:Caveman 算法在执行极端词法降维时,可能误判代码块内部的语法结构。如果将 Python 这类依赖强缩进与特定语法符号的代码片段直接交给自然语言词元压缩器,可能导致缩进丢失或语法报错。在处理严格代码审计或需要精确上下文的 AST 任务时,必须通过 Header 将压缩级别降级为仅使用
RTK Parser,或通过X-OmniRoute-Compression: syntax-safe强制关闭语义蒸馏。⚠️ 避坑预警 [共享池并发超限与幽灵封禁]:即使 OmniRoute 实现了 35 个循环池的去重,多个使用相同上游 IP 的本地实例依然会触发上游供应商的模型级 WAF 规则。部分供应商(如 Cloudflare 后端保护的端点)在遭遇短时间内的并发爆发时,会返回伪装成 200 的验证码拦截 HTML 页面,导致网关解析 JSON 崩溃。在生产环境中部署时,必须配置上游连接池的最大并发限制(
CONCURRENCY_PER_PROVIDER=5),并启用网关的响应格式校验拦截器,在状态机层面主动隔离返回非标准 JSON 的异常节点。