
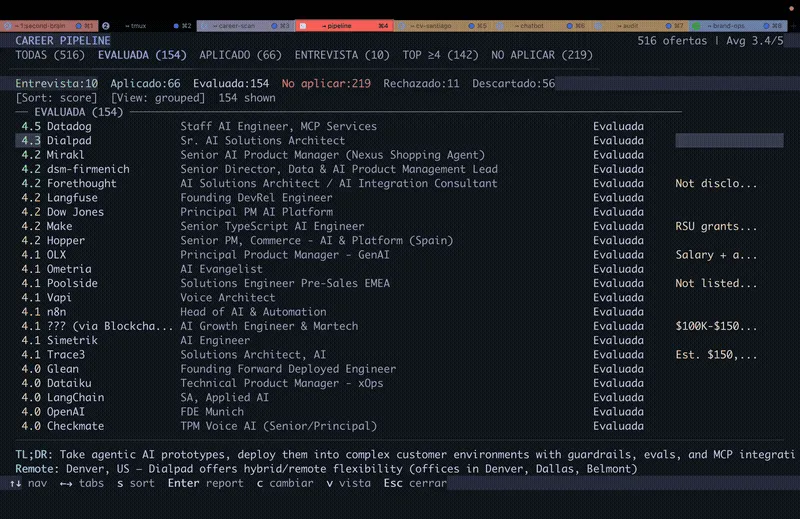
1. 痛点突围:它究竟击穿了什么工程死穴?
现代软件工程师在投递岗位时面对的是一堵高墙。招聘方利用自动追踪系统(ATS)部署关键词过滤算法,候选人则盲目堆砌简历发起海量攻击,双方在零和博弈中消耗大量算力与时间。这种黑盒式投递模式导致简历泥牛入海,反馈回路完全断裂。
career-ops 的破局思路极为克制。它拒绝开发云端 SaaS 平台去制造新的数据孤岛,而是选择将整个过滤逻辑下沉到开发者的本地终端。当开发者复制一条招聘链接时,本地代理直接介入,对职位有效性与技能契合度进行实时特征提取。系统在本地完成多维度对齐打分,不符合预期的直接拦截,保留下来的岗位则输出精确的履历适配方案与回答草稿。这种设计把原本不对称的信息差转换为了可由本地代码审计的确定性工作流。
💡 架构核心洞见:通过将招聘决策左移至客户端本地运行,career-ops 用确定性的状态机隔离了不可控的外部 ATS 噪声,重新建立起工程师对求职漏斗的绝对控制权。
2. 核心架构与底层数据流向解析
career-ops 采用清晰的分层解耦拓扑。整个系统由本地网关解析器、内存状态层以及动态执行引擎共同构成。开发者在终端输入单条指令后,底层流水线按照严格的生命周期管理触发任务调度。
[ CLI Terminal ] ---> [ Local Gateway / Parser ] ---> [ State & Memory Layer ]
                                                            │
                                                            ▼
                        [ Dynamic Execution Engine ] <------+|
输入端通过统一的解析适配器接收原始职位描述文本,清洗掉 HTML 噪声与冗余营销标签。状态层负责持久化候选人的基础资产,包含结构化简历、核心项目经历以及历史投递日志。执行引擎调度对应的推理模型进行向量空间匹配,输出具体的匹配得分、岗位存续状态和针对性修改策略。所有中间产物均序列化存储在本地文件系统中,完全杜绝第三方遥测泄露风险。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (career-ops) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 运行环境 | 本地 CLI 终端 | 网页端 SaaS 平台 | 云原生多租户应用 | 零隐私泄露与零服务器运维成本 |
| 数据所有权 | 100% 本地明文掌控 | 平台托管数据库 | 商业 SaaS 托管 | 杜绝简历数据被二次训练盗用 |
| 模型调用 | 支持本地离线模型运行 | 强依赖专有闭源 API | 绑定单一商业大模型 | 摆脱高额 Token 账单与网络延迟 |
| 自动化边界 | 辅助决策与草稿生成 | 全自动盲目海投 | 模拟点击填表 | 确保人类最终提交控制权,拒绝误操作 |
这套选型组合彻底剥离了商业化 SaaS 常见的中间商溢价。对于追求掌控力的开发者来说,放弃黑盒云服务转而使用纯本地执行栈,不仅消除了网络延迟,更在架构层面确立了数据安全边界。
4. 手把手极客实操:从零构建最小闭环
在 Node.js 运行环境中直接初始化并拉起 career-ops 代理环境。该命令会自动检查本地依赖项,并引导建立基础配置结构。
# 在终端直接拉起并初始化本地 career-ops 代理
npx @santifer/career-ops init
初始化完成后,可以通过以下核心脚本片段调度本地执行引擎,对目标岗位进行自动化特征比对与简历裁切:
import { CareerOpsEngine } from '@santifer/career-ops';

// 实例化本地代理引擎,注入基础配置文件路径
const engine = new CareerOpsEngine({
  configPath: './config/user-profile.yaml',
  localModel: 'llama3:8b' // 指定本地推理后端实例
});

async function evaluateTargetRole() {
  // 传入待评估的原始职位描述文本
  const rawJobDescription = await engine.fetchJobDescription('https://example.com/target-job');

  // 执行特征对齐与有效性过滤
  const analysisResult = await engine.evaluate(rawJobDescription);

  if (analysisResult.isFit) {
    // 生成针对该岗位的定制化简历区块
    const tailoredCv = await engine.tailorCV(analysisResult);
    console.log('匹配成功,已生成定制化履历文件:', tailoredCv.outputPath);
  } else {
    console.log('拦截成功:该岗位与当前技能栈契合度不足,节省本次投递开销。');
  }
}

evaluateTargetRole();
运行上述脚本后,终端会实时输出结构化的匹配评分。若判定结果为有效岗位,本地目录将直接生成经过特征重排的专属简历与问答草稿,等待人类开发者最终确认提交。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在本地化运行大模型和自动化解析流水线时,部分底层细节处理不当容易引发连锁故障。硬件资源分配与网络环境配置是高频翻车区。
⚠️ 避坑预警 本地模型显存溢出:当指定较大参数量的本地开源模型(如 70B 级别)进行简历解析时,未正确配置量化参数极易导致本地 GPU 显存耗尽或 CPU 推理陷入死锁。建议在低配开发机上默认回退至 8B 或 14B 的 Q4_K_M 量化版本,或者配置远端轻量 API 代理作为降级兜底。
⚠️ 避坑预警 原始 DOM 解析污染:直接抓取某些高度混淆的招聘网站页面时,未经清洗的乱码文本会严重污染嵌入空间,导致匹配得分出现系统性偏差。在传入执行引擎前,必须通过内置的清洗钩子过滤掉非正文的样式标签与动态脚本噪声。