
1. 痛点突围:它究竟击穿了什么工程死穴?
主流 AI 编码助手在实际生产环境中存在一个致命短语:会话重置。每次在终端敲下启动命令,代理面对的代码库都是一张白纸。它不知道昨天团队通过了什么技术方案,不清楚上周评审会上架构师对缓存策略做出的让步,更无法关联你与经理在 1:1 会议里确认的考核指标。开发者必须在每个全新的 Shell 窗口里重复交代背景、重述业务痛点。知识在零散的对话中蒸发,工程效率由于持续的上下文重建而被严重拉低。
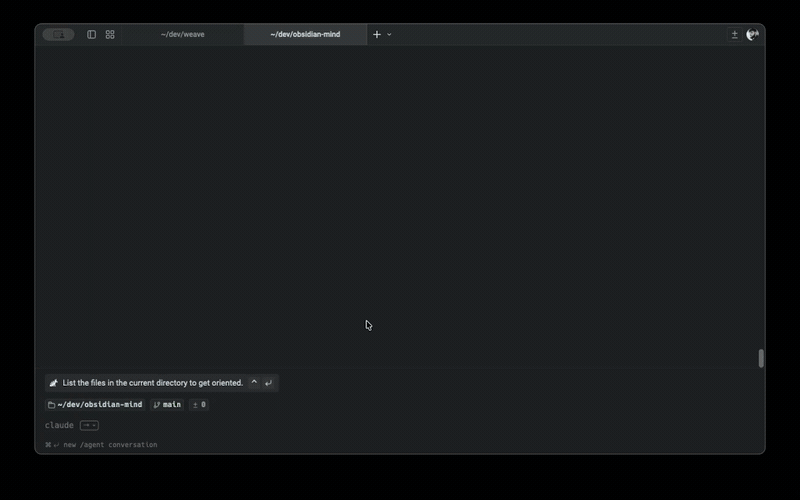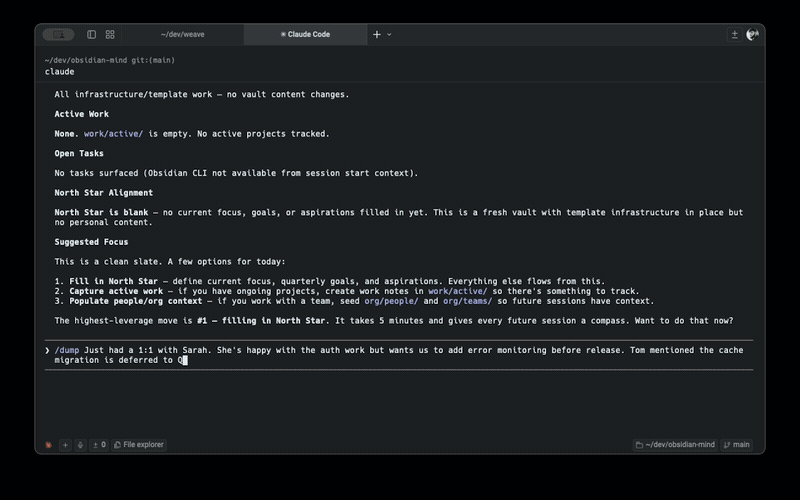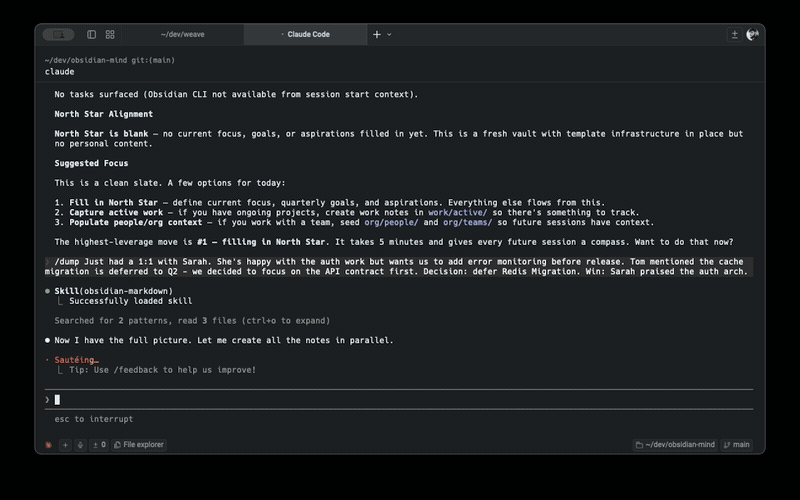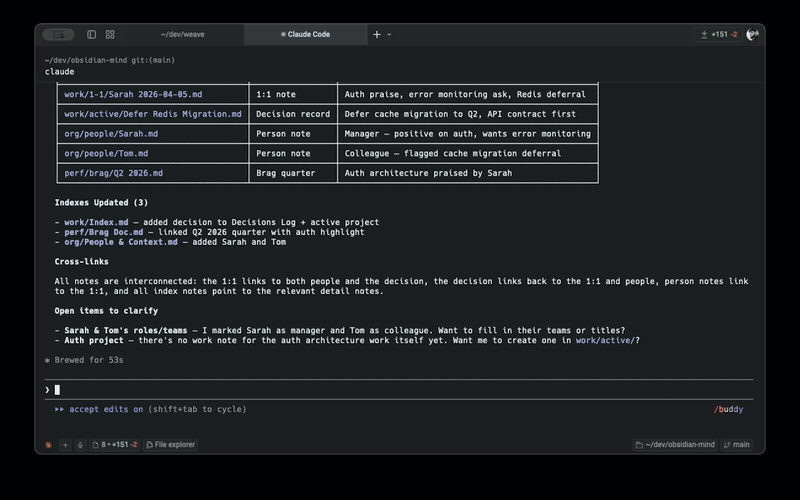
obsidian-mind 没有引入复杂的专有向量数据库,也没有将长效记忆锁死在某个商业闭环的 SaaS 服务中。它选择将现有的 Obsidian 知识库直接升级为代理的持久化大脑。通过标准目录结构、命令行工具集与 Model Context Protocol(MCP)的有机结合,代理在每次初始化时自动挂载项目白皮书、活跃任务与历史决策记录。会话不再是孤立的沙盒,而是变成了一条不断向下游累积知识的工程流水线。
💡 架构核心洞见:通过将本地 Markdown 仓库规范化为代理的底层长期记忆源,配合标准 MCP 工具暴露状态,绕过了第三方云端向量库的隐私风险与高昂的 API 账单。
2. 核心架构与底层数据流向解析
整个系统的运行依赖于输入端代理钩子、中转解析层与底层 Markdown 知识库的紧密咬合。当用户在终端发起交互时,初始化脚本首先会读取仓库中的核心元数据,将当前活动项目、未完成任务与最近的 Git 变更日志批量注入上下文。随后,Model Context Protocol 服务器在本地拉起统一的查询契约,让主对话与各类子代理能够以一致的工具调用方式访问向量索引。
[ User / Terminal CLI ] ---> [ ShardMind / Git Vault ] ---> [ SessionStart Hook ]
                                                                   │
                                                                   ▼
[ QMD Local Models ] <---> [ MCP Server Wrapper ] <---> [ Obsidian Markdown Vault ]
底层数据流向呈现出高度的模块解耦特性。QMD 检索模块在本地并行调度三个轻量级模型。embeddinggemma-300M 负责将笔记和自然语言查询转化为高维向量;qmd-query-expansion-1.7B 动态改写用户输入的模糊搜索词;最后的重排序模型则对召回结果进行精准过滤。整个计算过程不依赖外部网络,所有检索请求均在本地 SQLite 存储中闭环完成。通过将索引名称与仓库路径强绑定,多工作站场景下的多实例隔离得以完美实现。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (obsidian-mind) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 记忆持久化介质 | 本地标准 Markdown 文件 | 散落的聊天历史或私有数据库 | 云端知识库 SaaS | 文件完全掌控在本地,支持 Git 版本回溯 |
| 检索模型架构 | QMD 本地三模型流水线 (300M~1.7B) | 基础关键词 Grep 或远程闭环 Embedding | 依赖 OpenAI 远程 Embedding API | 零 API 费用,完全离线运行,无数据泄露风险 |
| 代理集成方式 | 原生支持 Claude Code、Codex、Gemini | 仅绑定单一 IDE 插件或网页端聊天框 | 独立桌面客户端应用 | 无缝融入现有终端工作流,无需切换上下文 |
| 部署与迁移成本 | 命令行一键初始化,极简无状态侧车 | 复杂的微服务部署与容器编排 | 繁琐的账号注册与数据导入导出 | 几分钟内构建最小闭环,开箱即用 |
这套技术选型的精妙之处在于拒绝过度设计。它没有引入笨重的数据库集群,而是利用工程师本就熟悉的 Markdown 作为存储交换格式,利用 Git 实现多端同步与版本控制,用本地小模型满足语义检索的精度需求。这种架构在工程可维护性与功能完整性之间取得了完美的平衡点。
4. 手把手极客实操:从零构建最小闭环
在开始构建持久化记忆库之前,确保本地已经安装了 Node.js 运行环境以及 Obsidian 客户端。通过全局安装 ShardMind 包管理器,能够快速拉取并初始化仓库模板。
# 全局安装 ShardMind 模板管理器
npm install -g shardmind

# 创建并进入一个全新的本地知识库目录
mkdir my-obsidian-mind && cd my-obsidian-mind

# 执行初始化向导,拉取仓库并配置核心参数
shardmind install github:breferrari/obsidian-mind

# 安装本地语义检索工具 QMD
npm install -g @tobilu/qmd

# 运行引导脚本,构建本地 SQLite 向量索引与嵌入
node --experimental-strip-types .scripts/qmd-bootstrap.ts
完成上述命令后,使用 Obsidian 打开该目录作为本地 Vault。在 Obsidian 的设置中开启 CLI 支持,随后在终端中直接启动 Claude Code 代理。此时代理将自动读取 brain/North Star.md 中的目标设定,并在输入 /om-standup 时输出当前活跃项目的最新进展与待办事项。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在多设备间同步该知识库时,频繁的 Git 冲突可能会导致 .mcp.json 或本地 SQLite 索引文件损坏。建议在 .gitignore 中明确排除 .qmd/ 等本地构建缓存目录,仅对纯 Markdown 笔记进行版本追踪。每次在多台机器间切换工作环境后,必须重新执行一次引导脚本以重建本地嵌入索引。
⚠️ 避坑预警 [索引版本漂移]:当批量导入大量历史笔记后,如果直接执行查询命令发现召回精度断崖式下跌,通常是由于未及时更新本地向量库导致的。必须在批量文件变动后手动执行
qmd --index <vault-name> update与embed命令同步状态。
另外,在启用多个代理并发读写同一 Vault 时,Obsidian CLI 的本地文件监听机制可能会产生瞬间的读写竞争。建议合理规划子代理的任务边界,避免多个自动化脚本同时对同一个 Decision Record 目录进行高频无锁追加写入。