
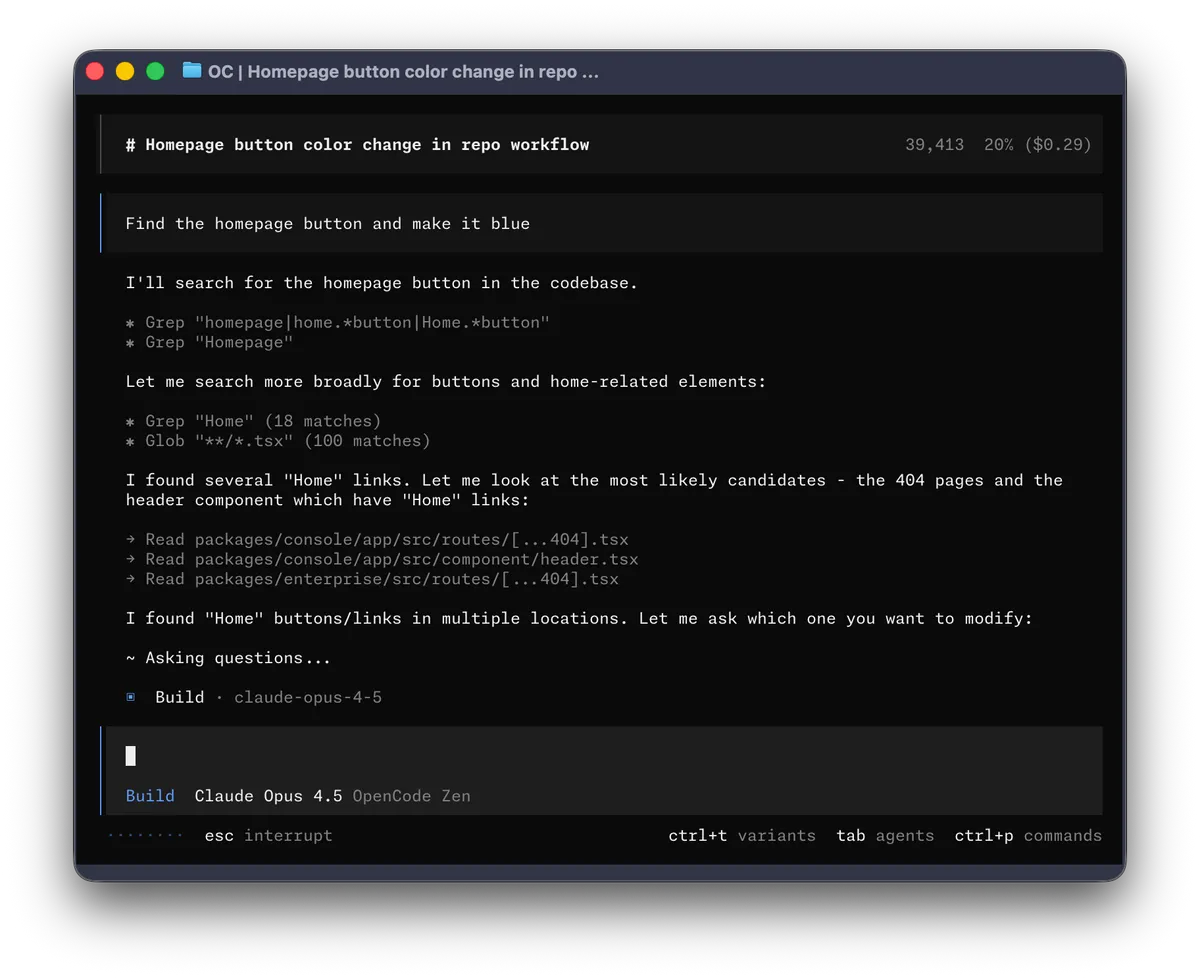
1. 痛点突围:它究竟击穿了什么工程死穴?
当前的 AI 编码辅助工具普遍存在严重的上下文脱节与权限失控问题。开发者在终端编写代码时,插件往往直接向核心源码注入未经审查的修改,导致版本控制系统频繁产生脏数据。opencode 采用双代理状态机隔离机制,将代码生成与代码探索权限严格解耦,阻断了危险指令在生产环境的盲目执行。
💡 架构核心洞见:通过将读写权限与行为意图绑定在状态机层面,opencode 强制 AI 在动手前先完成完整的代码库拓扑扫描。
2. 核心架构与底层数据流向解析
opencode 采用模块化分层架构,底层通过高并发解析器捕获终端输入,经由上下文路由层分发至对应的代理工作流。用户在界面中通过 Tab 键即可实时切换执行上下文,底层内存状态机动态维护当前仓库的符号索引,确保多步骤任务的状态一致性。
[ Terminal UI / Desktop ] ---> [ Gateway Parser ] ---> [ Context Router ]
                                                               │
                                                               ▼
[ Build / Plan Agent ] <---> [ Execution Engine ] <---> [ Memory Indexer ]
系统内置的 build 代理拥有完全的源码读写权限,适合日常高频迭代;而 plan 代理则强制开启只读模式,拦截所有写操作,并在执行任何 bash 指令前触发交互式确认。这种设计在保证工程效率的同时,构筑了严密的资安防线。
3. 技术选型与性能横向硬核对比
| 选型维度 | 本方案 (opencode) | 传统实现范式 | 典型竞品方案 | 生产环境收益 |
|---|---|---|---|---|
| 权限控制 | 双代理状态机隔离 | 单一全局全权限 | 插件级沙箱限制 | 杜绝意外篡改关键源码 |
| 终端集成 | 原生 TUI / 桌面端 | 依附 IDE 进程 | 独立网页端界面 | 零切换成本保持终端流 |
| 分发机制 | 多平台一键安装脚本 | 手动配置环境变量 | 闭源应用商店分发 | 极速部署自动化升级 |
| 状态维护 | 本地符号索引内存驻留 | 每次重新抓取全量文件 | 云端托管向量数据库 | 降低延迟与隐私泄露风险 |
opencode 放弃了笨重的云端大模型托管中转形态,直接在本地运行轻量级解析与路由逻辑。这使它在保证复杂多步任务执行精度的同时,将网络交互带来的冷启动延迟压缩至极限。
4. 手把手极客实操:从零构建最小闭环
在类 Unix 生产环境中,直接通过官方提供的自动化安装脚本拉取最新二进制文件。该脚本会自动检测操作系统架构,并将可执行文件挂载至符合 XDG 标准的路径中。
# 通过官方一键脚本在 Linux 或 macOS 生产机上部署 opencode
# 脚本会自动检测系统架构并完成二进制文件的安全落盘
curl -fsSL https://opencode.ai/install | bash

# 或者使用 Homebrew 进行版本托管安装(推荐,便于后续自动化升级)
brew install anomalyco/tap/opencode

# 验证安装是否成功并查看当前内核版本
opencode --version
安装完成后,在目标代码仓库根目录下直接启动终端交互界面:
# 启动交互式 TUI 界面并加载当前目录的符号索引
opencode
启动后,默认处于 build 代理模式。按下 Tab 键即可无缝切换至 plan 模式,用于审查陌生代码库的依赖拓扑结构,确保后续的所有修改均在安全边界内进行。
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在生产环境大规模部署时,必须对代理的内存占用与并发调用进行精细化调优。以下是真实业务场景中沉淀的避坑守则:
⚠️ 避坑预警 0.1.x 旧版冲突:在执行全新安装前,必须彻底卸载所有 0.1.x 时代的旧版本二进制文件与配置缓存,否则会导致命令解析器路径冲突。
⚠️ 避坑预警 规划模式越权:虽然 plan 代理默认拒绝文件修改,但在高并发多步骤任务中使用
@general子代理时,仍需显式限制其 bash 执行权限,防止自动化脚本触发高危删除命令。