1. 痛点突围:它究竟击穿了什么工程死穴?
传统搜索引擎优化工作流长期被昂贵的 SaaS 平台垄断。Ahrefs、Semrush 或 Screaming Frog 这类中心化工具往往依赖预设的爬虫矩阵,用户必须在 Web 仪表盘与 IDE 之间频繁切屏。这类方案最大的弊端在于输出结果充斥着泛化的模糊建议,工程团队拿到成百上千条告警后,依旧需要人工反查代码库排查原因。面对近两年兴起的大语言模型搜索抓取(Perplexity、SearchGPT、Google AI Overviews),传统爬虫甚至完全缺失对 llms.txt、IPTC AI 图像元数据标记以及 Agentic 可读性的校验能力。
AgriciDaniel 开源的 claude-seo 切入点非常毒辣:它直接嵌入 Anthropic 的终端研发环境 Claude Code,将整个站点的技术审计转化为终端本地可编排的 Agentic Pipeline。它不再把 SEO 当作纯粹的营销文案检测,而是作为前端架构、Schema 元数据、网络协议与 AI 检索可引用性(Citability)的综合工程测试框架。
💡 架构核心洞见:将 SEO 深度重构成代码库的自动化验收测试(E2E Testing),借由 19 个垂直领域的 Specialist Agent 在终端本地并发打散执行,输出具备可证伪性(Falsifiable)的代码级整改指令。
项目抛弃了传统“打分即结束”的虚荣指标设计。每次运行 /seo audit 生成的清单中,每一项建议都附带了 Google 开发者一阶信源(Primary Source)、前置依赖链路,以及明确的“失败检验判据(How would we know this failed?)”。工程师可以直接在本地终端将审计结果无缝转换为 Git 分支上的补丁,消除了从报告到生产交付之间的沟通摩擦。
2. 核心架构与底层数据流向解析
claude-seo 依赖 Claude Code 的 Plugin 扩展规范运作。整个工程架构由命令路由分发器、专有隔离运行时(Isolated Python venv)、无头浏览器采集集群(Playwright Chromium)以及 19 个垂直领域的 Sub-agents 协同组成。
[ Developer Terminal ]
         │ (e.g. /seo audit https://target.site)
         ▼
[ Claude Code CLI Plugin Host ]
         │
         ├─► [ Isolated Env Manager ] ──► [ Playwright Headless Cluster ]
         │                                  (DOM / SSR / Network Traffic)
         ▼
[ SEO Router & Orchestrator ]
         │
         ├─► [ Agent Fan-Out Dispatcher ]
         │         │
         │         ├─► Agent 01: Core Web Vitals (Agentic Category)
         │         ├─► Agent 02: Schema.org AST Parser & Deprecation
         │         ├─► Agent 03: GEO (Passage Citability / llms.txt)
         │         ├─► Agent 04: Content E-E-A-T & Machine Drift
         │         └─► ... [Up to 19 Parallel Sub-Agents]
         │
         ▼
[ Evidence & Falsifiability Engine ] ──► [ Google Official Spec Align ]
         │
         ▼
[ Local Markdown / Patch Generator ] ──► Output Action Plan to Repo
当执行触发命令时,插件会拉起专有的 Playwright Chromium 实例提取目标站点的动态渲染结果、请求链路与结构化数据。调度器随即激活最多 17 到 19 个 Agent 线程进行并行计算:
- 数据捕获层:Playwright 挂载到 Claude 数据持久化目录中的 Python 虚拟环境中,不向全局注入环境变量,规避主机环境污染。它捕获完整的 DOM 树、Response Headers、HTTP 状态码以及重定向链。
- 上下文路由与任务扇出:调度引擎将单次大任务按领域拆分。例如针对结构化数据,
Agent 02会利用专门构建的 Schema AST 解析器针对 Google 最新废弃规范执行过滤;Agent 03负责 GEO 协议,检验文本段落的回答浓度、llms.txt的路径合法性与 IPTCTrainedAlgorithmicMedia标记。 - 证据合成与可证伪性推演:每个 Agent 独立处理完特定维度后,将结果汇总至证据合成器,生成带有先行指标(Leading Indicator)的优先级建议树,把“如何验证修复结果”直接固化在标准输出中。
在架构权衡上,该方案舍弃了远程分布式抓取的便利性,换取了绝对的本地数据隐私与端到端代码联动能力。执行开销从中心化集群转移到了本地 CPU 与 Claude Token 计费之中。
3. 技术选型与性能横向硬核对比
把 claude-seo 放置于当前的站外 SaaS 与传统 CLI 工具坐标系中,各维度的技术权衡表现如下:
| 选型维度 | 本方案 (claude-seo) | 传统实现范式 (Screaming Frog) | 典型竞品方案 (Ahrefs / Semrush) | 生产环境收益 |
|---|---|---|---|---|
| 运行时与架构 | Claude Code 原生插件 + Playwright 本地沙箱 | 本地 Java 单体应用,本地重型 GUI | 闭源 SaaS,云端分布式定时爬虫 | 零数据外发风险,无缝结合本地 Git 仓库 |
| 分析并发范式 | 19 个 Sub-agent 驱动 26 组垂直技能并行扇出 | 多线程网络 IO,单体规则引擎串行分析 | 离线预计算批处理队列 | 站点综合审计周期从数小时压缩至数分钟级 |
| 新型 AI 搜索规范 | 原生覆盖 llms.txt、GEO 可引用性、Agentic 指标 |
仅提供基础元数据采集,无 AI 意图判定 | 依赖第三方估算,缺乏代码级适配方案 | 直接捕获 SearchGPT / Perplexity 等 AI 流量入口 |
| 建议交付形态 | 包含前置依赖、先行指标与可证伪检查的代码级建议 | 庞大的 CSV 导出表,需人工二次拆分 | 抽象的总体健康度分数与可视化仪表盘 | 研发可直接根据输出生成测试用例与补丁 |
claude-seo 彻底规避了传统爬虫将“数据导出给运营,运营再提工单给产研”的长链条损耗。它将 Web 质量保障对齐到单元测试级别的确定性,把 AI 时代不可或缺的 GEO 检查推向了工程流水线的第一线。
4. 手把手极客实操:从零构建最小闭环
官方提供了针对 Claude Code 1.0.33+ 版本的插件接入路径,以下为无破坏性的环境初始化与最小生产验证闭环。
环境安装与初始化
通过 Claude Code CLI 内置的市场注册通道引入官方源:
# 1. 注册开源仓库源
/plugin marketplace add AgriciDaniel/claude-seo

# 2. 安装插件包体
/plugin install claude-seo@agricidaniel-claude-seo

# 3. 初始化独立 Python 沙箱与 Playwright 内核 (无全局污染)
/seo setup

# 4. 执行健康诊断检查依赖状态
/seo doctor
自动化审计脚本与最小闭环
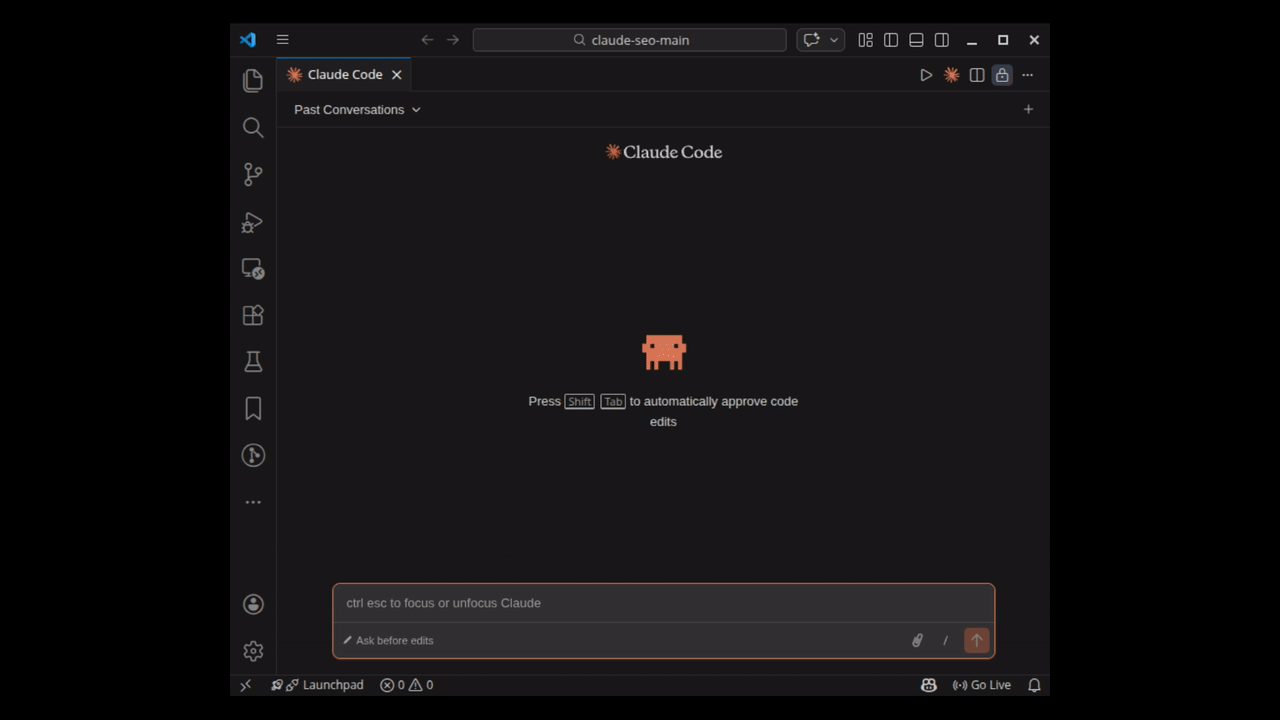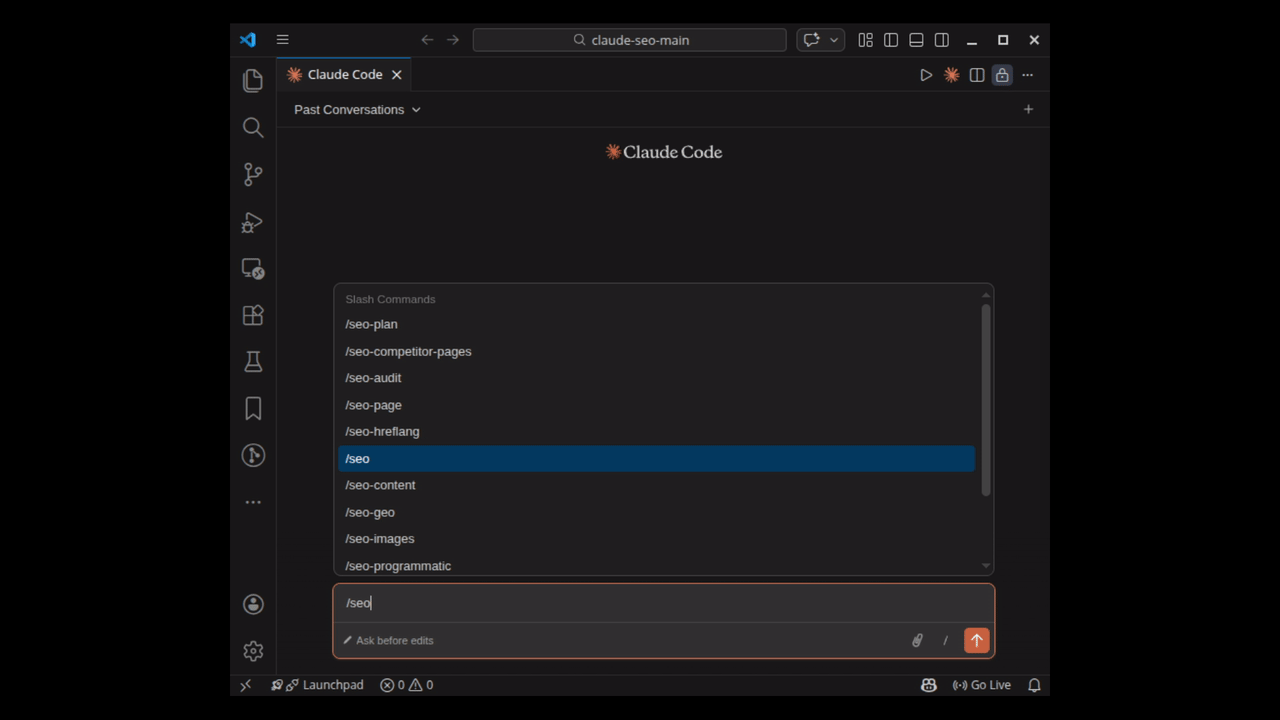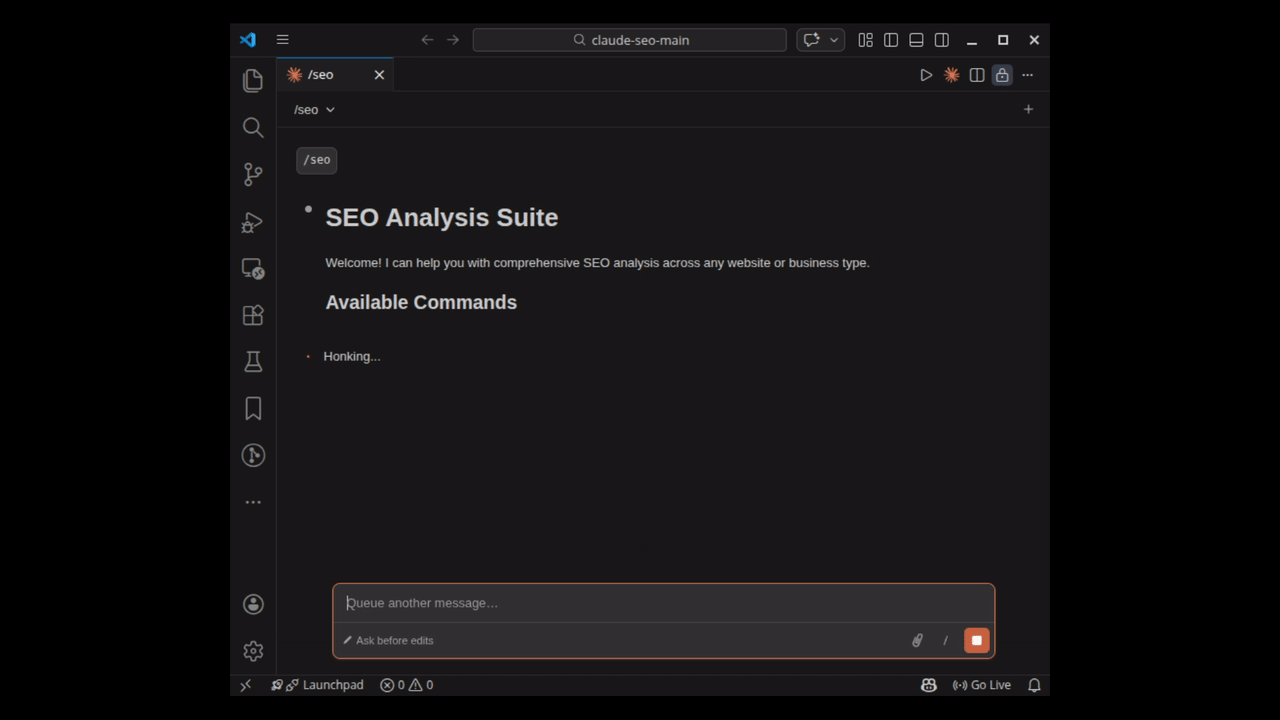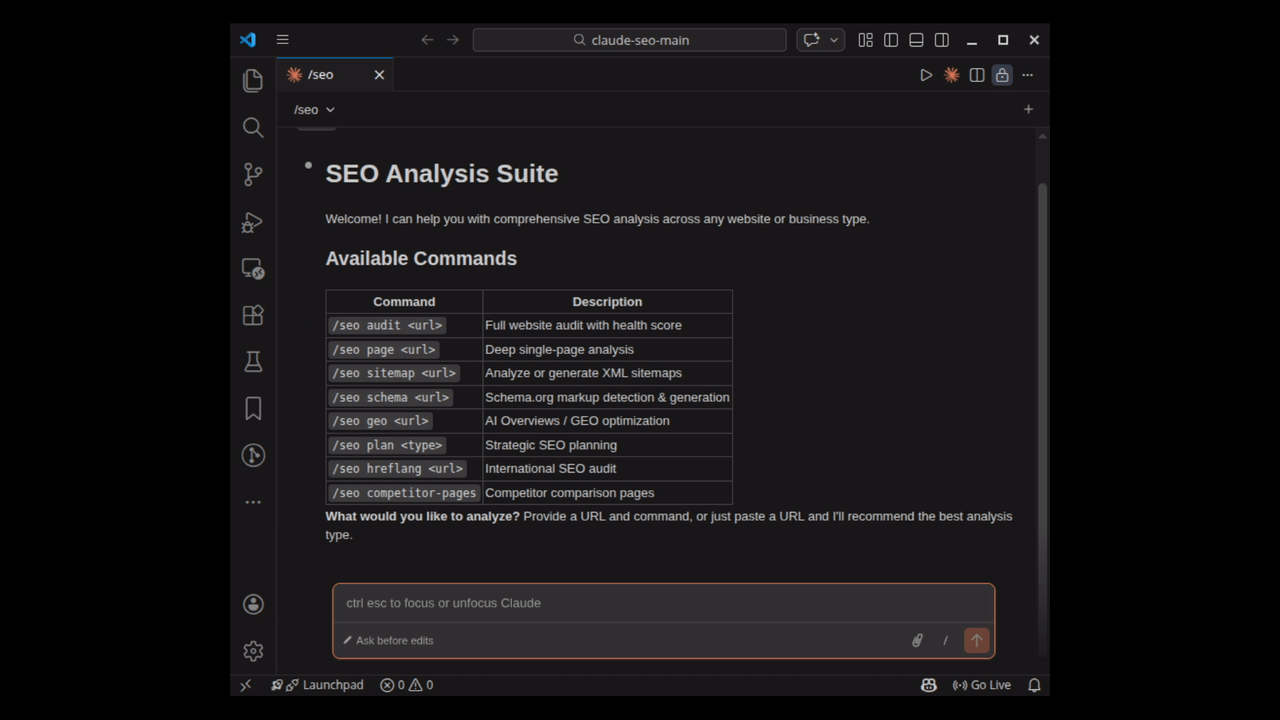
以下脚本展示如何在自动化 CI/CD 环境或本地终端中唤起 Claude Code,针对特定生产落地页发起包含技术性验证、Schema AST 解析与 GEO AI 评测的深度闭环:
#!/usr/bin/env bash
set -euo pipefail

# 定义被测目标与输出目录
TARGET_URL="https://example.com"
REPORT_DIR="./seo-reports"
mkdir -p "${REPORT_DIR}"

echo "[*] 启动 Claude Code 执行 SEO 深度工程扫描..."

# 通过非交互或指令模式向 Claude Code 投递任务
# 关键参数解释:
# /seo page: 触发单页多维度深度探测 (涵盖 DOM/SSR 与元数据)
# /seo schema: 解析 Schema.org 结构并检验 Google 废弃状态
# /seo geo: 执行大模型搜索可见性评测 (Passage Citability 与 llms.txt)
claude <<EOF
/seo page ${TARGET_URL}
/seo schema ${TARGET_URL}
/seo geo ${TARGET_URL}
/seo audit ${TARGET_URL}
EOF

echo "[+] 审计指令已提交,Playwright 采集引擎并发调度完毕。"
预期输出日志与结构化片段
在执行 /seo geo 或 /seo audit 后,终端会输出各 Agent 汇聚的优先级报告:
[+] 17 Specialist Agents Spawned Successfully.
── Priority Action Item 01 ──────────────────────────────
Category: AI Search Optimization (GEO)
Target: https://example.com/llms.txt
Observation: Missing primary-source documentation endpoint.
Citability Score: 42/100 (Failed passage extraction threshold)
Recommendation:
  - Expose a validated /llms.txt mapping key product architectures.
  - Apply IPTC TrainedAlgorithmicMedia tag on /assets/hero.webp.
Falsifiability Check:
  - Probe with Perplexity / Google AI Overview queries.
  - Verify llms.txt HTTP 200 response with text/markdown Content-Type.
Leading Indicator: 14-day increase in non-branded referral bot crawls.
─────────────────────────────────────────────────────────
5. 生产落地踩坑指南与避坑建议 (Gotchas)
在将 claude-seo 部署进大型单页应用(SPA)或大型矩阵站的流水线时,需重点关注以下底层机制引发的实际工程隐患:
⚠️ 避坑预警 [Playwright 容器沙箱与冷启动延迟]:在 Docker 或最小化 Linux 容器中执行
/seo setup时,Playwright Chromium 常因缺少系统级底层依赖(如libnss3、libgbm1、libasound2)出现静默崩溃。在容器基础镜像构建阶段,必须提前通过apt-get补全无头浏览器依赖包,避免在流水线运行时触发安装失败。⚠️ 避坑预警 [并发扇出引发的 Claude Token 峰值熔断]:当对大型电商站或超长文档运行全站级
/seo audit时,19 个 Sub-agent 同时扇出解析复杂的 HTML 树,会导致上下文窗口与 API Token 瞬时激增。生产环境建议优先使用针对性的子命令(如单个页面的/seo page或分流执行/seo schema与/seo geo),阻断无节制的 DOM 全量透传,防止单次审计产生预期外的 API 费用账单。
此外,针对大量依赖客户端即时 Hydration 的复杂 SPA,需确认 Playwright 默认的 Wait 条件。由于部分 Agent 会在 DOMContentLoaded 事件触发后立即抓取 DOM,这可能会漏掉延迟加载的 Schema 脚本注入,导致报告误报“缺少结构化数据”,务必配合配置显式等待选择器。